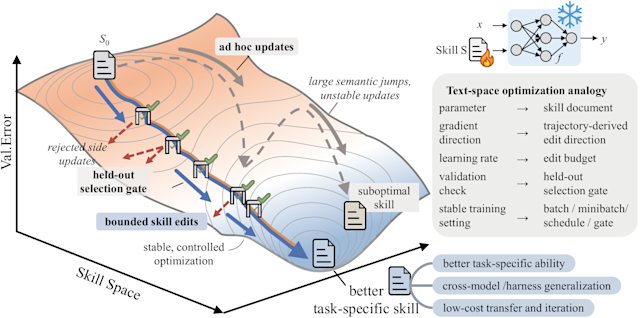
Навыки агентов (Agent skills) стали важной частью реальных приложений на базе искусственного интеллекта. Они представляют собой механизм — набор инструкций, обычно сохраняемых в папке с текстовыми файлами в формате Markdown…
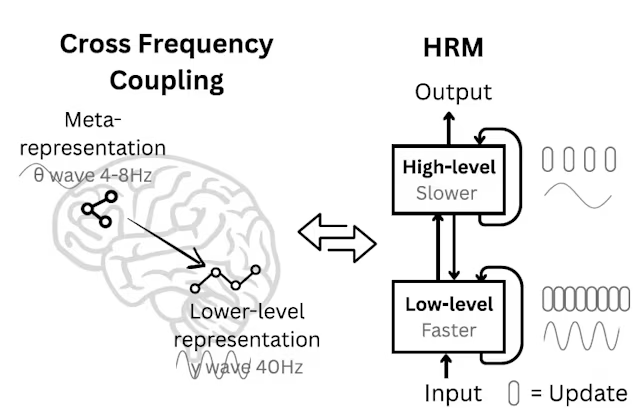
Обучение базовой большой языковой модели (LLM) с нуля стоит миллионы долларов и требует данных в масштабах интернета — именно поэтому большинство предприятий даже не пытаются этим заниматься. В компании Sapient…
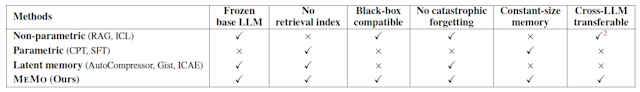
Обеспечение возможности для больших языковых моделей (LLM) усваивать новые знания после обучения остается серьезным препятствием для корпоративного ИИ: текущие решения либо слишком дороги, либо слишком медленны, либо ограничены размером контекстного…
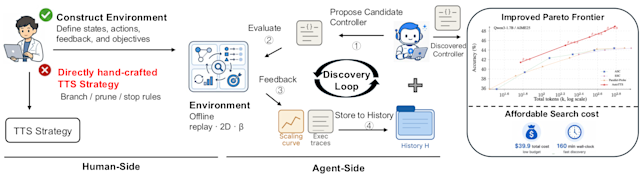
Масштабирование во время тестирования (test-time scaling, TTS) зарекомендовало себя как надежный метод повышения производительности больших языковых моделей в реальных сценариях за счет выделения им дополнительных вычислительных ресурсов на этапе инференса.…
Когда агентные рабочие процессы дают сбой, разработчики часто предполагают, что проблема заключается в способностях базовой модели к рассуждениям. На практике же основным ограничивающим фактором зачастую выступает ограниченный объем информации, предоставляемый…
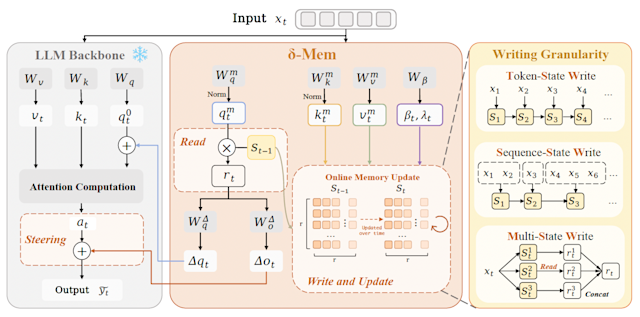
ИИ-агенты забывают. Каждый раз, когда ассистент программиста теряет нить отладки или агент по анализу данных заново обрабатывает уже пройденный контекст, команда расплачивается за это задержками, затратами на токены и хрупкостью…
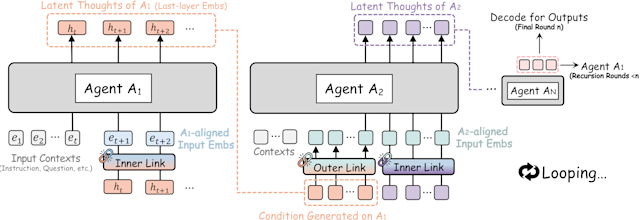
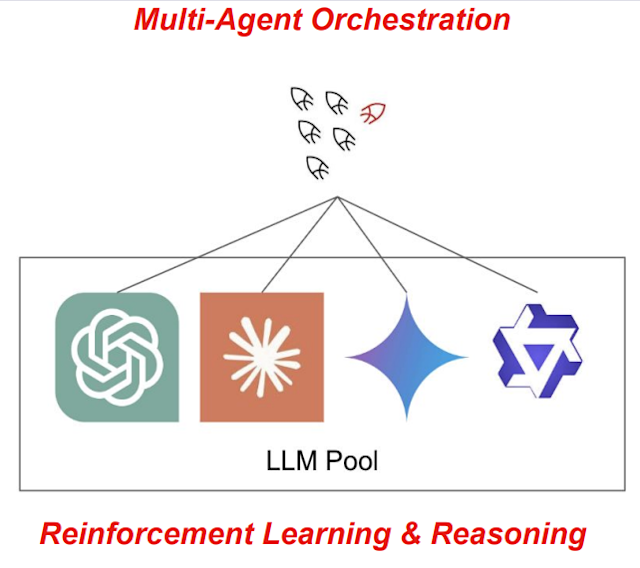
Одной из главных проблем современных многоагентных ИИ-систем является то, что они общаются путем генерации и обмена текстовыми последовательностями. Это приводит к задержкам, увеличивает затраты на токены и затрудняет обучение всей…
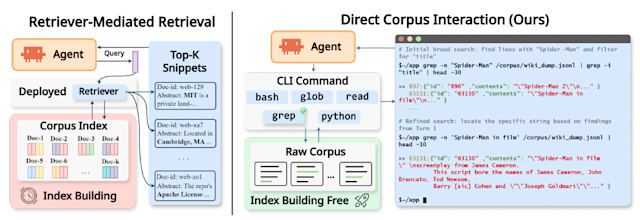
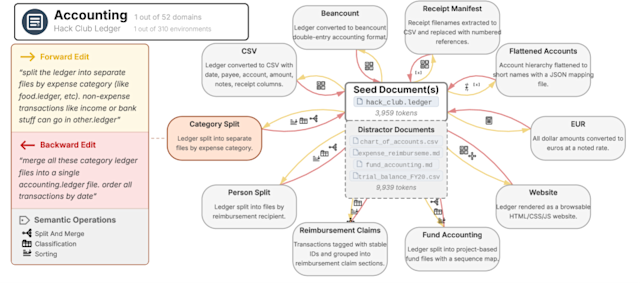
По мере того как большие языковые модели становятся все более способными, у пользователей возникает соблазн перекладывать на них задачи, связанные с обработкой знаний, когда модели работают с документами от имени…
Каждый жестко запрограммированный вашей командой конвейер LangChain начинает давать сбой в тот момент, когда распределение запросов меняется — а оно меняется всегда. Именно это узкое место и решила устранить компания…
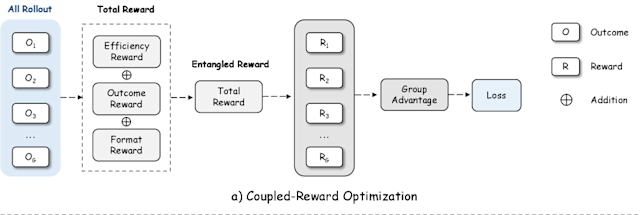
Одной из ключевых трудностей при создании эффективных ИИ-агентов является обучение их выбору между использованием внешних инструментов и опорой на собственные внутренние знания. Однако большие языковые модели часто настраивают на слепой…
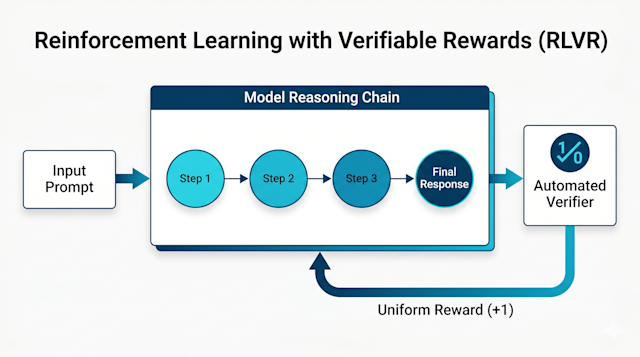
Обучение моделей рассуждения с помощью искусственного интеллекта требует ресурсов, которых нет у большинства корпоративных команд. Инженерным командам часто приходится выбирать между дистилляцией знаний из крупных дорогостоящих моделей или использованием методов…
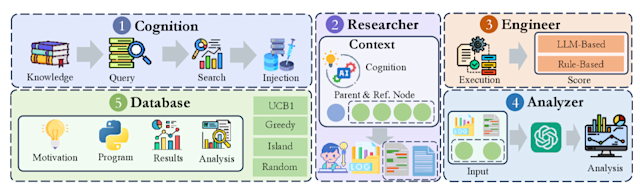
Исследования и разработки в области искусственного интеллекта строятся на цикле «гипотеза — эксперимент — анализ», и каждый этап требует значительных затрат ручного труда инженеров. Новый фреймворк, созданный исследователями из SII-GAIR,…
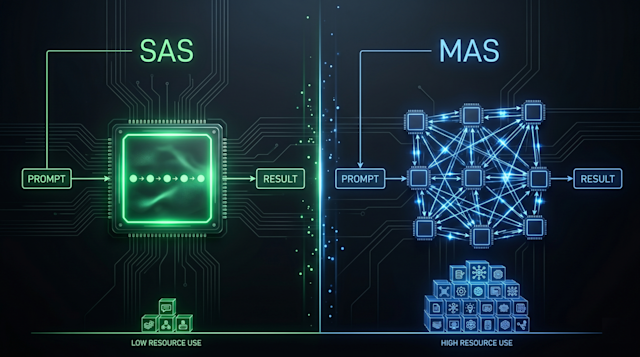
Корпоративные команды, создающие многоагентные системы искусственного интеллекта, возможно, переплачивают за вычислительные ресурсы ради преимуществ, которые не подтверждаются в условиях равных бюджетов. Новое исследование Стэнфордского университета показывает, что одноагентные системы не…
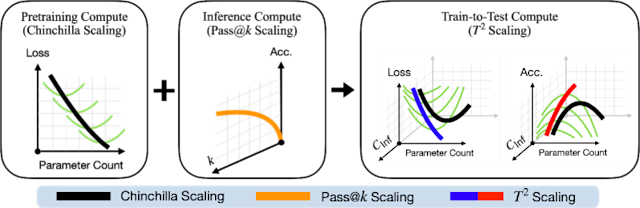
Стандартные рекомендации по созданию больших языковых моделей (LLM) оптимизируют исключительно затраты на обучение и игнорируют расходы на инференс. Это создает проблему для реальных приложений, которые используют методы масштабирования на этапе…
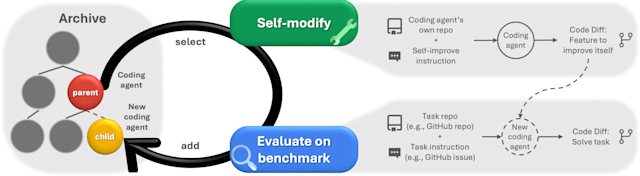
Создание самосовершенствующихся систем ИИ — это важный шаг на пути к внедрению агентов в динамичные среды, особенно в корпоративные производственные условия, где задачи не всегда предсказуемы или однородны. Существующие самосовершенствующиеся…