


Масштабирование от обучения к тестированию: как оптимизировать сквозной бюджет вычислительных ресурсов ИИ для инференса
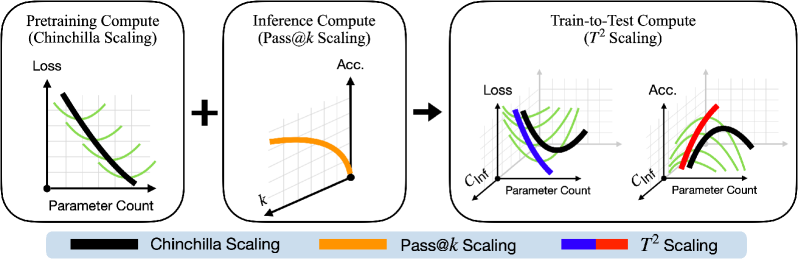


Стандартные рекомендации по созданию больших языковых моделей (LLM) оптимизируют исключительно затраты на обучение и игнорируют расходы на инференс. Это создает проблему для реальных приложений, которые используют методы масштабирования на этапе инференса для повышения точности ответов модели, например, генерацию нескольких вариантов рассуждений при развертывании.
Чтобы устранить этот разрыв, исследователи из Университета Висконсин-Мэдисон и Стэнфордского университета представили законы масштабирования Train-to-Test (T2) — подход, который совместно оптимизирует размер параметров модели, объем обучающих данных и количество примеров для инференса на этапе тестирования.
На практике их подход доказывает, что с точки зрения вычислительных затрат оптимально обучать значительно более мелкие модели на гораздо больших объемах данных, чем предписывают традиционные правила, а затем использовать сэкономленные вычислительные ресурсы для генерации множества повторяющихся выборок на этапе инференса.
Для разработчиков корпоративных ИИ-приложений, которые обучают собственные модели, это исследование предоставляет проверенный план максимального возврата инвестиций. Оно показывает, что рассуждения ИИ необязательно требуют огромных затрат на передовые модели. Вместо этого более мелкие модели могут демонстрировать более высокие результаты в сложных задачах, сохраняя при этом затраты на один запрос в пределах бюджетов реального развертывания.
Противоречащие друг другу законы масштабирования
Законы масштабирования — важная часть разработки больших языковых моделей. Законы предварительного масштабирования определяют лучший способ распределения вычислительных мощностей при создании модели, в то время как законы масштабирования на этапе тестирования подсказывают, как распределять вычисления во время развертывания, например, позволяя модели «думать дольше» или генерировать несколько вариантов рассуждений для решения сложных задач.
Проблема заключается в том, что эти законы масштабирования развивались совершенно независимо друг от друга, несмотря на их фундаментальную взаимосвязь.
Размер параметров модели и продолжительность обучения напрямую определяют как качество, так и стоимость одного запроса для ее инференс-выборок. В настоящее время золотым стандартом индустрии для предварительного обучения является правило Чинчиллы, которое предлагает оптимальное с точки зрения вычислений соотношение: примерно 20 токенов обучения на каждый параметр модели.
Тем не менее, создатели современных семейств ИИ-моделей, таких как Llama, Gemma и Qwen, регулярно нарушают это правило, намеренно переобучая свои более мелкие модели на огромных объемах данных.
Как рассказал VentureBeat Николас Робертс, ведущий автор научной работы, традиционный подход дает сбой при создании сложных агентских рабочих процессов: «На мой взгляд, стек инференса рушится, когда каждый отдельный вызов инференса обходится дорого. Это происходит, когда модели велики и вам нужно выполнять многократную выборку» Вместо того чтобы полагаться на массивные модели, разработчики могут использовать переобученные компактные модели для запуска такой многократной выборки за малую долю стоимости.
Но поскольку законы масштабирования при обучении и тестировании рассматриваются изолированно, не существует надежной основы для расчета того, насколько сильно модель должна быть переобучена в зависимости от того, сколько вариантов рассуждений ей потребуется сгенерировать во время развертывания.
Следовательно, ранее не существовало формулы, которая бы одновременно оптимизировала размер модели, объем обучающих данных и бюджеты на инференс во время тестирования.
Причина сложности формулирования этого подхода заключается в том, что предварительное обучение и масштабирование на этапе тестирования используют два разных математических языка. Во время предварительного обучения производительность модели измеряется с помощью «потерь» (loss) — плавной, непрерывной метрики, которая отслеживает ошибки предсказания по мере обучения модели.
На этапе тестирования разработчики используют реальные показатели для оценки способностей модели к рассуждению, такие как pass@k, которая измеряет вероятность того, что модель выдаст хотя бы один правильный ответ среди k независимых повторяющихся попыток.
Законы масштабирования от обучения к тестированию
Чтобы устранить разрыв между обучением и развертыванием, исследователи представляют законы масштабирования Train-to-Test (T2). На высоком уровне этот подход прогнозирует производительность рассуждений модели, рассматривая три переменные как единое уравнение: размер модели (N), объем обучающих токенов, на которых она учится (D), и количество вариантов рассуждений, генерируемых во время инференса (k).
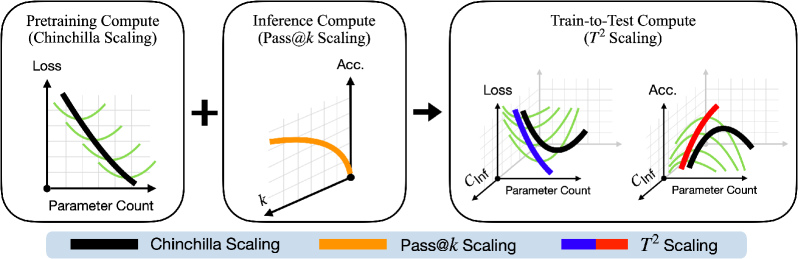
«Train-to-test» объединяет законы предварительного обучения и масштабирования на этапе тестирования в единую концепцию (источник: arXiv)
T2 объединяет бюджеты предварительного обучения и инференса в одну формулу оптимизации, которая учитывает как базовую стоимость обучения модели (6ND), так и совокупную стоимость ее многократных запросов при инференсе (2Nk). Исследователи опробовали различные подходы к моделированию: моделировать ли потери при предварительном обучении или производительность на этапе тестирования (pass@k) в качестве функций N, D и k.
Первый подход использует привычное математическое уравнение для масштабирования Чинчиллы (которое вычисляет ошибку предсказания модели, или потери) и напрямую модифицирует его, добавляя новую переменную, учитывающую количество повторяющихся выборок на этапе тестирования (k). Это позволяет разработчикам увидеть, как увеличение вычислительных ресурсов инференса снижает общий уровень ошибок модели.
Второй подход напрямую моделирует точность pass@k. Он сообщает разработчикам вероятность того, что их приложение решит задачу при определенном бюджете вычислений.
Но должны ли предприятия использовать этот подход для каждого приложения? Робертс уточняет, что этот подход весьма специфичен. «Я полагаю, что вы не увидите столь большого эффекта в приложениях с интенсивным использованием знаний, таких как чат-модели», — сказал он. Вместо этого «T2 адаптирован для приложений со сложными рассуждениями, таких как написание кода, где обычно многократная выборка используется в качестве метода масштабирования на этапе тестирования».
Что это значит для разработчиков
Для проверки законов масштабирования T2 исследователи создали обширный тестовый стенд из более чем 100 языковых моделей с количеством параметров от 5 миллионов до 901 миллиона. Они обучили с нуля 21 новую, сильно переобученную контрольную точку (чекпоинт), чтобы проверить, подтверждаются ли их математические прогнозы на практике. Затем они протестировали модели на восьми различных задачах, включая реальные наборы данных, такие как SciQ и OpenBookQA, а также синтетические задачи, предназначенные для проверки арифметики, пространственного мышления и извлечения знаний.
Обе их математические модели доказали, что оптимальная с точки зрения вычислений граница значительно смещается от стандартного масштабирования Чинчиллы. Чтобы максимизировать производительность в рамках фиксированного бюджета, оптимальным выбором является модель, которая существенно меньше и обучена на гораздо большем объеме данных, чем диктует традиционное правило 20 токенов на параметр.
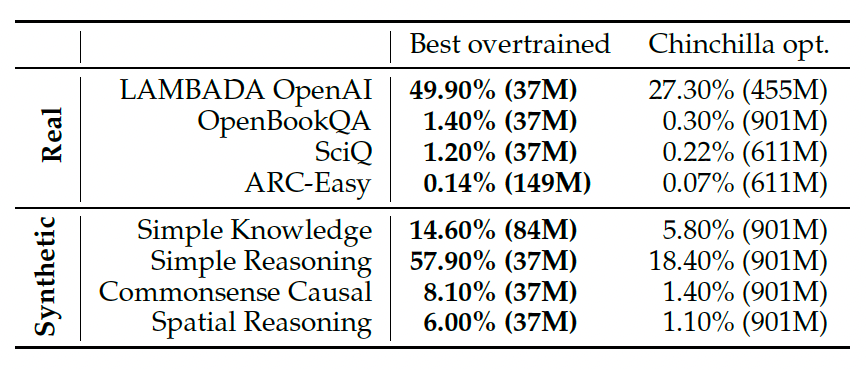
Законы масштабирования от обучения к тестированию показывают, что небольшие переобученные модели превосходят модели, оптимизированные по Чинчилле, в задачах на рассуждение (источник: arXiv)
В их экспериментах сильно переобученные небольшие модели стабильно превосходили более крупные модели, оптимальные по Чинчилле, во всех восьми задачах оценки с учетом затрат на выборку на этапе тестирования.
Для разработчиков, стремящихся внедрить эти результаты, технический барьер на удивление низок.
«Для масштабирования на этапе тестирования с нашими текущими моделями не требуется ничего особенного», — сказал Робертс. «При развертывании разработчики вполне могут интегрировать инфраструктуру, которая делает процесс выборки более эффективным (например, кэширование KV, если вы используете трансформер)».
Кэширование KV помогает, сохраняя ранее обработанный контекст, поэтому модели не нужно заново перечитывать исходный промпт для каждого нового образца рассуждений.
Однако экстремальное переобучение сопряжено с практичными компромиссами. Хотя переобученные модели могут быть заведомо упрямыми и их сложнее дообучать, Робертс отмечает, что при применении управляемого дообучения (supervised fine-tuning) «хотя этот эффект и присутствовал, он был недостаточно силен, чтобы вернуть оптимальную модель к уровню Чинчиллы». Вычислительно-оптимальная стратегия остается однозначно смещенной в сторону компактных моделей.
Тем не менее, команды, доводящие этот процесс до абсолютного предела, должны остерегаться достижения физических ограничений данных. «С другой стороны, если довести наши рекомендации по переобучению до крайности, у вас могут закончиться данные для обучения», — сказал Робертс, имея в виду надвигающуюся «стену данных», когда высококачественные данные из интернета будут исчерпаны.
Эти эксперименты подтверждают, что если приложение полагается на генерацию множества вариантов рассуждений на этапе тестирования, агрессивное переобучение компактной модели — это практический и математически наиболее эффективный способ потратить общий бюджет на вычисления.
Чтобы помочь разработчикам начать работу, исследовательская группа планирует в ближайшее время открыть исходный код своих контрольных точек и программного обеспечения, что позволит предприятиям подключать собственные данные и сразу тестировать поведение масштабирования. В конечном счете этот подход служит выравнивающей силой в индустрии ИИ.
Это особенно важно, поскольку высокая стоимость передовых моделей может стать препятствием при масштабировании агентских приложений, зависящих от моделей рассуждений.
«T2 кардинально меняет то, кто может создавать мощные модели рассуждений», — заключает Робертс. «Вам может не потребоваться огромный бюджет на вычисления для получения передовых способностей к рассуждению. Вместо этого вам нужны хорошие данные и грамотное распределение бюджета на обучение и инференс».




