GitHub Copilot Fusion комбинирует модели, чтобы приблизиться к уровню Opus 5.5 в программировании при вдвое меньшей стоимости одной задачи


Дочерняя компания Microsoft и популярный сервис хостинга репозиториев кода GitHub внедряет систему, которая решает, какие ИИ-модели должны выполнять ту или иную задачу разработки ПО, — и, согласно независимому тестированию, способна приблизиться к производительности ведущего агента для программирования примерно за половину стоимости.
На конференции GitHub Universe 28 октября компания представила новую систему GitHub Copilot Fusion, которая распределяет запросы между моделями и координирует их работу в рамках задачи.
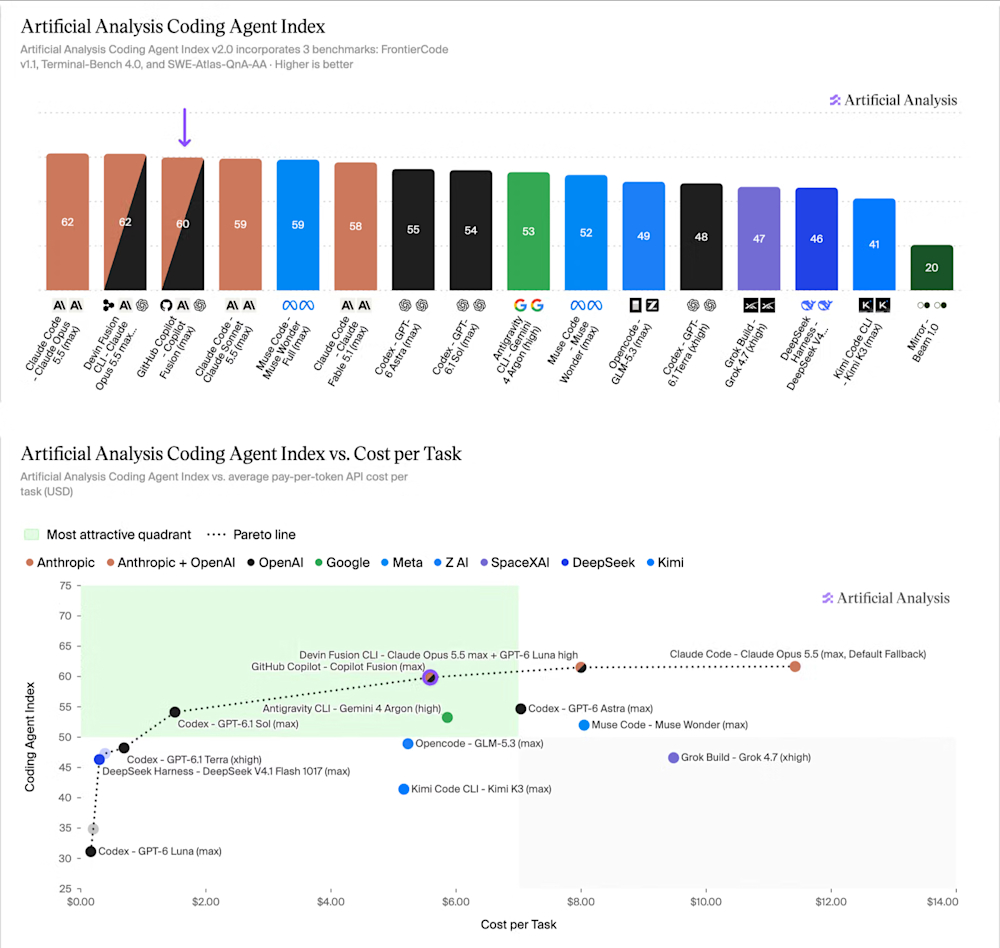
В тестировании, опубликованном 28 октября компанией Artificial Analysis, Fusion Max обходилась в среднем в 5,59 доллара за задачу против 11,42 доллара у Claude Code с моделью Claude Opus 5.5 от Anthropic в режиме Max — примерно на 51% дешевле, — при этом отставая всего на два пункта в индексе Coding Agent Index этой компании.
Результаты дают GitHub внешнее подтверждение её тезиса о том, что интеллектуальный выбор моделей может сделать дорогостоящую разработку с помощью ИИ более экономичной.
GitHub также утверждает, что Fusion Max выполнила эти тестовые задачи примерно на 40% быстрее, чем конфигурация Claude Code.
Генеральный директор Microsoft Сатья Наделла говорил о возможной экономии до 77%, однако эта более высокая цифра относится к отдельной оценке, проведённой самой компанией, а не к среднему значению, измеренному Artificial Analysis. В совокупности эти заявления ставят в центр предложения GitHub для команд разработчиков стоимость выполнения задачи, а не цену какой-либо одной базовой модели.
В интервью VentureBeat директор по продуктам GitHub Марио Родригес заявил, что Fusion призвана облегчить выбор моделей и одновременно улучшить экономику выполненной работы. Это различие важно для корпоративных клиентов, которые оценивают, приводит ли снижение затрат на ИИ-инференс к уменьшению общих инженерных усилий.
Fusion — это движок оркестрации, а не очередная ИИ-модель
Fusion оценивает работу, связанную с рассуждениями, генерацией кода, отладкой и использованием инструментов, а затем решает, отправить ли запрос одной модели или скоординировать несколько. Система объединяет возможности, разработанные в рамках более раннего исследовательского проекта GitHub Project HydraFusion, с функцией автоматического выбора модели.
«Это не модель. Это движок оркестрации, работающий в реальном времени», — сказал Родригес VentureBeat. По его словам, Fusion может как маршрутизировать отдельные запросы, так и оркестрировать несколько обращений к моделям ради выполнения задачи.
Родригес отметил, что GitHub также изменила то, как разработчики взаимодействуют с технологией. Вместо того чтобы рассматривать её как ещё одну модель в списке, GitHub теперь представляет её как выбираемый режим с разными уровнями усилий. «Вы просто включаете его, и у вас есть три уровня рассуждений: стандартный, высокий и максимальный», — сказал он.
-
Standard отдаёт приоритет универсальным моделям для повседневного программирования
-
High рассчитан на более сложную работу
-
Max предназначен для самых сложных задач.
Система использует три схемы выполнения:
-
Single отправляет работу напрямую одной модели
-
Cascade начинает с менее дорогой модели и проверяет, принять ли её результат или передать задачу более мощной
-
Critique: одна модель готовит черновик ответа, другая его проверяет, а исходная модель дорабатывает свой ответ. Эти различия описаны в документации GitHub к запуску.
«У нас есть режим Single, в котором мы сразу обращаемся к модели, которую считаем лучшей для задачи», — пояснил Родригес. Он также описал Critique как способ привлечь более мощный интеллект к процессу проверки вместо того, чтобы назначать самую дорогую модель на каждый этап. Цель, по его словам, — позволить людям сосредоточиться на том, чего они хотят добиться от своего ПО: «Им не нужно постоянно думать о модели».
Artificial Analysis выявила в пуле Fusion модели как Anthropic, так и OpenAI, включая Claude Opus 5.5, Claude Sonnet 5.5, GPT-6 Astra и GPT-6 Sol. Конкретные используемые модели могут различаться в зависимости от запроса и политик, установленных организацией.
Что показывают независимые бенчмарки — и чего они не показывают
Artificial Analysis протестировала режим Max системы Fusion через GitHub Copilot CLI на своём индексе Coding Agent Index v2.0, в котором три оценки программирования имеют равный вес.
Источник: Artificial Analysis
Fusion получила общий балл 60 против примерно 62 у Claude Code с Opus 5.5 Max. Конкурирующая система оркестрации Devin Fusion, использующая Opus 5.5 Max и GPT-6 Luna High, набрала 62 балла при средней стоимости задачи 8,00 доллара.
По стоимости средние 5,59 доллара у Fusion выгодно отличаются от 11,42 доллара у Claude Code с Opus 5.5 и 8,00 доллара у Devin Fusion. Artificial Analysis также зафиксировала 7,2 млн токенов на задачу у Fusion — примерно вдвое меньше, чем у конфигурации Claude Code с Opus 5.5, и примерно на 30% меньше, чем у Devin Fusion. Это говорит о том, что экономия достигается, по крайней мере частично, за счёт меньшего объёма работы моделей, а не только за счёт более дешёвых токенов.
Однако результаты по отдельным компонентам индекса оказались неравномерными. Среди рассмотренных в отчёте систем Fusion лидировала в Terminal-Bench 4.0 с результатом 71. В FrontierCode — оценке программирования, ориентированной на изменения в репозиториях, — она набрала 51, уступив Claude Code с Opus 5.5 (56) и Devin Fusion (54). В оценке ответов на вопросы по репозиториям SWE-Atlas-QnA-AA Fusion получила 57 баллов. Иными словами, близкий совокупный балл не означает, что Fusion побеждает в любых задачах программирования.
Это затраты в бенчмарках, а не опубликованная оценка того, сколько конкретное предприятие заплатит в рамках новой схемы закупки ИИ-кредитов GitHub. В статье Artificial Analysis также не приводятся данные о времени выполнения каждой задачи, на которых основано заявление GitHub о сокращении времени на 40%; это остаётся сравнением, предоставленным GitHub, хотя измерения производительности, расхода токенов и стоимости имеют независимое подтверждение.
Более крупную цифру в 77% следует рассматривать отдельно. Как сообщил Кен Йенг в The AI Economy, собственные тесты GitHub с бенчмарком DeepSWE и агентной оболочкой Copilot показали, что Fusion High и Max превосходят сопоставимые конфигурации передовых моделей до 8,7 пункта по выполнению задач, снижая расчётные затраты до 77%.
Это сравнение проводилось в других условиях тестирования и отражает максимальное заявленное снижение; его не следует смешивать с примерно 51-процентным средним преимуществом в стоимости перед Opus 5.5, выявленным Artificial Analysis. Исходные конфигурации DeepSWE и результаты по отдельным задачам отсутствовали в материалах, изученных при подготовке этой статьи.
Бизнес-аргументация GitHub опирается на важное различие: экономия денег при прогоне бенчмарка — не обязательно то же самое, что снижение общей стоимости выпуска ПО. Командам по-прежнему нужно учитывать проверку людьми, ошибки, повторные попытки, интеграцию и любую работу по безопасности, следующую за результатом агента. Джей Парикх, исполнительный вице-президент Microsoft по CoreAI, подчеркнул более широкую цель в анонсе GitHub на Universe: «Значение имеет выполненная работа, а не больше кода».
Оплата по моделям, временная скидка и новый корпоративный вариант
Copilot Fusion общедоступна во всех тарифах Copilot от GitHub в VS Code, приложении Copilot, Copilot CLI и IDE от JetBrains; поддержка других клиентов запланирована. По данным GitHub, пользователям выставляется счёт за каждую базовую модель, к которой обращается Fusion, по стандартному тарифу этой модели.
Компания также предлагает платным подписчикам Copilot временную скидку 30% на стоимость моделей при использовании Fusion. Это промоснижение не связано с экономией на стоимости задач, измеренной в бенчмарках.
Родригес объяснил экономичность Fusion выбором маршрутизации и оркестрации, а не тем, что GitHub субсидирует дорогие запросы. Его объяснение не раскрывает норму прибыли GitHub и не гарантирует, что любая рабочая нагрузка обойдётся дешевле, чем ручной выбор одной модели.
Кроме того, GitHub предоставляет подходящим клиентам GitHub Enterprise Cloud ещё один способ приобретения Copilot. Вместо покупки дополнительной подписки Copilot для каждого лицензированного пользователя Enterprise компании, работающие через команды по работе с клиентами GitHub или Microsoft, могут получить включённый доступ и оплачивать использование ИИ из корпоративного бюджета.
В опубликованных условиях указано, что такие пользователи не получают ежемесячный лимит ИИ-кредитов на рабочее место; тарифицируемое использование начинается с первого запроса.
Это различие не сугубо теоретическое. Автодополнение кода и подсказки следующих правок остаются доступными даже при исчерпании ИИ-бюджета, но для Copilot Chat, проверки кода и облачного Copilot требуется доступный бюджет.
Существующие подписки Copilot Business и Copilot Enterprise по-прежнему предлагаются, а самостоятельный доступ к новой схеме будет открываться поэтапно. GitHub также указывает Copilot Standalone по цене 10 долларов за пользователя в месяц для пользователей корпоративных аккаунтов без лицензии GitHub Enterprise.
Эти детали проясняют структуру доступа и оплаты, однако изученные материалы по-прежнему не содержат проработанного корпоративного примера, показывающего ежемесячный расход ИИ-кредитов типичной командой разработчиков в новой схеме. Покупателям придётся сопоставить своё фактическое использование и бюджетные лимиты с существующими условиями, основанными на рабочих местах.
Проекты, постоянные сессии и более широкая аудитория
GitHub выводит Copilot за рамки подсказок кода, превращая его в место, где разработчики могут планировать работу, делегировать задания и проверять результаты. Приложение Copilot поддерживает спецификации, обсуждения дизайна и анализ телеметрии наряду с программированием.
Copilot Projects позволяет пользователям управлять параллельными облачными сессиями агентов в нескольких репозиториях и отслеживать их в едином интерфейсе.
Непрерывность сессий позволяет разработчикам переключаться между приложением Copilot, веб-сайтом, командной строкой и VS Code, не теряя контекст одного и того же облачного агента.
Родригес подтвердил поддержку продолжения работы на разных устройствах, включая мобильные. Это может быть важно для команд, чьи агенты продолжают работать после того, как разработчик закрыл ноутбук или перешёл к другой части проекта.
Родригес также представил изменения как способ сделать разработку доступной для непрофессионалов, не ограничивая опытных инженеров. «Это для всех», — сказал он. По его словам, амбиция GitHub — снизить порог входа в создание ПО и одновременно дать квалифицированным разработчикам больше возможностей; он указал на сообщество платформы, насчитывающее более 225 млн разработчиков.
Он также рассказал об усилиях GitHub по сохранению полезной информации из сессий агентов и включению её в организационные знания о технических областях, рабочих процессах и практиках разработки.
GitHub также расширяет Copilot Automations: команды могут запускать агентные рабочие процессы вручную, по расписанию или по событиям, а затем проверять и одобрять улучшения, которые автоматизации предлагают на основе прошлых результатов. Требование одобрения сохраняет точку принятия решения человеком, когда рабочий процесс предлагает изменить собственные инструкции.
Корпоративный контроль моделей и качество кода
Динамическая маршрутизация моделей ставит вопрос управления: если система выбирает провайдеров автоматически, может ли предприятие контролировать, какие модели разрешены?
В примечаниях к выпуску Fusion GitHub говорится, что система соблюдает политики моделей предприятия и организации. Администраторы могут видеть набор моделей, доступных для Fusion, отключать отдельные модели специально для Fusion и настраивать уровень усилий по умолчанию. На вопрос, смогут ли организации получить информацию об используемых моделях, Родригес ответил утвердительно, хотя из интервью не стало ясно, насколько детальным будет аудит на уровне отдельных запросов.
Родригес также подчеркнул, что рост объёма разработки с помощью ИИ создаёт новые требования к безопасности и проверке. GitHub представила уровень Max для проверки кода Copilot, отдельный от Fusion Max, наряду с вариантами Lite и Balanced.
По словам компании, новый уровень показал наивысший показатель F1 по серьёзным проблемам в ReviewBench, хотя в анонсе на Universe не было подробной разбивки результатов. Родригес также рассказал о сканировании безопасности с помощью ИИ, предназначенном для выявления уязвимостей, которые может пропустить традиционный статический анализ.
Больше агентов — больше инфраструктуры
GitHub расширяет инфраструктуру, лежащую в основе этих продуктов. В своём анонсе на Universe компания сообщает, что в 2026 году добавила 160 петабайт высокоскоростного хранилища, 4 млн процессорных ядер и 50 терабит в секунду сетевой пропускной способности.
Компания также переходит на развёртывание Azure в нескольких регионах, которое планируется завершить в начале 2027 года, и перерабатывает архитектуру Git, чтобы отделить вычисления от хранения и снизить накладные расходы на координацию.
Родригес связал эту работу с ростом числа операций чтения и записи в репозиториях, вызванным агентами. По мере того как всё больше автоматизированных сессий загружают код, изменяют файлы и отправляют изменения, сама инфраструктура разработки ПО должна справляться с большим объёмом параллельной работы.
Для корпоративных покупателей привлекательность Fusion будет зависеть от того, приведут ли эти изменения к созданию более качественного принятого ПО при меньших общих затратах, а не просто к более дешёвому прогону бенчмарка. Теперь у GitHub есть независимые доказательства того, что её оркестрация моделей способна приблизиться к производительности ведущего агента для программирования примерно за половину измеренной стоимости задачи. Более сложным испытанием станет то, увидят ли инженерные команды такое же улучшение с учётом проверки, управления, надёжности и полной стоимости развёртывания изменений.