Исследование показало: обвязка агента для программирования может утроить затраты на него, не повысив точность


Обвязка вокруг модели ИИ для программирования — системный промпт, инструменты и правила управления контекстом — может втрое увеличить затраты на решение задач по программированию, не обеспечив измеримого повышения точности, говорится в новом исследовании. Поставщики ИИ регулярно заявляют о повышении точности благодаря обновлениям обвязки. Но действительно ли более сложная обвязка помогает агенту лучше решать задачи по программированию — вопрос менее очевидный.
Исследователи из Шаньдунского университета проверили это на практике. Они сравнили три производственные обвязки, зафиксировав базовые модели и протестировав их почти на 500 задачах по разработке ПО. На более крупной выборке задач показатели успешности самой сложной и самой минималистичной обвязок оказались статистически эквивалентны в пределах пяти процентных пунктов, хотя третья обвязка показала худший результат.
На 45 самых сложных задачах смена обвязки меняла набор решённых агентами задач примерно так же часто, как повторный запуск неизменённой конфигурации: в обоих случаях медианное значение составило 13% задач. При этом исследователи обнаружили, что стоимость решения одной задачи при использовании одной и той же модели различалась между обвязками в три раза.
Для технических руководителей и разработчиков в компаниях эти результаты служат предостережением: не стоит выбирать агентов для программирования по небольшим различиям в результатах одиночных запусков бенчмарков. Командам следует учитывать и успешность решения задач, и стоимость каждой задачи.
Почему бенчмарки обвязок могут вводить в заблуждение
В общедоступных рейтингах часто сравнивают агентов для программирования с разными обвязками, из-за чего сложно определить вклад самой обвязки. В некоторых исследованиях сообщается, что фиксация модели и замена обвязки могут привести к разнице в 23,8 балла по оценке задачи и в 27,4 процентного пункта по показателю Pass@1. В то же время Zhipu AI заявляет о преимуществе обвязки ZCode на 2,4 балла над Claude Code при использовании одной и той же модели.
В новом исследовании предупреждают, что эти цифры трудно интерпретировать по двум причинам. Во-первых, во многих опубликованных сравнениях каждую конфигурацию запускают лишь один раз, хотя повторные запуски тех же тестов в тех же условиях могут давать сильно различающиеся результаты. В отдельном исследовании, цитируемом в статье, выяснилось, что 10 повторных запусков одной и той же конфигурации на SWE-bench Verified дали разброс результатов от 2,2 до 6,0 процентного пункта. Если не повторить тестирование базовой конфигурации, команды не смогут понять, вызвана ли разница в результатах обвязкой или случайными колебаниями между запусками.
Во-вторых, сравниваемые обвязки часто находятся в неравных условиях. В одном из исследований, цитируемых в статье, одна и та же модель набрала 19,1% с минимальным адаптером для бенчмарка и 73,4% с полноценным адаптером.
На результаты могут влиять и условия тестирования. Проверяя ранние запуски с доступом к вебу, исследователи обнаружили, что в 312 из 439 испытаний DeepSeek и Qwen (71%) из GitHub была загружена первоначальная версия исправления, написанная человеком. Исследователи исключили эти запуски и отключили доступ к сети в итоговой оценке.
Очное сравнение производственных обвязок
Чтобы измерить вклад обвязки, исследователи протестировали три производственные обвязки: Claude Code, OpenCode и mini-SWE-agent — минималистичную обвязку с открытым исходным кодом, написанную примерно на 100 строках Python. Она предоставляет один инструмент bash и не выполняет уплотнение контекста.
Исследователи проверили пять моделей со всеми тремя обвязками: две локально запущенные модели с открытыми весами (Qwen3.6-35B-A3B и Qwen3.8-27B) и три модели, доступные через API (DeepSeek-V4-Flash, GLM-5.3-Flash и HY4-Preview). Кроме того, в Claude Code использовалась Claude Opus 5 — модель высшего класса для сравнения.
Агентов оценивали в изолированных контейнерах на 492 офлайн-задачах из SWE-bench Verified: 45 самых сложных задач, на выполнение которых у человека уходит от одного до более чем четырёх часов, и оставшиеся 447 задач. Все пять моделей проверили на подвыборке из 45 задач, но на большей выборке тестировали только две модели Qwen.
Более сложные обвязки не продемонстрировали стабильного преимущества в точности. На выборке из 447 задач результаты тяжеловесной Claude Code и минималистичной mini-SWE-agent различались не более чем на два процентных пункта; для обеих моделей Qwen результаты признали статистически эквивалентными в пределах пяти пунктов на обеих моделях Qwen. На 45 самых сложных задачах примерно каждая восьмая задача (13%) меняла результат с успешного на неуспешный или наоборот при смене обвязки. При повторном запуске той же обвязки медианная доля таких изменений была аналогичной. Даже при тестировании официальной обвязки DeepSeek для командной строки на собственной модели DeepSeek-V4-Flash доля успешных решений находилась в диапазоне показателей трёх других обвязок, а стоимость одного испытания оказалась самой высокой среди всех обвязок, проверенных на этой модели.
«Собственная обвязка поставщика на его собственной модели не даёт преимущества в результатах», — пишут исследователи.
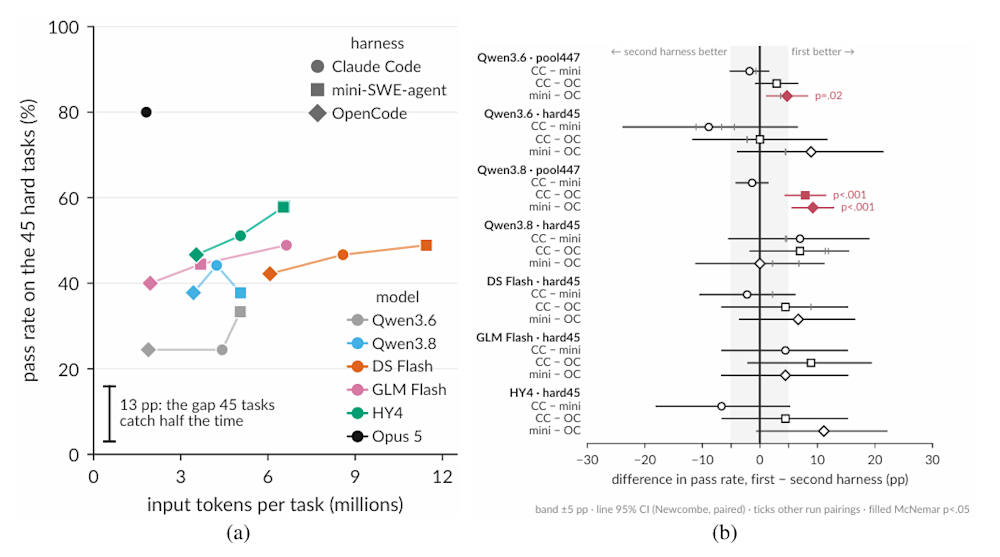
Как разные сочетания обвязок и моделей влияют на использование токенов, точность и смену результатов задач (источник: arXiv)
Единственный эффект обвязки, который превысил уровень статистического шума, оказался отрицательным. OpenCode отставала на срок до 9 пунктов на большой выборке задач. Для Qwen3.8-27B примерно половина этого отставания была связана с тем, что запуски прерывались при достижении моделью лимита вывода в 32 000 токенов посреди шага, часто ещё до того, как она успевала написать исправление кода. Claude Code достигала того же ограничения на той же модели, но автоматически предлагала модели продолжить.
Хотя более сложные обвязки не обеспечили стабильного прироста точности, выбор обвязки существенно влиял на стоимость инференса.
«При одной и той же модели, одних и тех же задачах и едином прейскуранте стоимость одной задачи в разных обвязках различается до трёх раз», — пишут исследователи.
При использовании GLM-5.3-Flash одно испытание в Claude Code обходилось почти вдвое дороже, чем в mini-SWE-agent, и более чем втрое дороже, чем в OpenCode. Однако OpenCode также прекращала работу после меньшего числа обращений к модели, что снижало её стоимость. Все три обвязки возвращали примерно одинаковый объём текста из вызовов инструментов. Разница возникала уже при первом обращении к API: обвязки передавали совершенно разный объём неизменяемого контекста в системных промптах и схемах инструментов: 16 581 токен в Claude Code, 7 025 в OpenCode и 829 в mini-SWE-agent. Поскольку агенты повторно отправляют расшифровку диалога при каждом обращении, эти первоначальные накладные расходы умножаются на число шагов, и исследователи предполагают, что Claude Code дополнительно увеличивает объём, повторно отправляя промежуточные блоки рассуждений модели.
«Разницу в объёме данных, передаваемых обвязками на каждом шаге, создаёт их собственный текст, а не репозиторий», — поясняют исследователи.
Хотя от 96% до 99% входных токенов в этих циклах попадали в кэш промптов провайдера, пересчёт стоимости токенов с учётом разных ставок за кэширование у поставщиков менял сумму счёта, но не влиял на то, какая обвязка была самой дорогой для той или иной модели.
Рейтинг затрат также меняется в зависимости от модели. На DeepSeek-V4-Flash mini-SWE-agent выполняла в среднем 141 обращение к модели за испытание против 104 у Claude Code и обходилась немного дороже — около 15,2 цента за испытание против 14,6 цента.
Подтверждение «налога на обвязку»
Эти результаты подтверждают выводы исследования HarnessTax, проведённого исследователями из лаборатории Sky Computing Lab при Калифорнийском университете в Беркли и проекта Arena. Команда из Беркли оценила семь моделей в Claude Code, Codex CLI от OpenAI и Pi — минималистичной обвязке с открытым исходным кодом, в которой всего четыре базовых инструмента. Они протестировали по 30 задач из каждого из двух бенчмарков, повторив каждую задачу трижды, и обнаружили, что выбор обвязки менял долю успешных решений всего на несколько процентных пунктов, но увеличивал стоимость инференса до пяти раз.
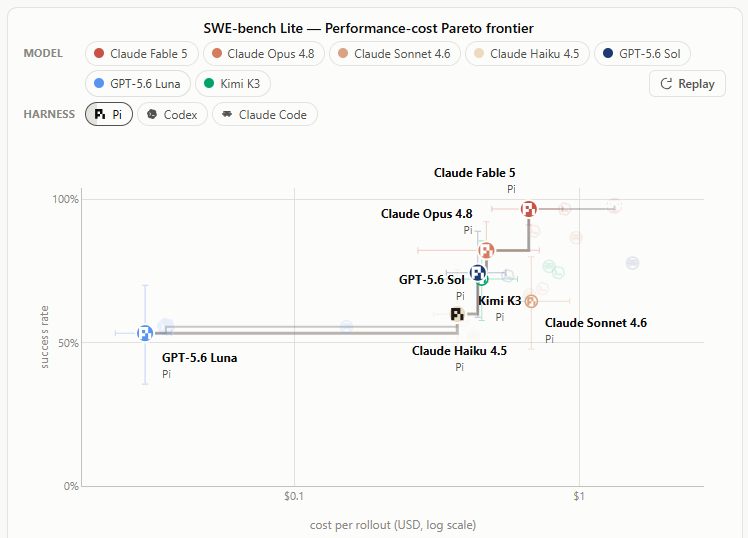
Налог на обвязку (источник: GitHub)
Исследователи из Беркли установили, что разница в стоимости может возникнуть уже при первом обращении к модели. Для всех семи моделей начальный контекст Claude Code в среднем более чем в 10 раз превышал контекст Pi — в основном из-за более длинных инструкций и схем инструментов.
Исследование HarnessTax, проведённое в Беркли, показало, что более сложные обвязки почти не повышали среднюю долю успешно решённых задач в проверенных бенчмарках. Новое исследование развивает этот вывод: в нём модели Qwen с 27 и 35 млрд параметров проверили на более крупной выборке задач, а различия между обвязками сопоставили с обычными колебаниями результатов при повторных запусках. Как отмечают исследователи из Шаньдунского университета, даже для Qwen3.6-35B-A3B, показавшей самый низкий результат среди проверенных моделей, «самая слабая модель не проявляет наибольшей чувствительности к обвязке».
Практические выводы для корпоративных разработчиков
Проблема затрат касается не только агентов для программирования. В сентябрьском опросе VB Pulse, проведённом VentureBeat Intelligence, 23 из 107 компаний, использовавших одну из указанных платформ оркестрации агентов (21%), не имели автоматизированного способа ограничить расходы на токены, генерируемые агентами.
Исследование даёт несколько практических рекомендаций для технических руководителей и разработчиков, создающих приложения на основе ИИ или распределяющих бюджеты на инструменты для программирования:
Оценивайте бенчмарки поставщиков с учётом статистического шума: поскольку примерно в одной из восьми задач результат может меняться между идентичными запусками, набор из 45 задач способен выявить разницу в 13 пунктов лишь в половине случаев, а даже выборка из 447 задач позволяет установить разницу всего в 5,2 пункта при наблюдавшемся исследователями разбросе результатов на уровне отдельных задач. Разработчикам следует считать неподтверждёнными заявления о преимуществе обвязки на 2–3 пункта, если они основаны на сравнении одиночных запусков, и, как рекомендуют исследователи, дважды запускать базовую конфигурацию, прежде чем переходить на более сложную систему.
Упростите начальные инструкции и схемы инструментов: Системный промпт и схемы инструментов отправляются на каждом шаге, хотя за кэшированные токены может взиматься плата по сниженной ставке. Когда исследователи отключили в Claude Code инструменты редактирования файлов, чтобы Claude Opus 5 пришлось изменять файлы через bash, её доля успешных решений осталась в пределах диапазона контрольных запусков. Командам стоит проверить, позволит ли использование компактных инструментов командной строки вместо десятков неизменяемых схем инструментов снизить затраты без ущерба для доли выполненных задач.
Настраивайте бюджеты на рассуждения с учётом сочетания модели и обвязки: Claude Opus 5, работавшая на годовалой версии Claude Code, где расширенное рассуждение было по умолчанию отключено, решила 34 из 45 задач против 35–36 у более новой версии, при этом её средняя расчётная стоимость API составила 44% от затрат на новую версию (73 цента против примерно 1,65 доллара за испытание). Однако команды не могут считать, что настройки бюджета на рассуждения можно менять без последствий. Например, отключение рассуждений для Qwen3.6 снизило долю успешных решений mini-SWE-agent на 11 пунктов, тогда как изменения в Claude Code и OpenCode укладывались в диапазон колебаний между запусками. Результаты показывают, что эффект от изменения бюджета на рассуждения зависит от сочетания модели и обвязки, а не только от модели. Ткомандам следует проверить именно свою конфигурацию, прежде чем менять параметры рассуждений ради снижения затрат.
«При сравнении поставщиков важно учитывать первоначальный вызов, прирост объёма на каждом шаге и количество шагов», — заключают исследователи.
Хотите повысить эффективность агентов, используя меньше токенов и контекста? Подайте заявку на участие в саммите VentureBeat Agentic Infrastructure Stack Summit, который пройдёт 28 октября в Сан-Франциско.