Исследователи улучшили ИИ-агентов, превратив научные статьи в работающий код — без необходимости переобучения


ИИ-агентам предоставляют возможность оптимизировать собственные компоненты — например, промпты, управление контекстом, рабочие процессы и код. Однако современные оптимизаторы саморазвивающихся агентских оболочек обычно опираются на уже имеющиеся знания базовых моделей или на траектории, исследованные агентом к настоящему моменту.
Новую платформу, разработанную исследователями из Калифорнийского университета в Санта-Барбаре и Microsoft, призвана устранить это узкое место. Платформа под названием ScholarEvolve автоматически извлекает новую информацию из научных статей и преобразует её в обновления кода агентской оболочки.
В ходе тестирования на контрольных наборах ScholarEvolve повысила долю выполненных задач у модели с открытыми весами Qwen3.5-27B с 69,0% до 81,4% в тестовом наборе AppWorld Normal, сократив примерно на 74% разрыв в производительности с GPT-5.4 — и всё это без обновления весов модели.
Для инженерных команд предприятий этот подход открывает возможность повысить эффективность агентов без переобучения базовых моделей и одновременно предлагает схему непрерывного обновления оболочек, адаптирующихся к незнакомым API.
Где современные оптимизаторы оболочек упираются в потолок
В течение последнего года платформы автоматической оптимизации оболочек в основном развивались по одному из двух направлений. Инструменты для отдельных компонентов, такие как WikiSkill от Google, SkillOpt от Microsoft и Memento-Skills, анализируют траектории агента, чтобы улучшить отдельный элемент стека — например, библиотеку навыков или хранилище памяти.
В то же время оптимизаторы всей оболочки, такие как DarwinX от Salesforce, HarnessX от Xiaomi, Self-Harness и Meta-Harness от Стэнфордского университета, используют метаагента-программиста, который изучает записи ошибок и переписывает инфраструктуру или правила работы агента.
Исследователи из Калифорнийского университета в Санта-Барбаре и Microsoft отмечают, что, несмотря на эффективность этих методов, опора исключительно на обратную связь по результатам выполнения создаёт замкнутый цикл, который быстро достигает точки убывающей отдачи.
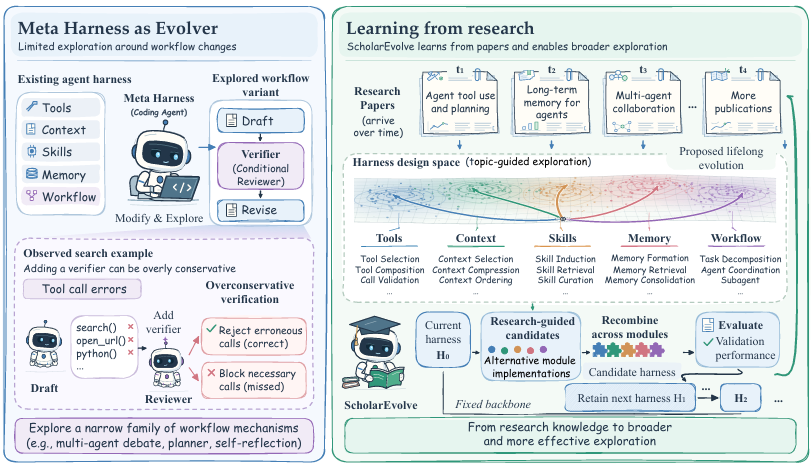
Эволюция метаоболочки и внешние исследования (источник: arXiv)
Во-первых, возможности метаагента ограничены параметрическими знаниями базовой модели. Как пишут исследователи, «механизмы, предлагаемые метаагентом, зависят от знаний и возможностей рассуждения его базовой модели. Запись ошибки может выявить недостающую способность, но почти не подсказать, какой метод поможет её развить».
Когда метаагент-программист видит в записи выполнения повторяющиеся ошибки при вызове инструментов, он часто прибегает к знакомым программным решениям — например, добавляет этап проверки или цикл обсуждения между несколькими агентами. В одном из примеров исследования метаагент заметил повторяющиеся ошибки при использовании инструментов поиска и Python и добавил модуль проверки, который должен был контролировать каждое действие. Проверяющий модуль выявлял некорректные вызовы, но оказался чрезмерно осторожным и блокировал допустимые вызовы API, необходимые для завершения задачи.
Ещё одна проблема заключается в том, что эволюция на основе записей ошибок носит реактивный характер. «Эволюция, основанная на траекториях и обратной связи, черпает данные из уже встречавшихся ситуаций, — пишут исследователи. — Поэтому при внедрении слабое место может повлиять на пользователей ещё до того, как накопится достаточно данных для полезного обновления».
Эти ограничения побудили команду задаться принципиальным вопросом: «Как опытный исследователь мог бы найти улучшения, которые ещё не проявились в собственном опыте агента?»
Архитектура ScholarEvolve
ScholarEvolve анализирует ошибки в обучающем наборе, ищет в научной литературе методы, которые могут помочь их устранить, реализует эти методы в модулях оболочки и проверяет, как они работают вместе.
Чтобы изменения кода в одной части агента не нарушали работу другой, ScholarEvolve делит оболочку агента на пять отдельных модулей со строгими интерфейсами ввода и вывода: интерфейс инструментов, управление контекстом, навыки, память и агентные рабочие процессы.
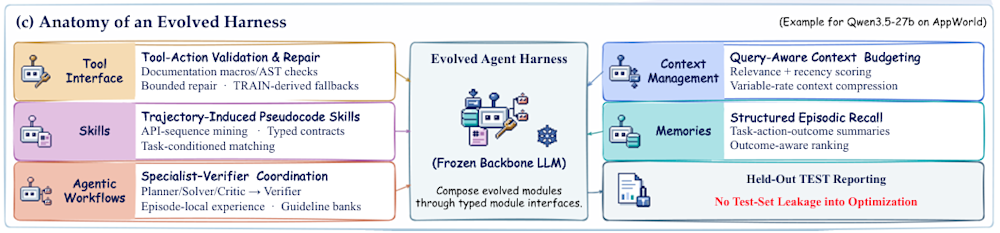
Усовершенствованные компоненты оболочки (источник: arXiv)
Процесс оптимизации проходит в четыре этапа:
-
Аудит ошибок и поиск научной литературы: Модель-аудитор изучает невыполненные задачи из обучающего набора и выявляет общие пробелы в способностях — например, потерю ранее полученных наблюдений или неспособность восстановиться после синтаксических ошибок. Затем она формирует поисковые запросы для поиска релевантных научных статей и аннотаций на arXiv.
-
Тематическое моделирование для разнообразного поиска: Чтобы не находить похожие статьи, ScholarEvolve использует метод тематического моделирования TopicGPT, группирующий статьи по семействам механизмов внутри каждого модуля. Затем система использует разные механизмы, чтобы агент-программист проверял различные инженерные идеи.
-
Планы реализации и проверки работоспособности: Для каждой выбранной статьи исследовательский агент изучает полный текст и имеющийся официальный код, чтобы подготовить план модификации. Агент-программист пишет реализацию на Python для конкретного модуля, оставляя остальные четыре модуля без изменений. Перед началом полной оценки автоматические проверки работоспособности убеждаются, что новый код корректно импортируется, соответствует контрактам интерфейсов и формирует допустимые действия.
-
Комбинирование и отбор модулей: После оценки отдельных обновлений модулей на проверочном наборе ScholarEvolve использует генетическое скрещивание, чтобы объединить лучшие модули в полноценные оболочки. Каждый объединённый вариант проходит совместное регрессионное тестирование на проверочных задачах, а статистическая проверка гарантирует, что текущая лучшая версия будет заменена только при подтверждённом улучшении.
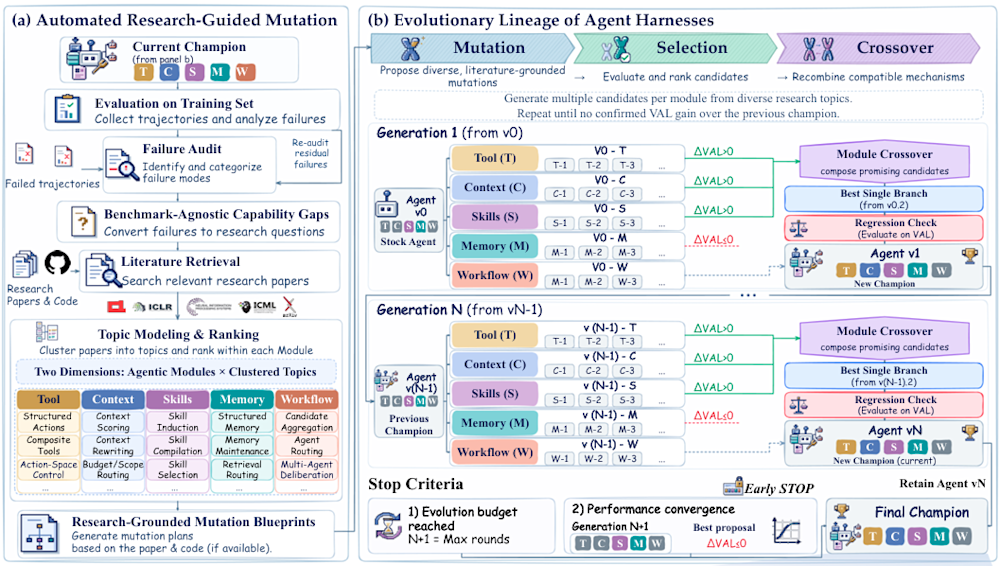
Процесс работы ScholarEvolve (источник: arXiv)
Например, при применении ScholarEvolve к Qwen3.5-27B в среде AppWorld система добилась трёх заметных улучшений:
Устранение некорректных вызовов API (интерфейс инструментов): Базовый агент часто генерировал синтаксически некорректный код Python или угадывал параметры API, не проверяя документацию. ScholarEvolve реализовала механизм из статьи ToolACE-R: он добавил проверку абстрактного синтаксического дерева для валидации вызовов Python до выполнения, а также макрос, который генерирует код Python для вывода документации API прямо во время работы.
Сохранение ранее полученных наблюдений (управление контекстом): Из-за длинной истории взаимодействий агент превышал лимит контекста или терял из виду ранее полученные данные. Опираясь на статью об ограничениях сжатия промптов, платформа создала модуль распределения контекстного бюджета с учётом запроса: он оставляет системные правила без изменений, оценивает историю диалога по релевантности задаче и давности, соответствующим образом распределяет лимит символов и сохраняет хронологический порядок.
Отказ от повторного изобретения последовательностей вызовов API (навыки): Вместо того чтобы каждый раз заново поручать агенту искать многоэтапные вызовы API, ScholarEvolve применила подход из статьи Skill-as-Pseudocode. Система извлекла повторяющиеся последовательности вызовов API из успешных обучающих запусков и преобразовала их в типизированные шаблоны псевдокода.
ScholarEvolve в действии
Исследователи оценили ScholarEvolve на двух интерактивных тестовых наборах, моделирующих некоторые аспекты корпоративных рабочих процессов: AppWorld, где агенты пишут код и вызывают API в нескольких приложениях, и tau-Bench Telecom, где агенты вместе с симулируемым пользователем решают проблемы с обслуживанием клиентов, мобильным интернетом и обменом сообщениями. Они усовершенствовали базовую оболочку для Qwen3.5-27B и GPT-5.4-mini и сравнили их с начальными оболочками, Meta-Harness от Стэнфордского университета и рядом передовых моделей.
По всем проверенным метрикам ScholarEvolve улучшила показатели обеих базовых моделей. В AppWorld доля выполнения целей задач (TGC) у усовершенствованной оболочки Qwen3.5-27B выросла на 12,4 процентного пункта, а доля выполнения целей сценариев (SGC) — на 20,2 пункта. Для достижения цели сценария требуется успешно пройти три варианта одного и того же сценария. В Telecom показатель GPT-5.4-mini вырос с 72,7% до 81,9%.
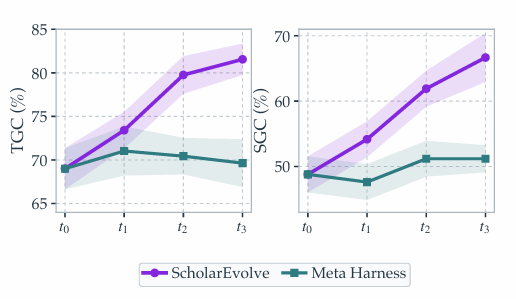
ScholarEvolve и Meta-Harness (источник: arXiv)
«Таким образом, конструкция оболочки существенно влияет на возможности, которые предоставляет та или иная базовая модель», — пишут исследователи.
Для разработчиков корпоративных решений в результатах экспериментов особенно выделяются несколько подробных выводов:
Обобщение без дополнительного обучения на незнакомые приложения и сложные API: В испытании AppWorld Challenge агенты работают с API Amazon и Gmail, которые не встречаются в наборах для эволюции или проверки. Благодаря усовершенствованной оболочке показатель Qwen3.5-27B вырос с 49,6% до 63,6% (+14,0 пункта), что на 9,0 пункта выше результата Meta-Harness.
Почему оптимизация отдельного модуля в отрыве от остальных вводит команды в заблуждение: В абляционном исследовании на задачах разработки самостоятельное обновление навыков для Qwen3.5-27B показало результат 75,4%, тогда как модуль Skill-as-Pseudocode набрал меньше — 73,7%. Однако в сочетании с усовершенствованными модулями интерфейса инструментов, контекста, памяти и рабочих процессов модуль навыков с результатом 73,7% обеспечил значительно более эффективную систему: доля выполненных задач составила 84,8% против 80,7%. «Поэтому результаты отдельных модулей не позволяют определить оптимальную комбинацию», — пишут авторы.
Восстановление после ошибок в ходе выполнения задачи: В реальных условиях вызовы инструментов неизбежно завершаются ошибками. Надёжные агенты отличаются от хрупких тем, как они реагируют на трассировки ошибок. В AppWorld Challenge среди запусков, в которых возникала промежуточная ошибка выполнения Python, усовершенствованная оболочка Qwen3.5-27B завершила задачу в 59,9% случаев против 44,9% у базовой оболочки. «Эти статистические данные по траекториям показывают, почему промежуточная ошибка инструмента не даёт полной картины возможностей агента: для выполнения многих задач необходимо использовать возвращённую ошибку, чтобы скорректировать последующие действия», — пишут исследователи.
Что следует учесть корпоративным командам при внедрении
Исследователи ссылаются на репозиторий GitHub, однако на момент публикации он был пуст. В приложениях к статье приведены фрагменты кода пяти выбранных модулей оболочки. Поскольку веса базовой модели остаются замороженными на протяжении всего процесса, инженерным командам не нужно управлять собственными контрольными точками модели.
Если вы хотите применить эти выводы, обратите внимание: ScholarEvolve находит статьи и доступный официальный код, связанный с исследованиями, а автоматические проверки работоспособности тестируют возможность импорта Python-кода, совместимость интерфейсов, создание артефактов и корректное форматирование действий. В статье не описаны проверки безопасности, которые позволили бы выявить вредоносные зависимости, небезопасные шаблоны выполнения или уязвимости к внедрению промптов в найденных статьях и стороннем коде.
Корпоративным командам не следует позволять метаагенту внедрять в производственную среду непроверенные изменения кода, основанные на научных исследованиях. Вместо этого стоит создать шлюз проверки безопасности или направить платформу на курируемый внутренний репозиторий проверенных статей и инженерной документации.
Также следует учитывать, что эволюция оболочки не способна устранить все проблемы в конвейере агента. Она может помочь улучшить форматирование вывода, управление контекстным бюджетом и восстановление после ошибок API, но не заменит детерминированные защитные ограничения на шлюзе API и не исправит слабые конвейеры извлечения данных на предыдущих этапах.
Исследователи также протестировали три последовательных раунда обновления на основе научной литературы, не меняя веса модели Qwen и ранее собранные данные о задачах. На каждом из трёх раундов результаты в AppWorld Normal улучшались, однако эксперимент не проверял непрерывную адаптацию в производственной среде.
«Эволюция на основе научной литературы естественным образом поддерживает проактивную адаптацию: новые публикации дают потенциальные улучшения ещё до того, как в работе агента проявятся соответствующие ошибки, — пишут исследователи. — Например, работающий агент мог бы ежемесячно изучать последние исследования и проверять перспективные обновления на валидационных задачах».