Инструмент с открытым исходным кодом SkillOpt от Microsoft автоматически повышает квалификацию ИИ-агентов без изменения весов моделей
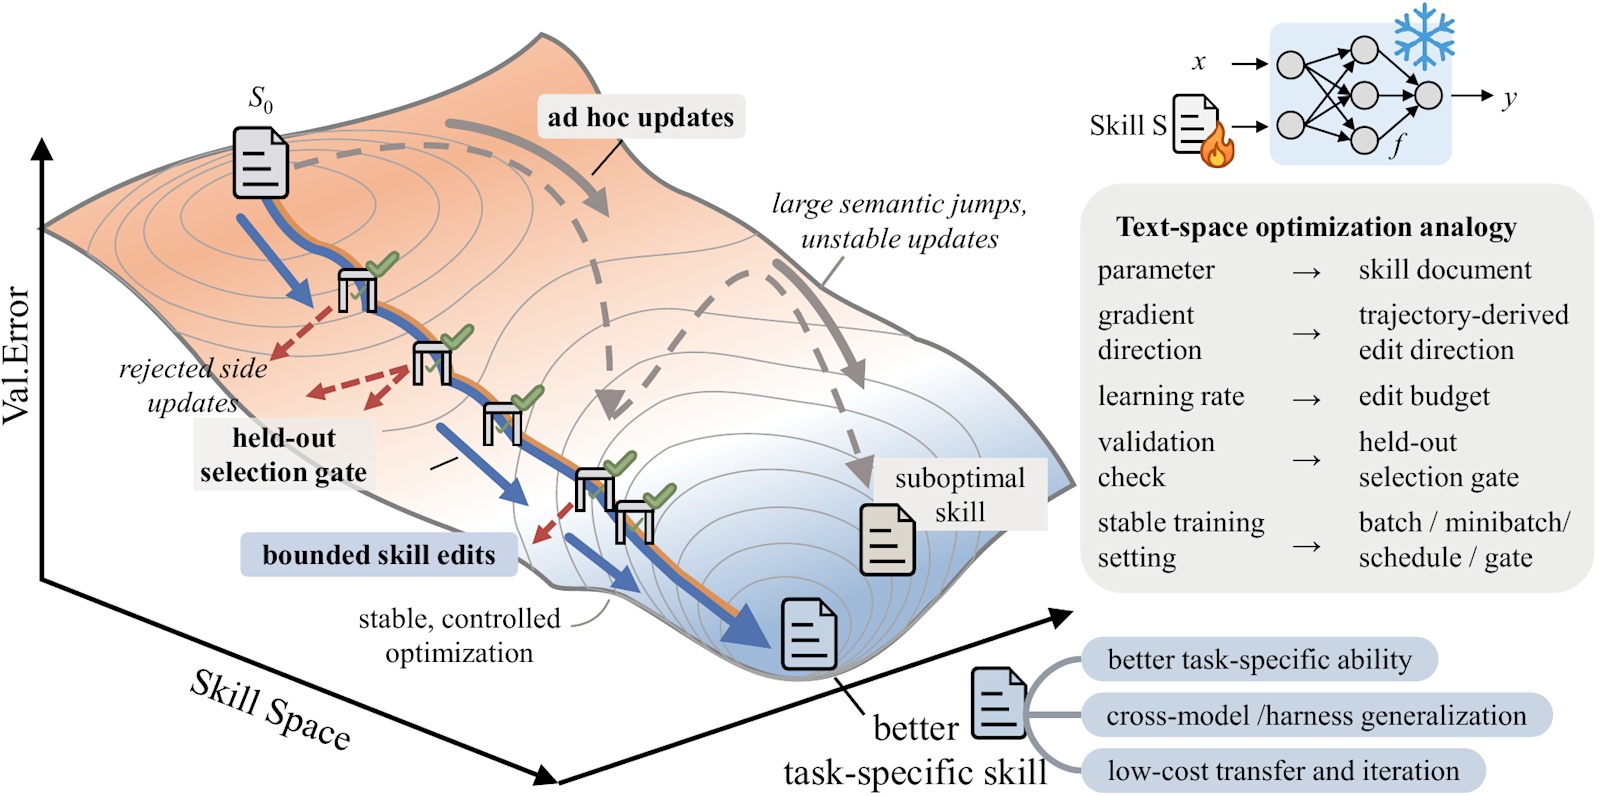


Навыки агентов (Agent skills) стали важной частью реальных приложений на базе искусственного интеллекта. Они представляют собой механизм — набор инструкций, обычно сохраняемых в папке с текстовыми файлами в формате Markdown (.md), — который позволяет моделям адаптироваться к конкретным корпоративным сценариям использования и сложным рабочим процессам.
Однако оптимизация этих навыков — процесс медленный и несовершенный, поскольку их нельзя обучать так же, как параметры базовой модели ИИ. Вместо этого пользователям обычно приходится обновлять их вручную, заново вводя инструкции в каждый файл и играя в «угадайку» относительно того, какие изменения могут улучшить производительность агентного ИИ и снизить количество ошибок.
SkillOpt, новый проект с открытым исходным кодом (под лицензией MIT), разработанный Microsoft, предлагает более совершенный подход: он представляет оптимизатор, созданный специально для навыков агентов. Этот инструмент превращает документ с навыками агента (.md) в обучаемый объект, который развивается на основе обратной связи о производительности.
Он использует оптимизацию в стиле глубокого обучения, позволяя ИИ систематически исследовать модификации документа и находить наилучшую комбинацию инструкций. Что еще более важно, фреймворк осуществляет эту процедурную адаптацию без изменения весов базовой модели.
На различных отраслевых бенчмарках SkillOpt превосходит существующие базовые подходы, существенно повышая точность таких моделей, как GPT-5.5 и Qwen. В результате получается набор компактных, переносимых артефактов навыков, которые позволяют агентам ИИ легко адаптироваться к новым доменам.
Проблема оптимизации навыков агентов
Навыки агентов упаковывают процедурные знания в спецификации на естественном языке, включая доменные эвристики, правила использования инструментов, ограничения вывода и известные типы сбоев. Эти навыки предоставляют внешний интерфейс для адаптации агентов к сложным корпоративным рабочим процессам. На практике навыки агентов хранятся в виде текстовых документов и перед выполнением внедряются в контекст агента.
Одно из ключевых преимуществ навыков заключается в том, что они настраивают поведение базовой модели без изменения ее весов. Тем не менее, сам документ с навыками необходимо дорабатывать и оптимизировать для достижения наилучшей производительности агента.
В то время как глубокое обучение опирается на строгий математический контроль для обеспечения стабильности, ручная разработка промптов (prompt engineering) часто полагается на метод проб и ошибок. При попытке автоматически обновить документ навыка на основе обратной связи отсутствие математической дисциплины делает текст крайне нестабильным.
Ифань Ян (Yifan Yang), старший научный сотрудник-разработчик в Microsoft Research Asia, рассказал VentureBeat, что проблема заключается не в самом внесении изменений, а в том, чтобы гарантировать их математическую обоснованность.
«Точка излома заключается не в том, может ли команда изменить навык, а в том, что они не могут гарантировать, что это изменение является улучшением», — отметил Ян. — Постоянно повторяются три типа сбоев: отсутствие контроля размера шага, из-за чего навыки «плывут»; отсутствие валидации, из-за чего исправление, выглядящее разумным, записывается в файл и может незаметно ухудшить производительность; и отсутствие негативной памяти, из-за чего одна и та же неудачная правка возвращается снова и снова».
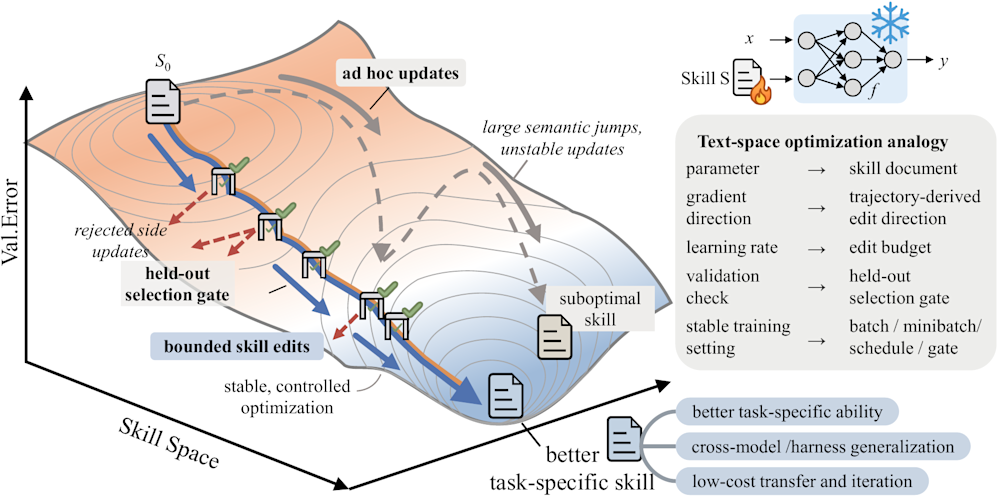
SkillOpt (источник: arXiv)
Иллюстрируя то, насколько легко может упасть производительность, если правки не проходят математическую проверку, Ян отметил, что «неконтролируемая перезапись опустила показатели GPT-5.5 на бенчмарке SpreadsheetBench с 41.8 до 41.1».
По словам Яна, эти типы сбоев усиливаются в многоэтапных рабочих процессах, «поскольку именно в них передовые модели проявляют наибольшую слабость при работе в режиме zero-shot (без предварительного обучения на примерах). Не в рассуждениях, а в процедурной дисциплине: формате, самопроверке, политике использования инструментов».
До появления SkillOpt навыки агентов в основном создавались вручную, генерировались за один проход или развивались с помощью слабо контролируемых конвейеров саморевизии, которые не могли надежно улучшаться под воздействием обратной связи.
Методы оптимизации промптов, такие как TextGrad и GEPA, рассматривают языковые артефакты как оптимизируемые объекты и используют обратную связь по траектории для эволюции промптов, однако они сосредоточены на конфигурациях с единичными промптами, а не на генерации постоянных, многоразовых артефактов навыков.
Между тем, методы эволюции и обнаружения навыков, такие как EvoSkill и Trace2Skill, преобразуют опыт выполнения задач агентом в уроки траектории для доработки папок с навыками, создания специализированных библиотек или выполнения эволюционного поиска.
Ни один из них не применяет элементы управления в стиле глубокого обучения, такие как скорость обучения (learning rates), валидационные барьеры и импульс (momentum), которые необходимы для непрерывного обучения единого компактного документа навыков.
Внедрение математической дисциплины в текст
SkillOpt оптимизирует текстовый документ с помощью итеративного цикла «предложение-проверка», который отделяет модель, выполняющую задачи, от модели, оптимизирующей навык. Процесс разворачивается в несколько этапов:
-
SkillOpt начинает с исходного документа навыка и замороженной целевой модели (или обертки/harness), где целевая модель запускает пакет задач для генерации траекторий выполнения, которые служат доказательством для текущего шага.
-
Офлайн-модель оптимизатора анализирует эти траектории, разделяя успешные результаты и сбои на мини-батчи (minibatches). Изучение мини-батча помогает модели выявлять систематические процедурные ошибки, а не случайные аномалии. На основе этих паттернов оптимизатор предлагает структурные правки в документ навыка: добавление, удаление или замену.
-
Предложенные правки проверяются на предмет дубликатов или противоречий, после чего оптимизатор ранжирует эти кандидаты на правки по их ожидаемой полезности.
-
Вместо применения всех предложенных изменений SkillOpt ограничивает список максимальным бюджетом правок для данного шага, формируя навык-кандидат.
-
Навык-кандидат оценивается на отложенном (held-out) валидационном наборе с использованием целевой модели. Если кандидат улучшает валидационный балл, он принимается и становится новым текущим навыком. Если он терпит неудачу, правки отклоняются и отправляются в буфер отклоненных правок, обеспечивая отрицательную обратную связь, чтобы оптимизатор знал, что не стоит повторять эту ошибку.
SkillOpt напрямую решает проблему восприятия текста как обучаемого объекта путем переноса математических концепций из глубокого обучения. Создатели отмечают, что «аналогия с глубоким обучением носит операционный, а не декоративный характер», помогая фреймворку избежать проблем с нестабильностью, присущих другим методам оптимизации.
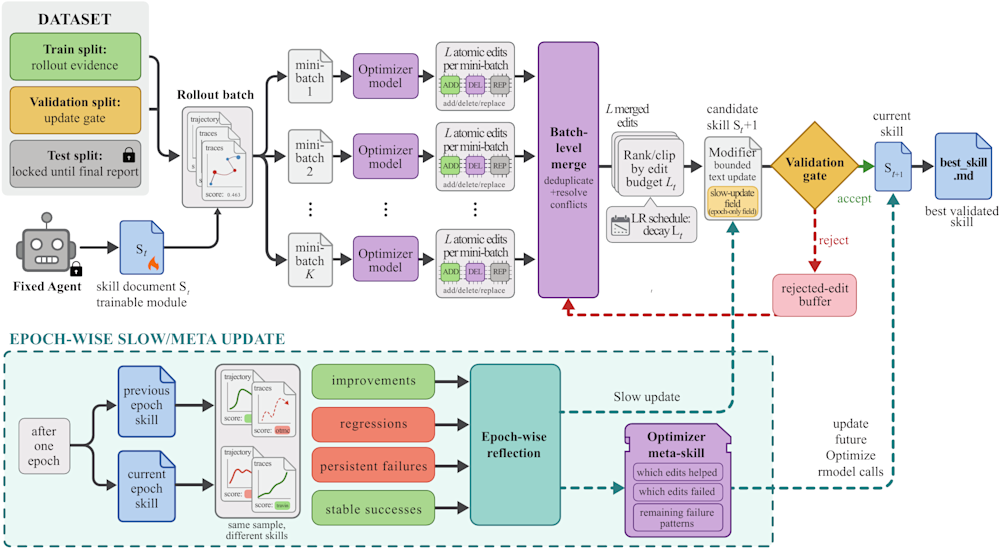
Фреймворк SkillOpt (источник: arXiv)
Бюджет правок действует как скорость обучения. Ограничивая количество правок, которые могут быть применены одновременно, система предотвращает слишком сильное отклонение версии навыка от ее предыдущего состояния, сохраняя преемственность и позволяя при этом осваивать новые процедуры.
Подобно проверке потерь на валидации (validation loss) в глубоком обучении, строгие отложенные примеры гарантируют, что правки текста, звучащие правдоподобно, сохраняются только в том случае, если они математически улучшают реальную производительность агента на валидационной выборке.
В конце эпохи SkillOpt выполняет медленное обновление, сравнивая задачи под управлением навыков предыдущей и текущей эпох. Это работает как член импульса (momentum term), перенося прочные долгосрочные процедурные уроки в будущее и изолируя их от быстрых правок на уровне шагов.
SkillOpt в действии
Для оценки метода на практике исследователи протестировали SkillOpt на различных моделях — от крупномасштабных фронтирных моделей, таких как GPT-5.5, до более компактных закрытых и открытых моделей, включая GPT-5.4-mini и Qwen3.5-4B. Они также развернули навыки в различных средах выполнения, используя как простой чат, так и сложные среды для написания кода, такие как Codex CLI и Claude Code.
Оценка охватила разнообразные отраслевые бенчмарки, включая вопросы-ответы в один раунд, многораундовую генерацию кода с использованием инструментов и мультимодальные рассуждения по документам. SkillOpt сопоставлялся с несколькими базовыми подходами: от стандартной настройки без навыков до навыков, написанных людьми, и однократных (one-shot) навыков, сгенерированных LLM. Его также сравнили с передовыми методами оптимизации промптов и эволюции навыков, а именно Trace2Skill, TextGrad, GEPA и EvoSkill.
SkillOpt доминировал по всем направлениям, доказав свою высокую эффективность на всех 52 протестированных комбинациях модели, бенчмарка и среды выполнения. Он оказался особенно эффективен с фронтирными моделями, обеспечив среднее абсолютное улучшение на +23.5 пункта по сравнению с базовым уровнем без навыков на модели GPT-5.5. Кроме того, SkillOpt превзошел гипотетический эталонный оракул (oracle baseline), который выбирает лучший конкурирующий метод для каждой конкретной проблемы.
Малые целевые модели показали огромный относительный прирост, доказав, что компактный текстовый файл способен предоставить процедурные знания, которых малым моделям не хватает в их весах. Например, модель GPT-5.4-nano почти удвоила свой результат на мультимодальных бенчмарках по ответам на вопросы по документам и утроила его на задачах воплощенного взаимодействия (embodied interaction) и последовательного принятия решений.
Эти академические бенчмарки соответствуют критическим проблемам предприятий. Модели zero-shot часто галлюцинируют в форматировании или не могут должным образом использовать инструменты в многоэтапных сценариях. Ян пояснил, что наибольший скачок производительности произошел в тех операциях, которые предприятия исторически с трудом поддавали надежной автоматизации.
«Извлечение данных из документов… точные показатели из контрактов, счетов и форм — автоматизация кредиторской задолженности, претензии, комплаенс, — говорит Ян. — Что улучшается, так это надежность: точное форматирование, самопроверка, аудируемые результаты. И этот прирост достигается за счет изучения процедур, а не заучивания ответов наизусть».
Для корпоративных практикующих специалистов истинная ценность SkillOpt заключается в его переносимости, эффективности и совместимости с существующей инфраструктурой. Эксперименты подтверждают, что фреймворк не зависит от конкретной среды выполнения (harness-agnostic). В дополнение к базовому чату, тот же цикл оптимизации был успешно интегрирован в среды выполнения с поддержкой инструментов, такие как Codex CLI и Claude Code, показав значительный прирост на отраслевых бенчмарках.
Разработчики могут обучать навык в одном цикле выполнения и развертывать в другом. Например, навык работы с электронными таблицами, обученный полностью внутри цикла Codex, был напрямую перенесен в Claude Code и обеспечил прирост на +59.7 пункта по сравнению с нативным базовым уровнем Claude Code без каких-либо дополнительных изменений.
Артефакты SkillOpt также чисто переносятся между моделями разного масштаба. Навык, оптимизированный для GPT-5.4, был развернут на меньших моделях GPT-5.4-mini и GPT-5.4-nano с положительным приростом, доказав, что изученные процедуры кодируют многоразовые рабочие процессы, а не просто эксплуатируют особенности архитектуры конкретной модели.
Наконец, фреймворк весьма эффективен с точки зрения использования токенов и пространства контекстного окна. Во всех бенчмарках конечные развернутые навыки никогда не превышали 2000 токенов при медианной длине около 920 токенов. Это приводит к созданию легко читаемых, проверяемых артефактов, которые специалист может просмотреть и отрегулировать за считанные минуты.
Стратегии внедрения и корпоративный «подводный камень»
Для корпоративных технологических лидеров внедрение нового фреймворка требует понимания накладных расходов и ограничений. Хотя в исследовательской работе отмечается, что количество токенов для обучения может достигать 210 миллионов для академических бенчмарков, реальность для повседневных корпоративных задач гораздо проще. Большое количество токенов при тестировании было в основном связано с повторной оценкой массивных отложенных тестовых наборов.
«Основная предварительная работа заключается в создании верификатора и репрезентативной отложенной выборки. Сам оптимизатор легок; среда оценки — это то место, куда уходят инженерные усилия», — сказал Ян. Он добавил, что для повседневного использования «в таких комьюнити-фреймворках, как GBrain, где обновления SkillOpt запускаются на Claude Sonnet, обучение навыку для одной задачи в среднем стоит всего 1–5 долларов». Стоимость этой оптимизации является разовой и полностью окупается при развертывании.
Тем не менее, для эффективной работы фреймворку необходимы определенные условия: несколько десятков репрезентативных примеров и оцениваемый сигнал обратной связи. Командам следует избегать применения SkillOpt к открытым или субъективным задачам. «Если нет чистого автоматического оценщика, вам придется разработать оценщика на основе человека или модели и следить за его стабильностью», — отметил Ян.
SkillOpt также легко интегрируется с существующими стеками оркестрации, устраняя серьезное препятствие для внедрения. Например, разработчики, уже использующие компиляторы конвейеров, могут гармонично запускать обе системы. «DSPy — это другой, дополняющий слой, — сказал Ян. — Он компилирует декларативные конвейеры языковых моделей и оптимизирует структуру программы; SkillOpt оптимизирует состояние внешнего навыка, которое загружает замороженный агент. Вы можете запускать их вместе».
Заглядывая в будущее, разработчики с открытым исходным кодом уже планируют периодический запуск SkillOpt на основе прошлых траекторий своих агентов, создавая небольшую экосистему самооптимизирующихся плагинов для агентов-кодеров. Этот цикл непрерывной обратной связи представляет собой значительный сдвиг в том, как адаптируются системы ИИ.
«Ценная версия самосовершенствования — это когда агент автономно обнаруживает знания для улучшения своего собственного поведения и пользовательского опыта в условиях проверки и аудита, — подытожил Ян. — Навыки — это самый быстрый, дешевый и обратимый первый шаг, и тот же образ мышления указывает на то, что в конечном итоге агенты будут оптимизировать самих себя, вплоть до их собственных весов».