Исследователи представили Self-Harness — фреймворк, позволяющий ИИ-агентам переписывать собственные правила и повышающий производительность до 60%


Не каждая компания может или должна создавать собственные передовые языковые модели искусственного интеллекта. Тем не менее, оболочку (harness), управляющую моделью, большинство предприятий могут и должны настраивать под свои конкретные задачи.
Разумеется, это проще сказать, чем сделать. Оболочки агентов по-прежнему в значительной степени настраиваются с помощью ручной специальной отладки — процесса, который в большей степени опирается на интуицию, а не на систематические циклы обратной связи, что затрудняет поспевание за стремительно развивающимися LLM.
Чтобы решить эту проблему, исследователи из Шанхайской лаборатории искусственного интеллекта представили концепцию «Self-Harness» — новую парадигму, в которой агент на базе LLM систематически совершенствует собственные правила работы. Анализируя собственные журналы выполнения (execution traces) для внесения правок, система заменяет ручные догадки эмпирическими данными.
Самосовершенствующиеся оболочки могут позволить командам разработчиков развертывать надежные пользовательские агенты, которые постоянно адаптируют собственные протоколы выполнения для преодоления специфичных для моделей слабостей.
Проблема проектирования оболочек (harness engineering)
Производительность агента на базе LLM определяется не только его базовой моделью, но и его оболочкой (harness): окружающей системой, которая предоставляет контекст и позволяет модели взаимодействовать с окружением. Оболочка включает в себя такие компоненты, как системные промпты, инструменты, память, правила верификации, политики во время выполнения (runtime), логику оркестрации и процедуры восстановления после сбоев.
Этот уровень имеет решающее значение, поскольку многие распространенные сбои агентов проистекают из самой оболочки, а не из модели. Например, агент может сообщить об успехе, не проверив ответ модели (например, не запустив код для проверки прохождения тестов), или может многократно повторять неудачное действие. Оболочка также отвечает за предотвращение деградации или перегрузки контекста при сильном увеличении истории взаимодействия агента. Примерами популярных оболочек являются SWE-agent, Claude Code, Codex и OpenHands.
Проектирование оболочек остается серьезной задачей, однако узким местом здесь вовсе не обязательно является слишком медленная или недостаточная квалификация людей.
Фактически, Ханьфань Чжан (Hangfan Zhang), ведущий автор статьи о Self-Harness, рассказал VentureBeat, что «в во многих случаях опытный инженер с глубокими предметными знаниями все еще может предложить лучшие изменения, чем это способна сделать LLM сегодня».
Вместо этого истинным узким местом ручного проектирования является то, что оно в значительной степени опирается на спорадическую отладку, а не на проверяемый эмпирический цикл обратной связи. «Более глубокая проблема заключается в том, что современной парадигме проектирования оболочек часто не хватает систематического циклического процесса обратной связи», — пояснил Чжан. — «Многие правки вносятся на основе интуиции, нескольких наблюдавшихся сбоев или ситуативной отладки».
С учетом того, что новые модели выпускаются стремительными темпами, упор на человеческую интуицию при ручной настройке специфичных для моделей оболочек становится все более затратным и несостоятельным. Хотя в некоторых подходах используются более мощные модели для улучшения оболочек более слабых целевых агентов, такая зависимость от внешнего руководства сопряжена с собственными трудностями: подобные модели могут быть дорогими, недоступными для передовых моделей или не соответствовать типам сбоев целевой модели.
Как работает Self-Harness
Парадигма Self-Harness позволяет агенту на базе LLM улучшать собственную оболочку без привлечения инженеров-людей или более мощных внешних моделей.
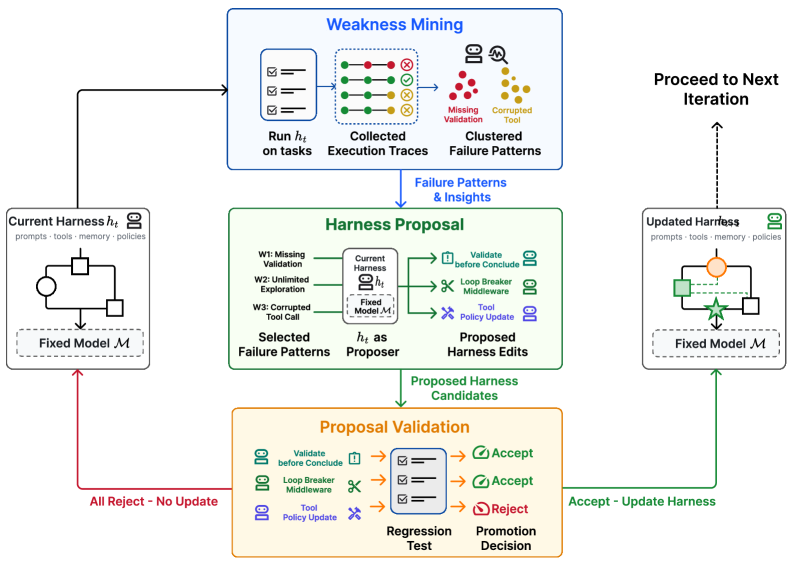
Эта непрерывная самоэволюция обусловлена трехэтапным итеративным циклом, который превращает поведенческие данные в обновления оболочки:
-
Выявление уязвимостей (Weakness mining): Начиная с исходной оболочки, агент запускает набор задач, создавая журналы выполнения с проверяемыми результатами. Агент классифицирует неудачные запуски и пытается обнаружить специфичные для модели шаблоны сбоев.
-
Предложение оболочки (Harness proposal): Основываясь на этих паттернах сбоев, агент выступает в роли «генератора предложений» (proposer), чтобы создать набор разнообразных, но минимальных модификаций оболочки, каждая из которых привязана к конкретному механизму сбоя во избежание излишне общих исправлений.
-
Валидация предложений (Proposal validation): Система оценивает кандидатные модификации с помощью регрессионного тестирования. Правка внедряется только в том случае, если она повышает производительность, не вызывая заметной деградации на отложенных (held-out) задачах. Если несколько модификаций-кандидатов проходят регрессионные тесты, они объединяются в следующую версию оболочки, которая затем служит отправной точкой для следующей итерации.
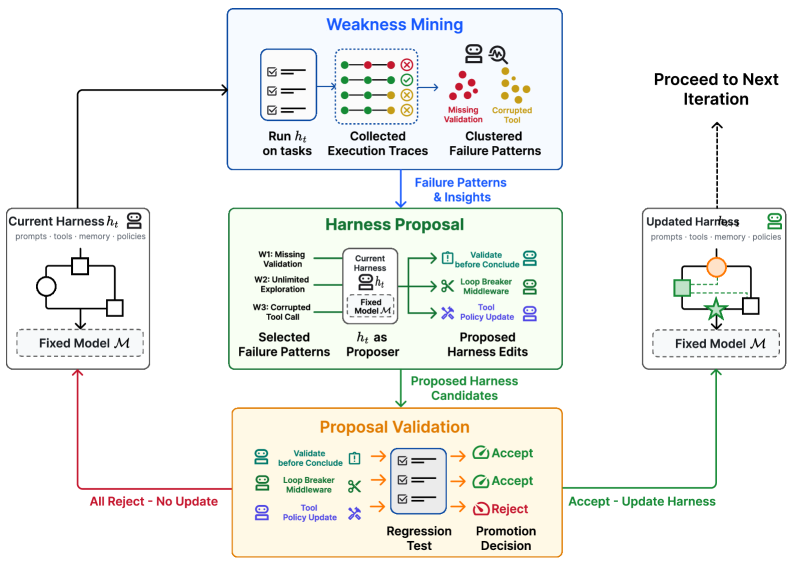
Фреймворк Self-harness (источник: arXiv)
Чтобы визуализировать, зачем это нужно предприятию, представьте себе автоматизированного агента для исправления багов, который читает внутреннюю документацию, пишет патчи и открывает pull requests. Если компания обновит стиль своей документации, агент может внезапно дать сбой, вытянув не тот контекст или написав плохие патчи.
На первый взгляд агент просто выглядит сломанным. Но Self-Harness превращает этот неопределенный сбой в решаемую проблему. «Журналы сбоев показывают, где агент неправильно использует новый формат документации; генератор предложений может создать целевую правку оболочки… а оценщик может решить, улучшает ли эта правка неудачные случаи без ухудшения других случаев», — сказал Чжан.
Self-Harness в действии
Исследователи оценили эффективность Self-Harness на бенчмарке Terminal-Bench-2.0, который проверяет общее выполнение задач на базе инструментов, включая управление артефактами, использование команд, поведение верификации и восстановление после ошибок выполнения. Они применили Self-Harness с моделями MiniMax M2.5, Qwen3.5-35B-A3B и GLM-5.
Чтобы изолировать влияние саморазвивающейся оболочки, они начали с минимальной оболочки, созданной на базе DeepAgent SDK и содержащей только системный промпт для бенчмарка, а также инструменты файловой системы и командной оболочки (shell) по умолчанию. Бэкэнд модели, набор инструментов, среда бенчмарка и оценщик оставались неизменными, в то время как варьироваться могла только оболочка.
Количественные результаты показывают, что агенты улучшили свою производительность за счет автоматических правок оболочки. На отложенных задачах производительность значительно возросла по всем направлениям: относительное улучшение для различных моделей составило от 33 до 60 процентов.
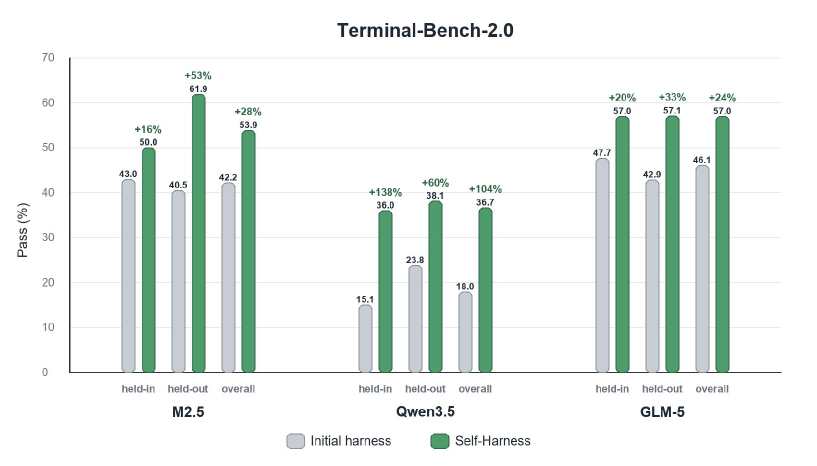
Self-harness позволяет агентам улучшать собственный код и адаптировать его под базовую модель (источник: arXiv)
Важно отметить, что правило явного принятия одобряет только те правки, которые повышают производительность, не привнося неприемлемых регрессий. Что делает Self-Harness мощным инструментом для корпоративных приложений, так это то, что он не просто делает промпт длиннее или добавляет общие инструкции. Вместо этого он внедряет целевые изменения, отражающие повторяющиеся проблемы, с которыми сталкивается каждая модель во время выполнения.
Например, в рамках базовой оболочки MiniMax M2.5 застревала в бесконечном исследовании конфигураций датасетов до тех пор, пока среда выполнения не завершалась по тайм-ауту, не выдавая никаких результатов. С помощью Self-Harness система выявила этот конкретный изъян и прописала в своей политике времени выполнения «прерыватель цикла» (loop breaker), заставляющий агента остановиться и изменить подход после 50 вызовов инструментов. Она также добавила правило создания начальной версии требуемых артефактов как можно раньше.
С другой стороны, Qwen-3.5 имела привычку натыкаться на ошибку перезаписи файлов, а затем вслепую повторять одну и ту же команду снова и снова, в конечном итоге по недоразумению удаляя необходимые файлы перед тем, как остановиться. Самооболочка исправила это путем внедрения строгой дисциплины повтора команд (запрещающей точные дубликаты команд) и механизма, который заставлял агента немедленно воссоздавать любые недостающие артефакты в случае возникновения ошибки с файлом.
GLM-5 испытывала трудности с сохранением изменений среды между различными командами и часто тратила впустую время на массивные загрузки или завершала задачи даже тогда, когда проверки работоспособности (sanity checks) терпели неудачу. Ее самогенерируемая оболочка внедрила правила, предписывающие агенту сохранять переменные среды PATH между сеансами оболочки, ограничивать внешние вычисления и восстанавливать любые неудачные проверки работоспособности перед завершением своего цикла.
Скрытые издержки автоматизированных оболочек
Хотя Self-Harness автоматизирует утомительную работу по отслеживанию специфических сбоев моделей, лица, принимающие решения, должны реалистично оценивать сопутствующие издержки. Замена ручного проектирования автоматизированным методом проб и ошибок требует значительных вычислительных затрат.
«Self-Harness заменяет часть рутинной работы человека-инженера повторяющейся генерацией предложений, параллельной оценкой кандидатов и регрессионным тестированием», — сказал Чжан. — «Это может означать большее количество токенов API, большую задержку во время оптимизации и больше инфраструктуры для запуска задач оценки».
Кроме того, эта система опирается на точность своего конвейера оценки. Во время экспериментов на Terminal-Bench-2.0 исследователи полагались на строгие детерминированные верификаторы, чтобы гарантировать реальную пользу вносимых агентом правок. Без столь строгой базы для сравнения автоматизированная система рискует продвигать неудачные обновления. «[Система] оценки — это не опциональный компонент; именно она позволяет нам обменять человеческую интуицию на эмпирические данные», — отметил Чжан.
Эта зависимость от строгих верификаторов также диктует, где следует развертывать Self-Harness. «Лучшими целями для развертывания сегодня являются среды, где сбои можно измерить и где метод проб и ошибок относительно безопасен», — сказал Чжан, указав на программирование, автоматизацию внутренних рабочих процессов и конвейеры данных DevOps в качестве идеальных сценариев использования.
И наоборот, предприятиям следует избегать полной автоматизации оболочек в областях с высокими ставками или в субъективных сферах. «Самыми явными красными флажками являются те домены, где оценка является субъективной, отложенной, недетерминированной или чреватой слишком высокой ценой ошибки, например, принятие медицинских решений, критически важная для безопасности инфраструктура или юридические решения».
От твикеров промптов к архитекторам обратной связи
Появление самосовершенствующихся агентов не означает, что программирование или корпоративные рабочие процессы внезапно станут свободными от участия человека. Качество сотрудничества между инженером-человеком и ИИ по-прежнему имеет первостепенное значение, и его трудно зафиксировать с помощью автоматизированных бенчмарков.
Вместо этого профессия инженера поднимается на новый уровень абстракции. «Роль корпоративных инженеров сместится от ручного исправления отдельных промптов или вызовов инструментов к проектированию систем обратной связи, которые делают возможным совершенствование агентов», — предсказал Чжан. В дальнейшем «инженер станет меньше настройщиком промптов и больше архитектором обратной связи».
По мере того как базовые модели будут становиться все более способными, они естественным образом поглощат многие возможности, которые в настоящее время требуют ручного проектирования оболочек. «Но как только это произойдет, оболочка не исчезнет; ее сфера применения расширится наружу, чтобы подключить модель к более богатым внешним средам», — сказал Чжан. — «До тех пор, пока эта граница не выйдет за рамки того, что люди способны оценить, люди будут оставаться критически важными поставщиками обратной связи».