Инструмент с открытым исходным кодом EnvHarness от Google позволяет ИИ-агентам тренироваться в среде, которая развивается вместе с ними
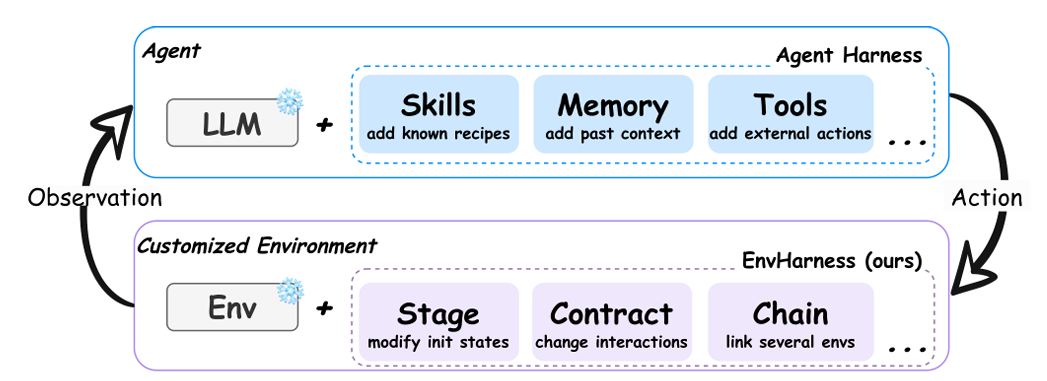
Обучение агентов для выполнения конкретных задач, таких как написание кода или навигация по веб-страницам, требует сред, в которых они могли бы безопасно практиковаться, совершать ошибки и совершенствоваться. Но создание таких сред обходится дорого, и после их создания они, как правило, остаются статичными, даже несмотря на то, что агент становится лучше.
Исследователи из Google Cloud AI Research и академические партнеры разработали инфраструктуру с открытым исходным кодом (лицензия Apache 2.0), которая превращает эти статичные среды в адаптируемые к слабостям использующего их агента.
Эта инфраструктура, получившая название EnvHarness, добавляет программируемый слой поверх существующей среды. Она может изменять точку старта агента, то, что он видит, доступные ему действия и продолжительность выполнения задачи, оставляя при этом неизменными базовую среду и ее верификатор.
В пяти бенчмарках, охватывающих разработку программного обеспечения, навигацию в сети, офисную работу и предметные задачи, агенты, обучавшиеся в средах EnvHarness, улучшили свои результаты на отложенных задачах на величину до 9 баллов. В бенчмарках по разработке программного обеспечения они также справлялись с задачами за меньшее количество шагов по сравнению с агентами, обучавшимися в исходных средах.
Для корпоративных команд ИИ этот подход представляет собой альтернативу постоянному созданию новых симуляторов и учебных задач с нуля: начать с надежной среды и динамически подстраивать ее под текущие слабости агента.
Почему статичные обучающиеся среды становятся узким местом
Агенты учатся во взаимодействии со средой. Для агента-программиста среда может содержать репозиторий, оболочку и набор тестов. Браузерный агент может работать с веб-сайтом. Агент корпоративной автоматизации может действовать внутри изолированной версии внутреннего приложения.
Среда задает задачу, поддерживает свое состояние, реагирует на действия агента и определяет, увенчались ли они успехом. Создание всего этого требует инженерной работы, особенно когда среде необходим надежный верификатор, способный определить, правильно ли агент выполнил задачу.
Проблема заключается в том, что большинство сред остаются неизменными после их создания. Они не подстраиваются под конкретного агента, который их использует. Если агент раз за разом терпит неудачу из-за того, что не проверяет тест перед редактированием кода, среда автоматически не создает ситуации, заставляющие его отработать этот навык. А как только агент усваивает существующие задачи, симулятор становится гораздо менее полезным и хуже помогает дальнейшему совершенствованию агента.
Это также затрудняет поиск полезных граничных случаев по мере совершенствования агента. «По мере того как агент становится лучше, по-настоящему сложные среды могут стать чрезвычайно редкими в этом фиксированном пространстве, поэтому командам приходится производит экспоненциально большую выборку сред, чтобы найти значимые граничные случаи», — рассказал VentureBeat Цизыфен Ван (Zifeng Wang), научный сотрудник Google и соавтор работы.
Одним из решений этой проблемы является генерация большего количества сред с помощью ИИ.
Например, GenEnv — это инфраструктура, использующая LLM в качестве симулятора, который генерирует переходы, наблюдения и сигналы об успехе, пытаясь удерживать задачи на пределе возможностей агента. Другой подход — Agent-World, которая программно синтезирует исполняемые инструменты, базы данных и задачи для построения новых сред.
Но генерация среды порождает собственные проблемы. Такие пайплайны, как правило, привязаны к конкретным доменам, а сгенерированные среды необходимо проверять на корректность. LLM, выступающая в роли симулятора, может создавать некорректные переходы или искажать сигналы обратной связи. Между тем, исполняемые среды, синтезированные с нуля, могут содержать логические ошибки.
Генерация большего количества сред также не обязательно решает проблему адаптации. Ван утверждает, что если эти среды по-прежнему происходят из фиксированного распределения, команды могут в итоге заменить один статический пул другим. По мере совершенствования агента полезные обучающие примеры вновь становится все труднее находить.
Как EnvHarness делает среду программируемой
EnvHarness использует иной подход. Вместо генерации новых сред она меняет то, как существующая среда подается агенту.
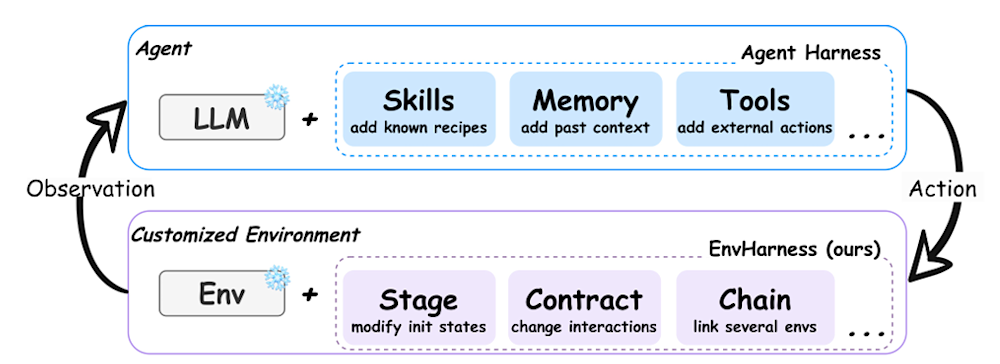
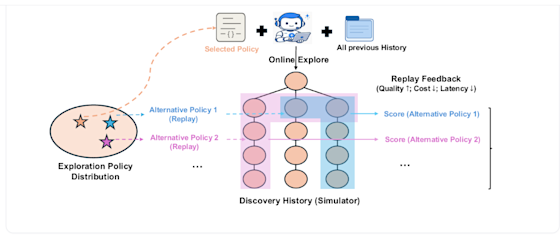
Агентная обвязка (harness) против EnvHarness (источник: arXiv)
Исследователи проводят аналогию с обвязкой агента (agent harness) — программным слоем, который окружает LLM инструментами, памятью, управлением контекстом и циклами выполнения.
Проще говоря:
Агент = модель + обвязка агента
EnvHarness применяет ту же идею к другому концу взаимодействия:
Кастомная среда = стационарная среда + EnvHarness
Агент продолжает взаимодействовать через тот же интерфейс, что и раньше. EnvHarness располагается между агентом и средой и изменяет процесс обучения без модификации самого симулятора.
Инфраструктура предоставляет три компонента.
Этап (Stage) изменяет начальное состояние среды. Например, одна из задач в бенчмарке ALFWorld требует от агента поставить чистую кружку на стол. Обычно кружка находится на самом видном месте. Stage может сначала поместить ее внутрь закрытого выдвижного ящика, что заставит агента заняться поисками перед тем, как выполнить задачу. Stage также может сделать противоположное и заранее выполнить раннюю часть задачи, позволив сосредоточиться на обучении более позднему шагу.
Контракт (Contract) изменяет само взаимодействие. Он может фильтровать действия, модифицировать ответы или контролировать то, что видит агент. В той же задаче Контракт может изменить описание комнаты и удалить часть деталей, чтобы агент был вынужден собирать информацию за несколько шагов, или убрать навигационные подсказки, чтобы ему пришлось обыскивать комнату за комнатой.
Цепочка (Chain) объединяет задачи вместе. Например, после того как кружка поставлена на стол, агенту может быть предложено разогреть картофель и положить его на столешницу. Для успеха теперь требуется выполнение обеих задач, что создает более длинную траекторию, в рамках которой агент должен удерживать свои цели и рационально распределять действия.
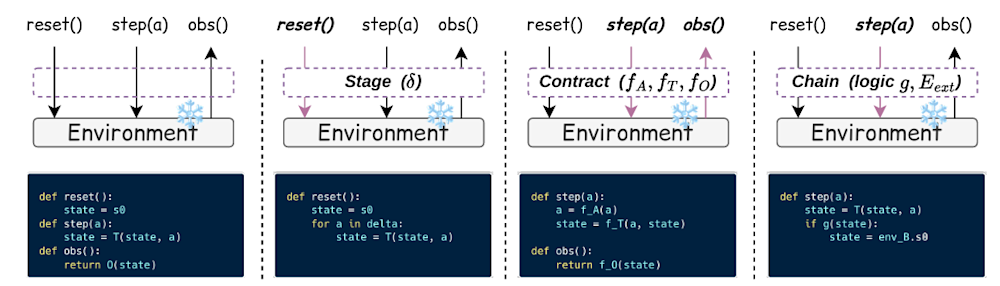
Различные компоненты EnvHarness (источник: arXiv)
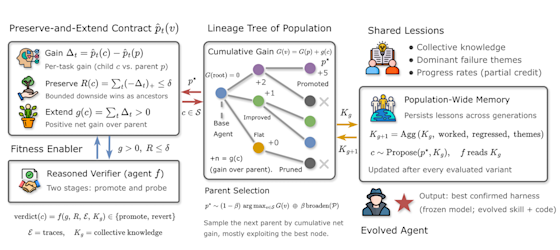
Другая часть инфраструктуры, EnvRigger, автоматизирует процесс принятия решений о том, как EnvHarness должна модифицировать среду на основе слабостей агента.
EnvRigger следует циклу «Наблюдение → Диагностика → Написание → Проверка» (Observe → Diagnose → Write → Validate). Сначала она запускает агента несколько раз и изучает его успешные и неудачные траектории на предмет повторяющихся паттернов ошибок. На основе полученных данных она формирует компоненты EnvHarness, призванные выявить или исправить эти недочеты, и запускает новые траектории, чтобы проверить, создают ли ее изменения полезный и разрешимый обучающий пример.
Ван приводит в пример агента-программиста, который срезает углы и отправляет патч без предварительного запуска тестов. «Когда система замечает, что агент идет по легкому пути, например отправляет исправление кода без запуска каких-либо тестов, она автоматически создает правило-плагин для перехвата этой преждевременной отправки и возврата предупреждения, заставляя агента сначала должным образом запустить набор тестов», — говорит он.
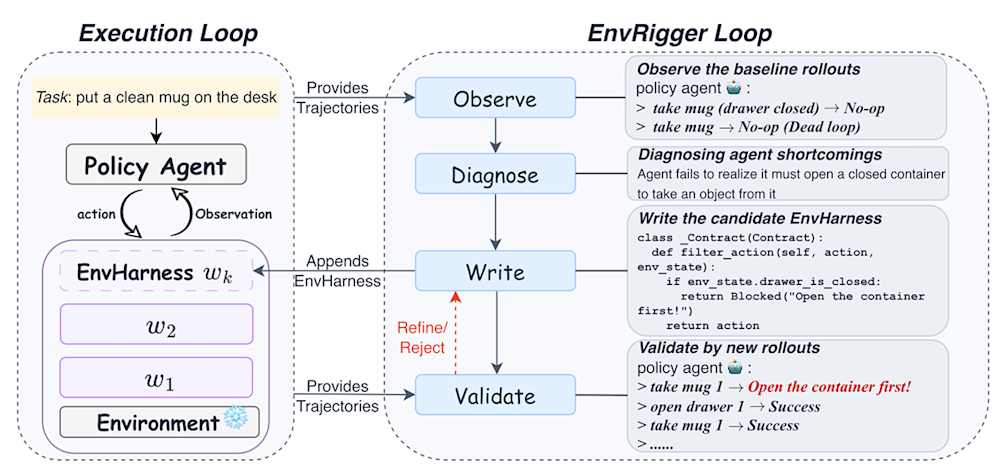
EnvRigger (источник: arXiv)
Важная деталь заключается в том, что плагин изменяет условия, в которых работает агент, а не базовую задачу или ее оценщик.
В этом примере исходный репозиторий и написанные людьми модульные тесты остаются нетронутыми. Контракт блокирует преждевременную отправку извне, но исходные тесты по-прежнему определяют, является ли патч правильным. Это позволяет сохранить доверенный верификатор и при этом дать агенту новый навык для практики.
EnvRigger также проверяет свои изменения перед их сохранением. В экспериментах, описанных в статье, базовый цикл начинается с пяти прогонов исходной задачи и пяти свежих прогонов с кандидатом на модификацию. Если кандидат делает задачу неразрешимой, слишком простой или иным образом не дает полезного сигнала, EnvRigger может доработать его и провести дополнительные раунды валидации — вплоть до пяти итераций «написание-проверка».
EnvHarness в действии
Исследователи протестировали EnvHarness на ALFWorld, WebArena, SWE-bench Verified, OfficeQA и SpreadsheetBench.
В основных экспериментах они собирали траектории из сред и извлекали из них многократно используемые навыки. Навыки, полученные в средах EnvHarness, превзошли навыки, полученные в неизмененных средах, во всех пяти бенчмарках.
В SWE-bench Verified, помимо возросшей точности, обучение с EnvHarness привело к сокращению средней траектории с 55,01 до 49,61 шагов.
EnvHarness также продемонстрировала благоприятные результаты по сравнению с системами, созданными специально для генерации обучающих сред. В SWE-bench Verified она превзошла SWE-smith на 2,46 процентных пункта, требуя при этом на 5,11 шагов меньше на эпизод. В ALFWorld она в среднем превзошла GenEnv на 5,7 балла.
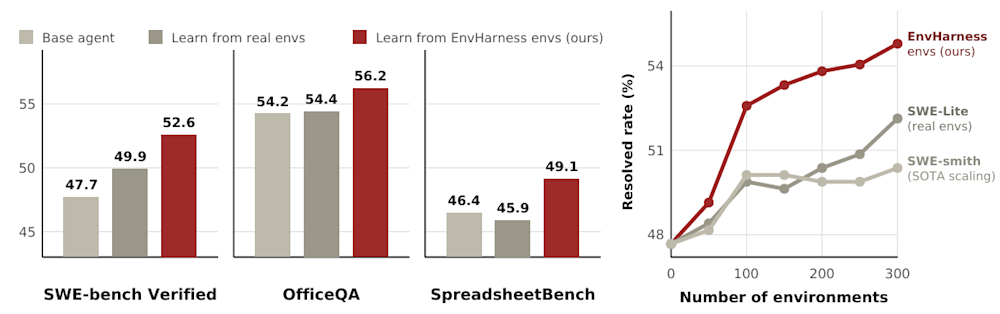
Производительность EnvHarness на отраслевых бенчмарках (источник: arXiv)
Еще более интересные результаты наблюдаются, когда исследователи многократно запускают цикл адаптации. Каждая новая партия EnvHarness разрабатывается против агента уже после того, как он обучился на предыдущих партиях. Например, в среде программирования ранние раунды выявляют базовые проблемы, такие как запуск тестов и редактирование файлов. В более поздних раундах обнаруживаются другие слабости, включая сломанные тестовые раннеры, ограничения ресурсов и определение правильного интерпретатора Python.
Эксперименты по масштабированию, описанные в статье, демонстрируют эффект этой адаптации. В SWE-bench Verified базовый агент стартовал с 47,67% и достиг 54,79%, по мере того как пул обучения EnvHarness вырос до 300 сред. Обучение на таком же количестве оригинальных сред дало 52,13%, в то время как среды, сгенерированные с помощью SWE-smith, достигли 50,37%. Кривые для оригинальных и сгенерированных сред выровнялись раньше, в то время как EnvHarness продолжала создавать учебные среды под последние возможности агента.
Тот же принцип переносится и за пределы программирования. В WebArena исследователи задали уязвимость, при которой агент отвечал, не прокручивая страницу вниз, и упускал информацию под «сгибом» экрана. EnvHarness создала Контракт, который блокировал действия по извлечению данных до тех пор, пока агент не прокрутит страницу, что привело к появлению траекторий, обучающих агента изучать всю страницу целиком перед ответом.
Что нужно предприятиям для использования EnvHarness
EnvHarness не занимается обучением самого агента. Она создает условия, которые должен использовать другой механизм обучения.
В основных экспериментах исследователи используют пайплайн в стиле ReasoningBank для превращения траекторий в многократно используемые навыки. В корпоративном развертывании также потребуется объединить EnvHarness с извлечением навыков или памяти, дообучением, обучением с подкреплением или другим механизмом, который изменяет агента на основе его опыта.
Это также делает EnvHarness дополнением к растущему классу инфраструктур, которые автоматически модифицируют обвязку агента, таким как Self-Harness, HarnessX и DarwinX.
Эти методы изменяют сторону агента во взаимодействии, улучшая его правила, рабочие процессы, навыки или другие строительные леса (scaffolding). EnvHarness изменяет условия, в которых обучается агент. «Оптимизация на стороне агента не может происходить в вакууме — внутреннее планирование, рефлексия и принятие решений агентом формируются под воздействием его взаимодействия с внешним миром», — отметил Ван. Динамические ограничения среды могут заставить усовершенствованную обвязку столкнуться с поведением, которого она в противном случае могла бы избежать или решить с помощью хрупких ухищрений.
Хотя исследователи не тестировали EnvHarness совместно с фреймворками саморазвивающихся агентов, эти подходы воздействуют на разные части стека и в принципе могут формировать цикл обратной связи: EnvHarness выявляет уязвимость, система на стороне агента улучшает обвязку, а затем EnvHarness создает новые вызовы вокруг обновленного агента.
Существуют две основные затраты на внедрение. Первая — это интеграция существующей среды с EnvHarness. Командам необходимо написать мост (Bridge), который представляет среду через общий для инфраструктуры интерфейс ActionableEnv. В статье уже приведены мосты для нескольких типов сред выполнения, включая среды на базе Docker для SWE-bench, OfficeQA и SpreadsheetBench.
Для контейнеризированных рабочих процессов разработки ПО, по словам Вана, интеграция может находиться вне самой среды. «Корпоративные пайплайны CI/CD обычно запускают среды внутри изолированных контейнеров Docker или Kubernetes, и EnvHarness просто подключается в качестве легковесного внешнего плагина поверх этого существующего тестового раннера», — пояснил он. Для сред, которые уже предоставляют требуемый паттерн взаимодействия сброса и шага (reset-and-step), это означает, что команды могут сохранять образ контейнера, кодовую базу и внутренние модульные тесты в неизменном виде, в то время как EnvHarness перехватывает команды на уровне интерфейса.
Вторая статья расходов — это вычисления. «Компромисс с EnvHarness носит скорее вычислительный, чем архитектурный характер», — говорит Ван. Операционные расходы связаны с циклом EnvRigger, которому требуется множество прогонов агента для диагностирования слабости, генерации модификации и проверки ее разрешимости.
Требование сброса состояния также создает четкие границы применимости EnvHarness. Она подходит для цифровых «песочниц», где прогоны обходятся дешево, а состояние можно быстро восстановить: например, среды программирования, симуляции использования инструментов и тестовые системы веб-автоматизации. Избегайте запуска диагностического цикла напрямую на системах с необратимыми побочными эффектами или дорогим сбросом, таких как «живые» производственные базы данных, реальные клиентские учетные записи или физические роботы. В таких случаях необходим безопасный симулятор, тестовый арендатор (tenant) или восстанавливаемая копия рабочей среды.
Google Research опубликовала код EnvHarness, конфигурации экспериментов и реализацию обучения с подкреплением на GitHub под мягкой лицензией Apache 2.0.
По мере совершенствования моделей, лежащих в основе EnvRigger, исследователи ожидают снижения затрат на проектирование и валидацию модификаций сред, поскольку более сильным агентам-проектировщикам потребуется меньше итераций. Но цель состоит не в том, чтобы исключить созданные людьми среды. Ван определяет EnvHarness как способ извлечь большую ценность для обучения из меньшего набора высококачественных сред с надежными проверенными верификаторами.
«EnvHarness не заменяет базовые среды — она действует как усилитель для них», — сказал Ван. «Хотя созданные человеком среды будут и дальше служить базовым эталоном, такие подходы, как EnvHarness, могут предложить практический путь к снижению накладных расходов на разработку и обеспечению большего покрытия для каждой среды».