Dream-RSI от Google сокращает количество обращений агентов поиска до 162 раз за счет повторного использования уже выполненных запросов
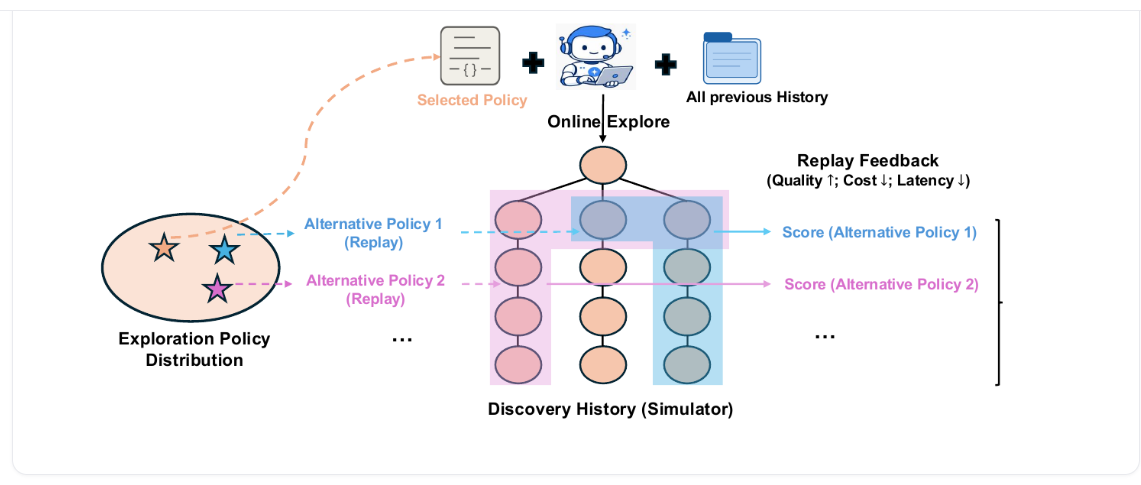
Команды продолжают тратить десятки тысяч токенов и вызовов агентов по мере того, как совершенствуют циклы поиска решений, причем значительная часть этих средств, по утверждению исследователей Google, уходит на тупиковые пути, которые уже терпели неудачу ранее. Их ответ на это — позволить агентам «мечтать» (dream) о прохождении таких циклов, обучаясь на прошлых попытках для направления будущих поисков. Они называют этот подход Dream-RSI, и в ходе тестов ему потребовалось в 162 раза меньше вызовов агентов обнаружения, чем существующей системе поиска SimpleTES.
Система построена на легковесному уровне оркестровки, который управляет ветвлением, параллельным исследованием и решениями об остановке без изменения базового агента кодирования. Процесс поиска является «явным и программируемым», а система оценивает и совершенствует стратегии без необходимости многократного запуска дорогостоящих повторных прогонов в режиме онлайн.
В различных областях Dream-RSI обеспечила сопоставимое или более высокое качество поиска при существенном снижении затрат на вычисления.
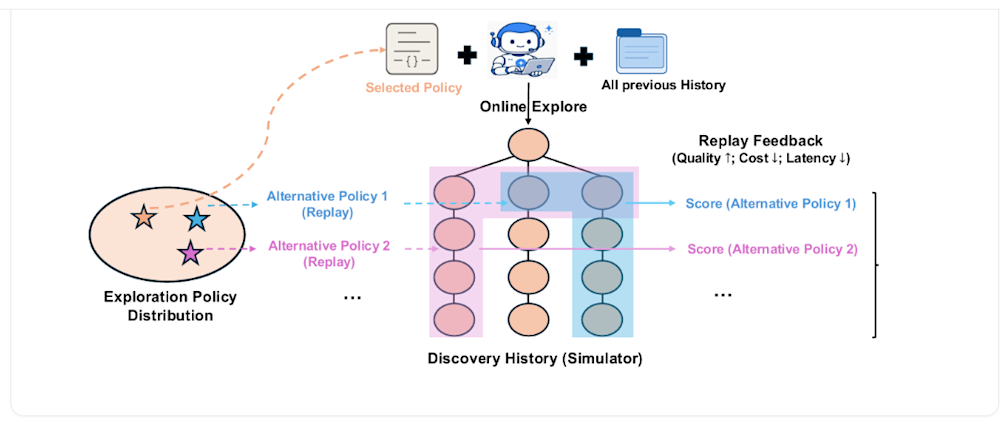
«Поскольку все результаты выполнения уже сохранены в дереве, оценка новой стратегии требует лишь чтения прошлых записей без повторного запуска базового агента обнаружения или оценщика», — поясняют исследователи.
Это исследование появилось спустя несколько дней после того, как Дарио Амодеи (Dario Amodei) опубликовал свое эссе «Мы должны задавать темп на передовой» («We Must Pace the Frontier») 12 сентября. Сооснователь Anthropic назвал рекурсивное самосовершенствование (recursive self-improvement, RSI) одним из двух факторов, изменивших его мнение о необходимости замедления разработки ИИ, поскольку оно может привести к появлению искусственного интеллекта, который станет слишком мощным для контроля со стороны человека.
Однако этот новый эксперимент, основанный на результатах бенчмарков, подчеркивает разрыв между экзистенциальной угрозой, о которой предупреждают Амодеи и другие специалисты, и более узкими, прагматичными вариантами использования циклов самоисследования агентов.
Создание «исторических деревьев поиска»
RSI целиком сосредоточен на эффективном поиске — где и когда выполнять ветвление, запускать процессы параллельно или отсекать тупиковые ветви. Однако управление этим процессом может быть проблематичным, поскольку циклы поиска разрастаются до тысяч итераций. Исследователи пишут на сайте проекта, что поиск по-прежнему остается «написанным вручную и статичным», а фиксированная стратегия не учится на накопленном опыте, из-за чего разработчики продолжают платить за пути, которые ранее приводили к провалу.
«Неэффективный поиск может тратить впустую огромные объемы вычислительных ресурсов и времени, что серьезно ограничивает эффективность и масштабируемость RSI», — пишут они. Узким местом является «обратная связь на метауровне», поскольку она запаздывает, обходится дорого и в конечном счете избыточна. Разработчики по сути воспроизводят ту обратную связь, за которую они уже заплатили.
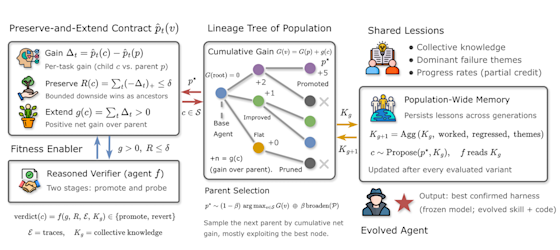
Команда, состоящая из 17 исследователей из Google, Google DeepMind, Мэрилендского и Виргинского университетов, утверждает, что поиск должен быть представлен в виде структурированного «исторического дерева поиска» (historical discovery tree), содержащего каждое решение агента и его результат. Это дает модели возможность выбирать следующее направление для исследования без необходимости что-либо пересчитывать.
«Оно проходит по тому же записанному дереву в другом порядке, и любой запрошенный результат уже находится на диске», — пишут исследователи. Система способна просеять тысячи прошлых результатов без дополнительных вычислений и выбрать победителя для внедрения. По сути, это создает «симулятор воспроизведения» (replay simulator) на основе ранее накопленной истории поисков.
Важно отметить, что заданная человеком стратегия поиска определяет, где агент производит поиск, какие попытки должны выполняться параллельно и когда исследование следует остановить.
Dream-RSI работает в три этапа: «онлайн-поиск» (online explore), на котором стратегии направляют агента на построение дерева поиска и запись исторических трассировок; «создание симулятора воспроизведения» (construct replay simulator), на котором дерево и его трассировки добавляются в повторно используемый репозиторий; и «улучшение стратегии на основе сновидений» (dreaming-based policy improvement), на котором агент фактически «выдумывает» альтернативные стратегии.
Агент исследует пространство, по мере необходимости дополняет свое дерево поиска, переписывает стратегию, оценивает каждую версию, а затем повторно развертывает лучший вариант. Каждый новый круг «добавляет мир»: победившие стратегии возвращаются в онлайн-режим для создания нового дерева поиска.
«Эта история была там всегда; предыдущие работы интерпретировали ее иначе — как статический текстовый контекст для промптов или как обучающие данные для точной настройки весов», — пишут исследователи.
«История — это мир, в котором можно мечтать, — утверждают авторы. — Дерево поиска, которое агент уже построил, является точным симулятором достигнутого им пространства поиска». Модель совершенствуется посредством «мечтаний» и тестирует новую стратегию поиска путем ее «воображения», а не за счет многократного проживания в реальности.
«Симулятор — это все, что может ответить на вопрос „что было бы, если…“ без запуска реального мира», — пишут они.
Результаты Dream-RSI в ключевых бенчмарках
В ходе ряда последовательных раундов поиска на алгоритмических задачах, задачах для графических процессоров и математической оптимизации исследователи выяснили, что изученная стратегия поиска Dream-RSI адаптирует использование вычислительных ресурсов для генерации лучших результатов с меньшим количеством вызовов агентов по сравнению с существующими подходами.
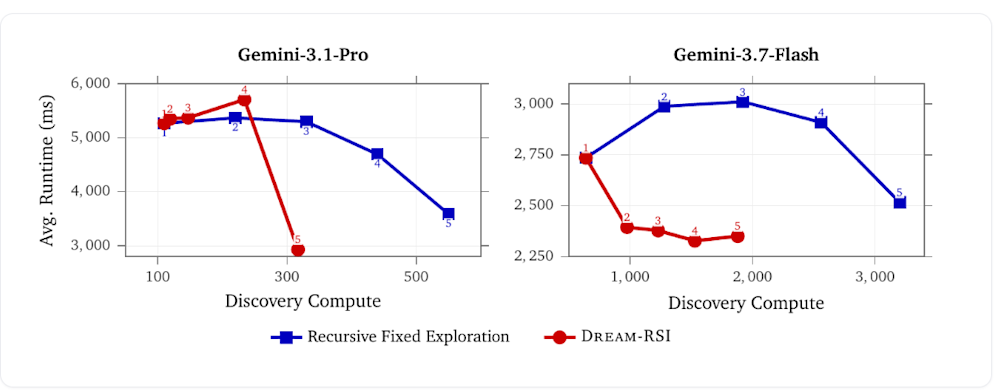
В тестах по поиску Lasso (где агентам предлагается задача на программирование и оптимизацию) Dream-RSI продемонстрировала лучший баланс между качеством и вычислительными затратами по сравнению с подходом Recursive Fixed Exploration (RFE). RFE — это метод, при котором агент ИИ исследует пространство поиска с помощью фиксированного оркестратора, а не адаптируется со временем.
Изображение CleoPtolemy, созданное с помощью Midjourney
При использовании Gemini-3.1-Pro система Dream-RSI сократила среднее время выполнения на шести наборах данных с 3587,1 до 2931,0 миллисекунд и уменьшила количество вызовов агента обнаружения с 550 до 317. С Gemini-3.7-Flash она снизила среднее время выполнения с 2516,7 миллисекунд до 2350,6 миллисекунд, а количество вызовов — с 3200 до 1879. В SimpleTES (базовой системе, давшей показатель в 162x) использовалась другая базовая модель — gpt-oss-120b с 51 200 генерациями.
Исследователи оценили Dream-RSI в области проектирования ядер GPU, где перед агентами ставится задача поиска высокопроизводительных реализаций ядер без ущерба для числовой корректности. Это требует одновременного учета доступа к памяти, распараллеливания, алгоритмов и оптимизации под конкретное железо. Благодаря этому бенчмарк отлично подходит для определения того, способна ли Dream-RSI обобщаться на задачи за пределами чисто математических открытий.
В задаче ConvDiv для GPU-ядер (которая оценивает эффективность выполнения рабочих нагрузок машинного обучения уровня железа на видеокарте) производительность Dream-RSI последовательно росла, сократив количество оцениваемых попыток со 110 до 50 перед новым ростом примерно до 90, после чего прогресс стабилизировался.
В задачах программирования GPU VGG16 и LayerNorm система Dream-RSI достигла сопоставимой производительности, используя в 2,43 и 1,79 раза меньше генераций. На задачах ConvDiv и ConvMax она обеспечила в 2,09 и 1,44 раза более высокую производительность в рамках сопоставимых бюджетов.
«Мечтания внутри симулятора воспроизведения, созданного на основе исторических деревьев поиска, обеспечивают немедленную и дешевую обратную связь вне стратегии (off-policy) для оценки и уточнения стратегий поиска без повторения дорогих онлайн-оценок», — пишут исследователи. Для команд, которые уже тратят огромные ресурсы на вызовы агентов, выгода заключается в записях, которые они уже однажды оплатили, при этом код находится в открытом доступе.