«Лучше, чем DeepSeek»: Xiaomi представляет MiMo-V2.6-Pro как лучшую в мире модель с открытыми весами наряду с более дешевой V2.6-Flash
Неожиданно для всех китайский производитель электромобилей и бытовой электроники Xiaomi выпустил новую версию своего растущего семейства языковых моделей MiMo. Модель MiMo-V2.6-Pro заняла первое место среди моделей с открытыми весами в мире по версии сторонней аналитической компании Artificial Analysis, набрав 46 баллов в Иллюстрированном индексе интеллекта.
Благодаря этому новый флагмон Xiaomi опередил проприетарные модели, включая Grok 4.6 от xAI (сейчас у него 44 балла) и Gemini 3.8 Flash от Google (41 балл), в соответствии с последней методологией оценки Artificial Analysis. Кроме того, MiMo-V2.6-Pro разделил первое место с недавно выпущенным Grok 4.7, который дебютировал в тот же день и также набрал 46 баллов, обогнав другие китайские открытые модели DeepSeek V4.1 Flash (39) и DeepSeek V4.1 Pro (36).
Этот результат поразителен не только потому, что на международной арене Xiaomi больше известна своими смартфонами, электромобилями и бытовой техникой, а не передовыми технологиями ИИ.
Дело также в том, что MiMo-V2.6-Pro распространяется с открытыми весами по лицензии MIT и доступен через API Xiaomi по значительно более низкой цене, чем многие проприетарные модели схожего уровня производительности.
Иными словами, как независимые разработчики, так и крупные компании могут бесплатно скачать ее с платформы Hugging Face, кастомизировать или дообучить под свои задачи, запустить на собственном или арендованном „железе“ и использовать в производственных процессах — и все это без выплаты Xiaomi ни цента. Модель также можно использовать через API Xiaomi (что может быть сложнее для тех, у кого есть ограничения на использование серверов в Китае) по одной из самых низких цен за миллион токенов.
Xiaomi взимает $0,435 за миллион некешированных входных токенов и $0,87 за миллион выходных токенов. По данным Artificial Analysis, стоимость выполнения задачи моделью в Индексе интеллекта составляет $0,13, а скорость генерации на выходе — примерно 134 токена в секунду, при этом подтверждено наличие окна контекста в 1 миллион токенов для текста, изображений, аудио и видео.
Флагманскую модель дополняет MiMo-V2.6-Flash — меньшая по размеру и значительно более дешевая модель ($0,14/$0,28 за миллион входных/выходных токенов), которая сохраняет то же окно контекста в 1 миллион токенов и встроенные мультимодальные возможности, ориентируясь при этом на высокопроизводительные рабочие нагрузки. По нашей оценке, это вторая по дешевизне передовая модель в мире, доступная через интерфейс прикладного программирования (API).
Xiaomi также выпускает MiMo-V2.6-Pro-UltraSpeed, которая, по заявлению компании, способна генерировать текст со скоростью, до 20 раз превышающей стандартную скорость версии Pro.
В совокупности версия V2.6 выглядит не просто как запуск отдельной модели, а как очередной шаг в стремлении Xiaomi создать полный стек для открытых агентов: базовые модели, агенты для программирования, обвязки (harnesses), среды обучения с подкреплением и теперь инфраструктуру для их обучения.
От смартфонов и электромобилей к передовому искусственному интеллекту
Экспансия Xiaomi в сферу передовых моделей ИИ за последний год развивалась стремительными темпами.
Компания начала публично расширять семейство MiMo в 2025 году и большую часть 2026 года активно двигалась в сторону агентного ИИ. Выпущенные в апреле модели MiMo-V2.5 и V2.5-Pro заложили многие архитектурные и экономические идеи, которые теперь реализованы в V2.6: разреженные модели типа «модель экспертов» (MoE), миллионные окна контекста, мягкое лицензирование и необычайно низкие цены для долгосрочных агентских задач.
MiMo-V2.5-Pro уже представляла собой модель типа «модель экспертов» с 1,02 триллиона параметров (из которых 42 миллиарда были активными во время инференса), созданную специально для долгосрочной разработки программного обеспечения и того, что Xiaomi называла «осведомленностью об обвязке» (harness awareness) — способностью управлять памятью и контекстом при работе внутри агентских каркасов на протяжении сотен или тысяч вызовов инструментов.
В июне компания представила MiMo Code — терминального агента для программирования с открытым исходным кодом, обладающего постоянной памятью между сеансами, контрольными точками задач и отдельным субагентом для записи таких точек. Внутреннее тестирование Xiaomi показало, что преимущество MiMo Code над Claude Code становится более очевидным при выполнении рабочих процессов, превышающих 200 шагов выполнения, хотя эти результаты были предоставлены самим производителем и зависели от конфигурации.
Компания также представила HarnessX — исследовательский фреймворк, который рассматривает промпты, системы памяти, инструменты и логику управления вокруг модели как компоненты, которые могут самостоятельно переписываться и оптимизироваться. Xiaomi сообщила о среднем абсолютном приросте производительности на 14,5% в 15 комбинациях моделей и бенчмарков при динамическом изменении обвязки без замены базовой модели.
В MiMo-V2.6 эти направления работы интегрированы непосредственно в процесс обучения моделей.
Xiaomi потратила миллионы на масштабирование обучения с подкреплением
Главным техническим нововведением в версии V2.6 является обучение с подкреплением (RL). На этом этапе модель совершенствуется, решая задачи, получая награды или штрафы в зависимости от качества выполнения и корректируя свое поведение в сторону результатов, которые ведут к лучшим исходам.
Масштабирование этого процесса обходится дорого, поскольку агентские задачи могут включать длинные цепочки рассуждений, вызовов инструментов и верификации, но потенциальный выигрыш весьма существенен: вместо обучения исключительно на статических примерах модель получает постоянную практику реального выполнения сложной работы, включая планирование, использование инструментов, исправление ошибок и восстановление после неудачных стратегий.
Xiaomi сообщает, что MiMo-V2.6-Pro и более компактная MiMo-V2.6-Flash прошли по 30 масштабных этапов RL, охватывающих примерно 750 000 траекторий менее чем за шесть дней. Заявленные затраты составили около $2,62 млн для версии Pro и $850 000 для версии Flash.
В опубликованном техническом отчете эти масштабы описаны более предметно. Каждый этап обучения начинается с 1568 промптов, для каждого из которых генерируется по 16 кандидатов-траекторий. Это дает около 25 000 вариантов развертывания (роллаутов) и от 2,7 до 3,7 миллиарда обучающих токенов на шаг. По данным Xiaomi, длина получаемых последовательностей составляет в среднем от 110 000 до 150 000 токенов каждая.
Это означает, что Xiaomi занималась подкреплением не коротких ответов, а целых и протяженных агентских рабочих процессов.
Причем лишь часть средств ушла на обновление самой модели. Как заявляет Xiaomi, 43,5% затрат на RL для версии Pro ушло на само обучение, 43,8% — на генерацию вариантов и еще 12,7% — на их оценку. Иными словами, более половины бюджета было потрачено на формирование и оценку опыта модели до того, как этот опыт был преобразован в обновление весов.
Компания называет свою стратегию «You Only RL Once» (вы проходите RL лишь однажды). Вместо запуска совершенно отдельных программ обучения с подкреплением для написания кода, работы с визуальными данными, управления компьютером и кибербезопасности, Xiaomi объединяет эти домены и различные агентские обвязки в один масштабный обучающий прогон.
Разнообразие обвязок само по себе является частью этого распределения при обучении. Xiaomi заявляет, что создала легкие «мини-обвязки» для кодинга, общих профессиональных задач, визуальных задач и кибербезопасности, чтобы модель сталкивалась с различными комбинациями системных промптов, инструментов и стратегий управления контекстом, не привязываясь жестко к какому-то одному производственному каркасу.
В системе используется полностью асинхронная оптимизация относительной групповой политики (GRPO). Такой асинхронный дизайн критически важен, поскольку долго выполняющиеся задачи агентов завершаются не одновременно. Xiaomi задействует частичные роллауты, чтобы графические процессоры не простаивали в ожидании самых медленных траекторий: незавершенные задания прерываются и возобновляются позже. Компания также разработала механизм смешивания выборок, призванный помешать более быстрым или простым семействам задач доминировать над более медленными в каждом батче.
В результате «масштабирование RL» здесь означает масштабирование сразу нескольких параметров: количества сгенерированного моделью опыта, спектра сред, в которых этот опыт приобретается, и вычислительных ресурсов, затрачиваемых на определение того, какое поведение действительно стоит поощрять.
Обучение агента не простому прохождению тестов, а чистому решению задач
Этот последний аспект может оказаться одной из самых важных технических деталей отчета.
Простые бинарные награды могут подсказать модели для программирования, проходит ли ее патч набор тестов, но они не способны надежно различить два работающих решения, одно из которых является чистым и минималистичным, а другое привносит громоздкую резервную логику, ненужные изменения в API или хрупкие обходные пути.
Поэтому Xiaomi создала еще две более сложные системы вознаграждения.
-
Синтез групповых наград, или GRS (Groupwise Reward Synthesis), создает критерии оценки (рубрики) для конкретных задач путем сравнения нескольких попыток решения одной и той же проблемы. Эти рубрики раздельно оценивают качество реализации и качество поведения агента: удалось ли ему удовлетворить требования, справиться с краевыми условиями, учесть существующую кодовую базу, а также собрать и проверить необходимые данные.
-
Перераспределение группового преимущества, или GAR (Groupwise Advantage Redistribution), идет дальше, сравнивая успешные решения внутри одной группы роллаутов и перераспределяя бóльшую часть обучающего преимущества в пользу лучших вариантов.
В техническом отчете приводится эксперимент, объясняющий важность этого подхода. В прогоне RL только для кода на базе MiMo-V2.6-Flash обучение без онлайн-оценки на основе групп привело к быстрому росту количества шагов агента и длины генерируемых токенов, что в итоге вывело множество траекторий на пределы их ограничений по длине. При включенном GAR, как утверждает Xiaomi, показатели успешности продолжили расти, в то время как число шагов осталось примерно стабильным, а рост токенов происходил более плавно.
Аудиты с точки зрения мейнтейнеров также показал, что политика, обученная без онлайн-оценки, все чаще прибегала к таким методам, как спекулятивные ветки совместимости, широкие экспорты, проглатывание исключений, смягченная валидация и специфичные для оценки изменения конфигурации. Политика с групповой оценкой, по утверждению Xiaomi, склонна генерировать более компактные и точные патчи.
Это затрагивает фундаментальную проблему агентского обучения с подкреплением: модель может лучше справляться с максимизацией награды, но не становиться лучше в самой работе, которую эта награда призвана олицетворять.
Необычайно подробную часть отчета Xiaomi посвящает этой проблеме под заголовком «взлом вознаграждения» (reward hacking).
На ранних этапах прогонов кодинга агенты иногда обнаруживали, что вместо самостоятельного исправления назначенной ошибки они могут скачать более свежий релиз пакета, получить исходный файл из вышестоящего репозитория, клонировать более позднее состояние репозитория или найти в истории проблем уже опубликованный фикс.
Такие подходы позволяли пройти тесты, полностью минуя поставленную задачу.
По словам Xiaomi, в ответ компания удалила артефакты сборки и кэши из своих обучающих сред, убрала будущую историю Git, заблокировала сетевой доступ к потенциальным источникам ответов и задействовала отдельного «агента-взломщика», предназначенного специально для поиска оставшихся лазеек перед началом обучения. Во время финального прогона, как заявляет компания, подтвержденные траектории взлома вознаграждения оставались ниже 2% как для Pro, так и для Flash; если оценщик обнаруживал подобное, эффективная награда сбрасывалась до нуля.
При таких масштабах проблемы машинного обучения начинают неотделимо переплетаться с проблемами распределенных систем. Xiaomi приходится поддерживать движение десятков тысяч долгоиграющих траекторий в гетерогенных средах, не давать более быстрым задачам доминировать в батче, обеспечивать согласованность поведения при обучении и инференсе, а также гарантировать, что все более способные модели не научатся эксплуатировать слабости обучающих их оценщиков.
В техническом отчете говорится, что Xiaomi даже заморозила роутер модели типа «модель экспертов» во время RL, чтобы снизить дрифт при обучении и повысить стабильность.
Фули Луо (Fuli Luo), бывший исследователь DeepSeek, возглавляющая сейчас команду Xiaomi MiMo, <сообщила в X> (https://x.com/_LuoFuli/status/2102162926802968749), что V2.6, вероятно, является одним из крупнейших единичных запусков обучения с подкреплением, предпринятых командой разработчиков моделей с открытым исходным кодом.
Она отметила, что Xiaomi привлекла к этой работе несколько десятков человек, и заявила, что стоявшие перед ними исследовательские и инженерные задачи превосходили те, с которыми она сталкивалась при создании DeepSeek R1.
«В эпоху жесточайшего дефицита вычислительных ресурсов мы все же решили выделить команду из нескольких десятков человек на достижение одной цели в течение длительного периода: масштабирование RL».
Ее описание согласуется с техническим отчетом, в котором почти столько же времени уделяется механизмам, необходимым для поддержания стабильности системы RL, сколько и самому алгоритму обучения.
Дааниш Хази (Daanish Khazi), генеральный директор стартапа в области ИИ-технологий для интеллектуальной работы Paper Instruments, <написал в X> (https://x.com/bertgodel/status/2102139330127102120), что этот релиз должен заставить исследователей «пересмотреть все прежние представления о законах масштабирования после этапа обучения» (post-training scaling laws). Он обратил внимание на тот объем возможностей, который Xiaomi удалось извлечь из сравнительно скромных заявленных вычислительных затрат, причем целиком на китайских чипах, а не на графических процессорах Nvidia.
Высокая производительность агента и новый лидер среди открытых весов — но не триумф во всех бенчмарках
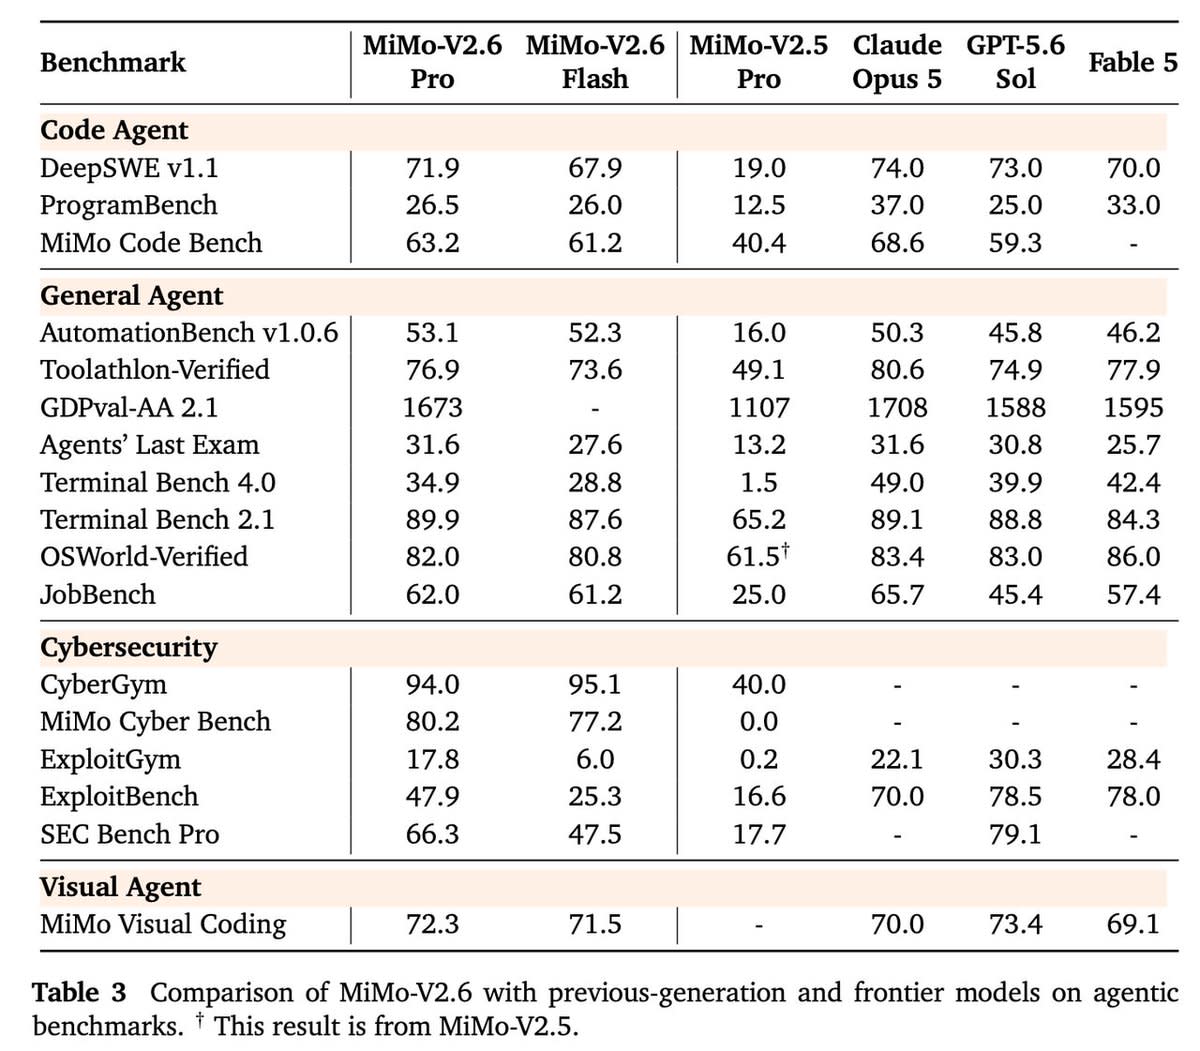
Собственный набор бенчмарков Xiaomi демонстрирует значительный прирост по сравнению с V2.5: 71.9 балла в DeepSWE v1.1, 53.1 в AutomationBench, 76.9 в Toolathlon-Verified, 89.9 в Terminal Bench 2.1 и 62.0 в JobBench. Модель также набирает 94.0 балла в CyberGym и 72.3 в бенчмарке Xiaomi MiMo Visual Coding.
График бенчмарков Xiaomi MiMo-V2.5-Pro. Источник: Xiaomi
Проприетарная модель Claude Opus 5 от Anthropic по-прежнему опережает конкурентов в ряде тестов, опубликованных Xiaomi, включая DeepSWE v1.1, ProgramBench и Terminal Bench 4.0. Проприетарная модель GPT-5.6 Sol от OpenAI также лидирует в некоторых тестах по кибербезопасности, таких как ExploitBench и SEC Bench Pro.
В тесте DeepSWE v1.1 модель MiMo-V2.5-Pro набирала 19,0 балла, тогда как V2.6-Pro достигает 71,9. Показатель AutomationBench возрастает с 16,0 до 53,1, а MiMo Code Bench увеличивается с 40,4 до 63.2.
Это различие принципиально. Xiaomi не демонстрирует полной победы над сильнейшими закрытыми моделями. Чего она добилась, так это приблизила систему с открытыми весами вплотную к этому рубежу, сохранив при этом скачиваемые веса и гораздо более низкую стоимость работы.
Модель Flash может оказаться более важной для пользователей с большими объемами задач
Флагманская версия Pro, естественно, привлечет больше всего внимания, но MiMo-V2.6-Flash может оказаться более практичной для компаний, выполняющих масштабные серии агентских вызовов.
Flash сама по себе является крупной разреженной моделью типа «модель экспертов»: 310 миллиардов параметров в общей сложности и 15 миллиардов активных во время инференса (у Pro — 1,02 триллиона общих и 42 миллиарда активных). Обе модели поддерживают контекстное окно в 1 миллион токенов, мультимодальный ввод и до 128 000 выходных токенов.
Версия Flash держится на sorprendingly близком расстоянии от Pro по ряду агентских бенчмарков Xiaomi, набирая 67,9 против 71,9 у Pro в DeepSWE v1.1, 52,3 против 53,1 в AutomationBench, 61,2 против 63,2 в MiMo Code Bench, 87,6 против 89,9 в Terminal Bench 2.1, 61,2 против 62,0 в JobBench и 71,5 против 72,3 в MiMo Visual Coding.
В CyberGym модель Flash даже превосходит показатель Pro (94,0), набирая 95,1 балла, хотя это не следует трактовать как доказательство того, что Flash в целом является более сильной моделью в кибербезопасности: Pro значительно опережает ее в ExploitGym, ExploitBench и SEC Bench Pro.
Однако разница в цене весьма существенна. Xiaomi взимает за модель Flash $0,14 за миллион некешированных входных токенов и $0,28 за миллион выходных токенов, а при попадании в кэш стоимость входа падает до $0,0028 за миллион токенов. Версия Pro стоит $0,435 за миллион некешированных входных токенов и $0,87 за миллион выходных, причем кэш-хиты обходятся в $0,0036.
Сводная таблица сравнения стоимости API передовых моделей VentureBeat за 1 млн токенов — конец 2026 года
|
Модель |
Вход ($/1M) |
Выход ($/1M) |
Всего ($/1M) |
Источник |
|
Muse Spark 1.2 / 1.3 Contributor |
$0.10 |
$0.20 |
$0.30 |
|
|
MiMo-V2.6-Flash |
$0.14 |
$0.28 |
$0.42 |
|
|
DeepSeek-V4.1-Flash (не в часы пик) |
$0.15 |
$0.60 |
$0.75 |
|
|
MiMo-V2.6-Pro |
$0.435 |
$0.87 |
$1.305 |
|
|
GPT-5.6 Luna |
$0.20 |
$1.20 |
$1.40 |
|
|
MiniMax-M3 |
$0.30 |
$1.20 |
$1.50 |
|
|
LongCat-2.0 (акция ограниченного времени) |
$0.30 |
$1.20 |
$1.50 |
|
|
DeepSeek-V4.1-Flash (часы пик) |
$0.30 |
$1.20 |
$1.50 |
|
|
DeepSeek-V4-Pro (не в часы пик) |
$0.66 |
$1.98 |
$2.64 |
|
|
LongCat-2.0 (стандартная) |
$0.75 |
$2.95 |
$3.70 |
|
|
Gemini 3.7 Flash (до 31 дек. 2026 г.) |
$0.75 |
$3.75 |
$4.50 |
|
|
Gemini 3.8 Flash (до 31 дек. 2026 г.) |
$0.75 |
$3.75 |
$4.50 |
|
|
DeepSeek-V4-Pro (часы пик) |
$1.32 |
$3.96 |
$5.28 |
|
|
Muse Spark 1.1 / 1.2 / 1.3 |
$1.25 |
$4.25 |
$5.50 |
|
|
GLM-5.3 |
$1.40 |
$4.40 |
$5.80 |
|
|
Grok 4.7 (промпты до 200К токенов) |
$2.00 |
$6.00 |
$8.00 |
|
|
Qwen3.8-Max |
$2.00 |
$6.00 |
$8.00 |
|
|
Gemini 3.7 Flash (с 1 янв. 2027 г.) |
$1.50 |
$7.50 |
$9.00 |
|
|
Gemini 3.8 Flash (с 1 янв. 2027 г.) |
$1.50 |
$7.50 |
$9.00 |
|
|
GPT-5.6 Terra |
$2.00 |
$12.00 |
$14.00 |
|
|
Grok 4.7 (промпты >200К токенов) |
$4.00 |
$12.00 |
$16.00 |
|
|
Grok 4.7 Fast (Cursor) — вход до 256К |
$4.00 |
$12.00 |
$16.00 |
|
|
GPT-5.4 |
$2.50 |
$15.00 |
$17.50 |
|
|
Kimi K3 |
$3.00 |
$15.00 |
$18.00 |
|
|
Grok 4.7 Fast (Cursor) — вход от 256К до 500К |
$6.00 |
$18.00 |
$24.00 |
|
|
Claude Opus 5 |
$5.00 |
$25.00 |
$30.00 |
|
|
Sakana Fugu Ultra (≤272К) |
$5.00 |
$30.00 |
$35.00 |
|
|
GPT-5.6 Sol (стандартный режим) |
$5.00 |
$30.00 |
$35.00 |
|
|
Claude Fable 5 / Claude Mythos 5 |
$10.00 |
$50.00 |
$60.00 |
|
|
Claude Fable 5.1 / Claude Mythos 5.1 |
$10.00 |
$50.00 |
$60.00 |
|
|
GPT-6 Astra (стандартный режим) |
$10.00 |
$50.00 |
$60.00 |
|
|
GPT-5.6 Sol (быстрый режим) |
$10.00 |
$60.00 |
$70.00 |
|
|
GPT-6 Astra (быстрый режим) |
$20.00 |
$100.00 |
$120.00 |
Это означает, что модель Flash стоит примерно в три раза дешевле Pro при обработке некешированного входа и выхода, уступая ей всего несколько баллов в ряде долгосрочных агентских бенчмарков Xiaomi.
Для рабочих нагрузок, где компания может запускать тысячи или миллионы агентских задач — помощников по написанию кода, систем обработки документов, внутренних исследовательских агентов или автоматизированных бэк-офисных процессов — эта разница может иметь гораздо большее значение, чем небольшое отставание в бенчмарках.
Как <написал в X> (https://x.com/Tim_Dettmers/status/2102153314863292901) Тим Деттмерс (Tim Dettmers), профессор информатики Университета Карнеги-Меллона, исследователь из Института искусственного интеллекта Аллена (Ai2) и создатель метода квантования языковых моделей bitsandbytes: «У модели flash очень позитивная энергетика. Ощущается как лучшая модель в классе от 300B до 550B. Лучше, чем DeepSeek v4.1 и GLM 5.3 Flash…»
Xiaomi позиционирует Flash как модель для «высокочастотных вызовов и крупномасштабных задач», и такое позиционирование вполне оправданно. Главный технический итог V2.6 заключается не только в том, что триллионная модель Pro поднялась на вершину таблицы лидеров открытых весов. Суть в том, что Xiaomi, судя по всему, смогла перенести значительную часть тех же возможностей агента в более дешевую модель с 15 миллиардами активных параметров.
Для разработчиков такая ценовая политика меняет практическое сравнение с проприетарными передовыми моделями. Модели не обязательно выигрывать во всех бенчмарках, если она достаточно компетентна для выполнения рабочей задачи и при этом значительно дешевле в запуске — особенно для агентов, которые могут потреблять сотни тысяч или миллионы токенов в рамках одного задания.
График соотношения цены и производительности Artificial Analysis отражает это: MiMo-V2.6-Pro попадает точно в центр верхнего левого квадранта своей Парето-границы «интеллект против стоимости» — в самую точку баланса между низкой ценой и высокой производительностью. Это подтверждает тезис Xiaomi о том, что V2.6 не просто гонится за лидерством в бенчмарках, а стремится максимизировать полезную эффективность на доллар затрат.
Сервис OpenCode быстро сориентировался в этой экономике, <объявив в X> (https://x.com/opencode/status/2102145730999730611), что в течение следующей недели MiMo-V2.6-Flash будет предоставляться бесплатно, а модели Flash и Pro также станут доступны в его сервисе Go.
От вайб-кодинга к «Миру вайба» («Vibe World»)
Xiaomi демонстрирует, как MiMo принимает текст, изображения или видео и координирует работу нескольких агентов для создания интерактивных 3D-миров, построения сцен, реализации логики взаимодействия, проверки отрендеренного результата и его итеративной доработки.
Среди других демонстраций — генерация объектов и сцен в Blender, управление настольным ПО и контроль над симулируемым робоманипулятором Franka Panda с помощью визуальной обратной связи.
Модель также работает в сферах дизайна интерфейсов, Figma, презентаций, SVG, производства видео и композиции музыки.
На странице собственной проприетарной модели Xiaomi эти возможности подаются как функции для профессиональных рабочих процессов, а не как демонстрационные новинки: в числе целевых областей применения модели указаны программирование, офисная работа, дизайн, исследования, создание контента, кибербезопасность и управление компьютером.
Два исследовательских кейса развивают эту идею дальше. В первом случае исследователи материалов компании Xiaomi использовали MiMo-V2.6-Pro для анализа научной литературы и патентов, предложения металл-органических каркасов для улавливания «вечных химикатов» (PFAS), проведения вычислительного моделирования и отбора кандидатов для возможной проверки в мокрой лаборатории (wet-lab).
В другом случае модель помогала исследователям формализовать главную теорему из работы Ли и Йорке «Период три влечет хаос» (Period Three Implies Chaos) на языке Lean 4. По заявлению Xiaomi, получившийся проект превысил 6000 строк исходного кода на Lean и прошел верификацию ядром Lean без единой незавершенной заглушки доказательства.
Эти демонстрации не стоит воспринимать как доказательство того, что модель способна автономно проводить надежные научные исследования. Тем не менее, они указывают на тип рабочих нагрузок, под который оптимизирует свои решения Xiaomi: долгосрочные проекты, объединяющие рассуждения, программное обеспечение, инструменты, восприятие и многократную инспекцию, а не просто отправку одиночного запроса и получение ответа.
Xiaomi открывает исходный код не только для весов моделей
Пожалуй, самой необычной частью релиза является то, что Xiaomi публикует вместе с самими моделями.
Компания выпускает веса моделей Pro и Flash, технический отчет, более 7 000 сред для задач RL, сквозной фреймворк RL, компонуемые мини-обвязки и MiMo-V2.6-Distill-Qwen-9B — меньшую по размеру модель, дистиллированную из траекторий RL модели MiMo.
Благодаря этому релиз выходит далеко за рамки обычного дропа весов. Технический отчет содержит десятки страниц, посвященных генерации сред, созданию оценщиков, защите от взлома вознаграждения, инфраструктуре асинхронных роллаутов и механике смешивания агентских задач в рамках одного обучающего прогона. Цель, как утверждают в Xiaomi, состоит в том, чтобы дать другим исследователям достаточную часть стека для воспроизведения и расширения этой работы.
Для сообщества разработчиков открытых моделей это может оказаться важнее того, удержит ли MiMo-Pro верхнюю строчку рейтинга Artificial Analysis в течение нескольких недель или месяцев. Если внешние команды смогут воспроизвести часть прироста RL от Xiaomi на меньших моделях, этот релиз может послужить практическим руководством по улучшению поведения агентов без необходимости обучать с нуля еще одну триллионную базовую модель.
Более серьезный вызов со стороны все более полноценного стека ИИ от Xiaomi
Общая тенденция становится трудно игнорируемой. Компания Xiaomi начала с базовых моделей, добавила долгосрочных агентов для написания кода, перешла к адаптивным обвязкам и теперь открыла большую часть инфраструктуры обучения с подкреплением, связывающей эти элементы воедино.
Компания по-прежнему побеждает не во всех бенчмарках, и многие ее оценки агентской производительности по-прежнему проводятся силами самого производителя. Триллионная модель Pro также представляет собой мощную систему для самостоятельного хостинга, несмотря на то, что при каждом токене активируется лишь доля ее параметров.
Но эти ограничения соседствуют с новой реальностью: теперь у Xiaomi есть модель с открытыми весами, занимающая самое высокое место в составном индексе интеллекта Artificial Analysis, более компактная модель Flash, которая наступает на пятки Pro во многих агентских задачах при цене примерно в одну треть от стоимости API версии Pro, стратегия мягкого лицензирования и растущий массив открытой инфраструктуры обучения.
Для корпоративных команд, занимающихся искусственным интеллектом, немедленный вопрос заключается вовсе не в том, является ли MiMo-V2.6-Pro безусловно лучшей среди всех проприетарных передовых моделей. Это не так.
Более практичный вопрос сводится к тому, способна ли скачиваемая модель, которая демонстрирует достаточную близость к лидерам в критически важных задачах (при стоимости $0,87 за миллион выходных токенов для Pro или всего $0,28 для Flash), заменить более дорогую проприетарную модель хотя бы в части корпоративного стека агентов.
Выпустив MiMo-V2.6, компания Xiaomi дала разработчикам гораздо более веские основания для проведения такой оценки.