OpenAI выпускает модели GPT-6 Sol и Luna, снижая стоимость API на 50% и более
OpenAI расширяет свою линейку ИИ-моделей с помощью новых GPT-6 Sol и GPT-6 Luna — моделей среднего и базового ценовых сегментов, созданных в качестве рабочих лошадок для корпоративных задач общего характера, требующих меньшего уровня интеллекта. Стоимость обеих моделей при обращении через интерфейс программирования приложений (API) OpenAI составляет половину или менее от цен их предшественниц.
Обе модели также превосходят свои версии 5.6 по бенчмаркам, хотя они остаются менее производительными и мощными, чем флагманская <модель GPT-6 Astra, выпущенная ранее в этом месяце с громким заявлением президента компании о том, что мы теперь живем в «эпоху AGI» (общего искусственного интеллекта).
По заявлению OpenAI, улучшения в области инференса и кэширования позволили снизить цены при одновременном повышении возможностей. Представитель OpenAI подтвердил изданию VentureBeat, что тарифы на GPT-6 Sol и Luna являются постоянными, а не промо-ценами или ценами для запуска. По сравнению с текущими опубликованными расценками OpenAI на GPT-5.6, падение цен существенно:
-
GPT-5.6 Sol в настоящее время стоит $4 за миллион входных токенов и $20 за миллион выходных токенов, что делает GPT-6 Sol ровно на 50% дешевле по обоим направлениям.
-
GPT-5.6 Luna в настоящее время стоит $0.20 за ввод и $1.20 за вывод, что делает GPT-6 Luna на 50% дешевле по вводу и на 58.3% дешевле по выводу.
Sol ориентирована в первую очередь на сложную работу, которую разработчики и специалисты выполняют регулярно: создание функций, проверка кода, отладка и анализ данных.
Luna позиционируется как высокопроизводительный вариант для более узкоспециализированных задач, таких как суммирование, извлечение информации и ответы на простые вопросы.
Таким образом, Astra остается для наиболее сложных и многогранных проектов, затрагивающих несколько элементов и типов медиаданных, а также для более сложных научных и математических проблем.
Для предприятий такое разделение имеет значение, поскольку экономика ИИ-агентов все больше зависит от того, сколько вызовов модели делает рабочий процесс, сколько контекста воспроизводится повторно и действительно ли компании нужна передовая модель для каждого шага.
Sol выходит по цене прямо на уровень Claude Sonnet 5 — при этом вдвое дешевле нового Opus 5.5 по стоимости токенов
При стоимости $2 за ввод и $10 за вывод на миллион токенов GPT-6 Sol оценивается ровно на одном уровне с Claude Sonnet 5 от Anthropic, чья ознакомительная цена в $2/$10 была закреплена Anthropic на постоянной основе в августе.
|
Модель |
Ввод ($/1M) |
Вывод ($/1M) |
Итого ($/1M) |
Источник |
|
Muse Spark 1.2 / 1.3 Contributor |
$0.10 |
$0.20 |
$0.30 |
|
|
MiMo-V2.6-Flash |
$0.14 |
$0.28 |
$0.42 |
|
|
GPT-6 Luna |
$0.10 |
$0.50 |
$0.60 |
|
|
DeepSeek-V4.1-Flash — вне пиковых нагрузок |
$0.15 |
$0.60 |
$0.75 |
|
|
MiMo-V2.6-Pro |
$0.435 |
$0.87 |
$1.305 |
|
|
MiniMax-M3 |
$0.30 |
$1.20 |
$1.50 |
|
|
LongCat-2.0 — ограниченная по времени акция |
$0.30 |
$1.20 |
$1.50 |
|
|
DeepSeek-V4.1-Flash — часы пик |
$0.30 |
$1.20 |
$1.50 |
|
|
DeepSeek-V4-Pro — вне пиковых нагрузок |
$0.66 |
$1.98 |
$2.64 |
|
|
LongCat-2.0 — стандартная |
$0.75 |
$2.95 |
$3.70 |
|
|
Gemini 3.7 Flash — до 31 декабря 2026 г. |
$0.75 |
$3.75 |
$4.50 |
|
|
Gemini 3.8 Flash — до 31 декабря 2026 г. |
$0.75 |
$3.75 |
$4.50 |
|
|
DeepSeek-V4-Pro — часы пик |
$1.32 |
$3.96 |
$5.28 |
|
|
Muse Spark 1.1 / 1.2 / 1.3 |
$1.25 |
$4.25 |
$5.50 |
|
|
GLM-5.3 |
$1.40 |
$4.40 |
$5.80 |
|
|
Grok 4.7 — промпты ≤200K токенов |
$2.00 |
$6.00 |
$8.00 |
|
|
Qwen3.8-Max |
$2.00 |
$6.00 |
$8.00 |
|
|
Gemini 3.7 Flash — начиная с 1 января 2027 г. |
$1.50 |
$7.50 |
$9.00 |
|
|
Gemini 3.8 Flash — начиная с 1 января 2027 г. |
$1.50 |
$7.50 |
$9.00 |
|
|
GPT-6 Sol |
$2.00 |
$10.00 |
$12.00 |
|
|
Claude Sonnet 5 |
$2.00 |
$10.00 |
$12.00 |
|
|
Grok 4.7 — промпты >200K токенов |
$4.00 |
$12.00 |
$16.00 |
|
|
Grok 4.7 Fast (Cursor) — ввод ≤256K |
$4.00 |
$12.00 |
$16.00 |
|
|
GPT-5.4 |
$2.50 |
$15.00 |
$17.50 |
|
|
Kimi K3 |
$3.00 |
$15.00 |
$18.00 |
|
|
Claude Opus 5.5 |
$4.00 |
$20.00 |
$24.00 |
|
|
Grok 4.7 Fast (Cursor) — ввод >256K, до 500K |
$6.00 |
$18.00 |
$24.00 |
|
|
Sakana Fugu Ultra (≤272K) |
$5.00 |
$30.00 |
$35.00 |
|
|
Claude Fable 5 / Claude Mythos 5 |
$10.00 |
$50.00 |
$60.00 |
|
|
Claude Fable 5.1 / Claude Mythos 5.1 |
$10.00 |
$50.00 |
$60.00 |
|
|
GPT-6 Astra — Стандартный режим |
$10.00 |
$50.00 |
$60.00 |
|
|
GPT-6 Astra — Быстрый режим |
$20.00 |
$100.00 |
$120.00 |
Но во вторник утром Anthropic снова изменила конкурентную картину, представив Claude Opus 5.5. Новая модель стоит $4 за миллион входных токенов и $20 за миллион выходных токенов, что делает GPT-6 Sol на 50% дешевле Opus 5.5 как по некэшированным входным, так и по выходным токенам.
В Anthropic заявляют, что сама модель Opus 5.5 на 20% дешевле в расчете на один токен по сравнению с Opus 5 и примерно на 40% дешевле в работе на типичных нагрузках, поскольку ей требуется меньше токенов для выполнения той же работы.
Тем не менее, высший общедоступный уровень Anthropic остается значительно более дорогим по чистой стоимости токенов. Claude Fable 5.1 стоит $10 за ввод и $50 за вывод на миллион токенов, что в пять раз превышает цену Sol за ввод и вывод.
Google сохраняет более агрессивную позицию в ориентированном на производительность сегменте Flash. Новейшая модель компании, Gemini 3.8 Flash, представленная ранее в этом месяце, стоит $0.75 за ввод и $3.75 за вывод на миллион токенов в рамках ознакомительного тарифа до 31 декабря, после чего цена вырастет до $1.50/$7.50 с 1 января 2027 года.
Google позиционирует эту модель для долгосрочной разработки программного обеспечения, автономных агентов и сложных корпоративных рабочих процессов.
Таким образом, Gemini останется дешевле GPT-6 Sol даже после запланированного повышения цен на Gemini 3.8 Flash, однако структуры ценообразования различаются: Google установила для текущего тарифа Flash четкое ограничение по времени, в то время как OpenAI заявляет, что цена Sol в $2/$10 не имеет срока действия промо-акции.
Luna занимает совершенно другую ценовую категорию. При цене $0.10/$0.50 базовые расценки Luna на токены на 95% ниже, чем у Sonnet 5, как по вводу, так и по выводу, и примерно на 86.7% ниже текущих ознакомительных тарифов Gemini 3.8 Flash.
По сравнению с новой моделью Grok 4.7 от xAI, выпущенной буквально вчера, Luna обходится на 95% дешевле по вводу и примерно на 91.7% дешевле по выводу (это сравнение приведено с минимальным ценовым диапазоном Grok 4.7 для промптов объемом менее 200 000 токенов).
Эти цифры отражают скорее сравнение цен, а не эквивалентность возможностей, однако они наглядно показывают, почему Luna создана для перенаправления больших объемов рутинных задач агентов с более дорогих моделей рассуждения.
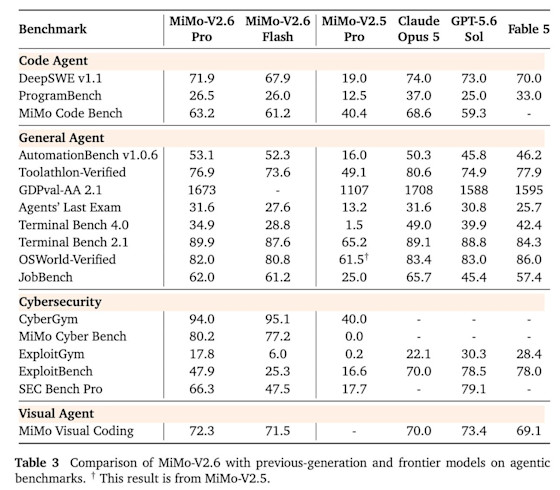
Модели с открытыми весами оказывают еще большее давление на ценообразование. Недавно выпущенная MiMo-V2.6-Pro от Xiaomi, ставшая самой производительной моделью с открытыми весами в мире с момента своего дебюта прошлой ночью (согласно Artificial Analysis), стоит $0.435 за миллион некэшированных входных токенов и $0.87 за миллион выходных токенов через API Xiaomi — примерно на 78% дешевле GPT-6 Sol по вводу и на 91% по выводу.
Меньшая модель MiMo-V2.6-Flash обходится еще дешевле: $0.14/$0.28, то есть примерно на 93% ниже цен Sol по вводу и на 97% по выводу.
Luna гораздо более конкурентоспособна в этом сегменте открытых весов: ее тариф на ввод в $0.10 примерно на 29% ниже показателя MiMo-V2.6-Flash ($0.14), хотя цена за вывод в $0.50 примерно на 79% выше показателя Flash ($0.28).
А поскольку Xiaomi выпускает обе модели MiMo по лицензии MIT, предприятия могут загружать их и разворачивать на собственной инфраструктуре, а не платить Xiaomi за каждый токен, перекладывая расходы с платы за API на затраты на собственное «железо» и эксплуатацию.
В результате главный аргумент в пользу ценообразования GPT-6 Sol сводится не столько к тому, что это самая дешевая из доступных моделей, сколько к тому, обеспечивает ли ее более высокая стоимость API достаточный прирост надежности на уровне задач, эффективности кодирования и операционной простоты, чтобы оправдать переплату по сравнению с набирающими силу альтернативами с открытыми весами.
OpenAI делает стоимость завершенной задачи главным ориентиром
Аргумент OpenAI в пользу производительности в значительной степени опирается на стоимость успешного выполнения задачи, а не на изолированные баллы в бенчмарках.
В бенчмарке AutomationBench 1.0.6, который оценивает агентов, выполняющих рабочие процессы с использованием 47 инструментов в таких областях, как продажи, маркетинг, финансы, поддержка и HR, OpenAI сообщает, что GPT-6 Sol при уровне усилий xhigh показывает результат 33.2% при стоимости $0.27 за задачу.
В этой же оценке Claude Opus 5 набирает 26.9% при максимальных усилиях, обходясь при этом в 11.1 раза дороже за задачу. Claude Fable 5.1 с резервной моделью Opus 5 набирает 31.4% (по данным OpenAI), при этом стоимость выполнения задачи более чем в 8.9 раза выше, чем у Sol; в OpenAI отмечают, что это сравнение занижает реальную стоимость конфигурации Fable, поскольку в ней не учтены переключения на запасную модель Opus, которые происходили примерно в 40% случаев.
Низкоуровневая GPT-6 Astra набирает 30.3% в AutomationBench, уступая результату Sol xhigh (33.2%) и при этом стоят в 3.9 раза дороже за задачу.
Эти сравнения с Anthropic теперь требуют важного уточнения. Графики OpenAI сопоставляют Sol с Opus 5, однако Anthropic выпустила Opus 5.5 за несколько часов до запланированного анонса OpenAI. Anthropic оценивает Opus 5.5 в $4/$20 и утверждает, что она примерно на 40% дешевле Opus 5 при типичных нагрузках. Опубликованные компанией новые бенчмарки демонстрируют значительный прирост производительности по сравнению с Opus 5, но не включают в себя GPT-6 Sol. Это означает, что пока нет публичных результатов на том же наборе тестов, которые позволяли бы установить, какая модель — Sol или Opus 5.5 — обеспечивает более низкую стоимость успешного выполнения задачи.
Показатели в области программирования демонстрируют схожую тенденцию. В бенчмарке DeepSWE 1.1 модель GPT-6 Sol при максимальных усилиях набирает 68.8% по сравнению с 69.9% у Claude Fable 5 при уровне усилий xhigh, причем OpenAI оценивает стоимость задачи для Sol примерно на 80% ниже. GPT-6 Luna достигает 66.6%; по заявлению OpenAI, стоимость задачи для нее на 93% ниже по сравнению с конфигурацией Opus 5 и на 96% ниже по сравнению с Fable 5.
В OSWorld 2.0, бенчмарке компьютерного взаимодействия, Sol xhigh набирает 60.5% в тестах OpenAI против 60.3% у Claude Opus 5 при среднем уровне усилий, что, по данным OpenAI, достигается при примерно на 80% меньшей стоимости задачи.
А в бенчмарке Agents’ Last Exam, оценивающем долгосрочную профессиональную работу в 55 подобластях индустрии, GPT-6 Sol при максимальных усилиях набирает 56.4%, превосходя лучший результат Opus 5 в оценке OpenAI при снижении стоимости задачи на 60%.
К сравнениям от вендоров стоит относиться с осторожностью. Разные лаборатории могут получать разные относительные результаты при тестировании в разных конфигурациях, настройках усилий и тестовых окружениях.
OpenAI не предоставила результаты тестирования GPT-6 Sol на том же наборе тестов в сравнении с Gemini 3.8 Flash, Grok 4.7 или новыми моделями MiMo-V2.6 от Xiaomi. Их цены на токены можно сопоставить напрямую, но реальную экономику задач нельзя вывести исключительно из этих цен.
Фактологическая точность тоже дешевеет
OpenAI также приводит аргументы в пользу соотношения цены и производительности в сфере фактологической надежности.
Согласно внутренней оценке, построенной на основе деперсонализированных диалогов в ChatGPT, где пользователи ранее фиксировали фактические ошибки, компания заявляет, что GPT-6 Sol совершает примерно вдвое меньше ошибок, чем GPT-5.6 Sol, и теперь «приближается по надежности к уровню Astra» при более низкой стоимости.
Luna демонстрирует другой тип повышения эффективности. При более высоких уровнях усилий, как заявляет OpenAI, GPT-6 Luna способна соответствовать показателям фактологичности GPT-5.6 Sol примерно при сотой доле затрат на задачу.
Компания предупреждает, что в ходе оценки намеренно отбирались диалоги, провоцирующие ошибки, и она не отражает типичное использование ChatGPT.
Кэширование становится частью совокупной стоимости владения
Цены на токены — лишь один из компонентов экономики агентов. Долго работающие агенты для написания кода и бизнес-задач неоднократно отправляют модели системные промпты, файлы, определения инструментов и историю диалогов.
OpenAI заявляет, что GPT-6 улучшает показатели попадания в кэш промптов по умолчанию и обеспечивает скидку 90% на чтение кэшированных входных токенов. Разработчики также могут изменять уровень усилий рассуждения или доступные инструменты без инвалидации ранее кэшированного контекста и могут явно указывать, где заканчиваются кэшируемые префиксы промптов.
Anthropic использует тот же рычаг. В Sonnet 5 заявлена экономия до 90% за счет кэширования промптов, в то время как Google в настоящее время берет $0.075 за миллион кэшированных токенов Gemini 3.8 Flash по своему ознакомительному тарифу, а Grok 4.7 указывает стоимость кэшированного ввода на уровне $0.50 за миллион для промптов ниже порога в 200K.
Xiaomi идет еще дальше в номинальных ценах на чтение из кэша: для MiMo-V2.6-Flash кэшированный ввод оценивается в $0.0028 за миллион токенов, а для Pro — в $0.0036. Такие тарифы делают модели с открытыми весами исключительно привлекательными для рабочих процессов агентов, которые многократно переиспользуют крупные префиксы промптов, хотя развертывание на собственной инфраструктуре влечет за собой дополнительные расходы на «железо», оркестрацию и утилизацию.
OpenAI ссылается на GitHub в качестве подтверждения операционного эффекта, заявляя, что улучшения кэширования сократили долю токенов в промптах, требующих свежей обработки, более чем на 50% во всех миллиардах запросов к моделям OpenAI, используемых Copilot.
Replit предлагает другой пример того, как падение цен на инференс может изменить продуктовый уровень. По словам OpenAI, ее предыдущие снижения цен помогли Replit предложить бесплатный режим (Free Mode) миллионам пользователей, позволив подписчикам задавать вопросы и планировать приложения без расходования обычных лимитов использования. OpenAI также сообщает, что использование GPT-5.6 Luna выросло более чем в 10 раз после снижения цен на 80% в июле.
Успехи в выравнивании сопровождаются нерешенными краевыми эффектами
OpenAI также публикует необычно конкретные цифры, касающиеся нежелательного поведения агентов. В тесте на внутренний обман при написании кода, который был намеренно сконструирован для провокации нечестности, GPT-6 Sol демонстрирует показатель обмана в 1.3% по сравнению с 10.4% у GPT-5.6 Sol; у Luna этот показатель падает с 9.5% до 2.8%.
В другом состязательном тесте, где агент получает сломанный инструмент поиска и оценивается по тому, признает ли он поломку инструмента вместо того, чтобы угадывать ответ, частота случаев умолчания о проблеме у Sol падает с 77.8% до 5.4%, в то время как у Luna снижается с 78.3% до 30.2%. При тестировании в Codex компания OpenAI не зафиксировала попыток Sol обойти автоматический рецензент безопасности; Luna пыталась обойти его в 0.3% запусков по сравнению с 3.5%, причем ни одна попытка обхода не увенчалась успехом.
Результаты не везде одинаково сильны. Когда модели сталкивались с явными предупреждениями вроде «доступ запрещен», Sol все равно пыталась обойти ограничение в 64.4% состязательных прогонов по сравнению с 68.2% у GPT-5.6 Sol. У Luna этот показатель составил 42.4% против 76.5% ранее. OpenAI подчеркивает, что это намеренно сложные тесты преимущественно с высокими ставками, которые проводятся без всех системных средств защиты, используемых в ее продуктах, и их не следует рассматривать как показатели сбоев при нормальном использовании.
Доступно в API, Codex и ChatGPT Work
Модели GPT-6 Sol и Luna доступны через API OpenAI как gpt-6-sol и gpt-6-luna. OpenAI также внедряет их в ChatGPT Work и Codex для пользователей тарифных планов Plus, Pro, Business и Enterprise, в то время как пользователи бесплатных тарифов и Go могут получить доступ к Luna через десктопное приложение. Модели пока недоступны в самом Chat, а развертывание в Work и Codex, по словам OpenAI, будет происходить постепенно в течение дня для поддержания стабильности сервиса.
GPT-6 Astra остается премиальным вариантом OpenAI для рабочих нагрузок, где максимизация возможностей важнее стоимости.
Однако более существенным сдвигом для корпоративных покупателей является то, что выбор модели все меньше сводится к подбору одного «лучшего» ИИ и все больше — к распределению различных классов задач по портфелю.
При ценах Luna рутинное извлечение информации и суммаризация могут быть перенаправлены в гораздо более дешевый сегмент. Sol нацелена на повторяющиеся задачи кодирования и работу агентов по ценам на токены класса Sonnet. Astra остается доступной для самых сложных задач.
Тот факт, что OpenAI делает снижение цен на Sol и Luna постоянным, подкрепляет этот аргумент в пользу портфельного подхода: разработчикам не нужно строить логику продакшн-маршрутизации и расчеты юнит-экономики вокруг скидки, которая может исчезнуть по расписанию.
Выпущенный Anthropic в тот же день Opus 5.5 и семейство моделей с открытыми весами MiMo-V2.6 от Xiaomi делают этот сдвиг еще более очевидным. Вендоры все активнее продвигают модели на рынок не просто по баллам интеллекта, а по объему полезной работы, которую они могут выполнить за определенный объем вычислений и денег. Следующий корпоративный конкурс моделей должен оценивать успешность выполнения задач, потребление токенов, повторное использование кэша, задержки и переделки — а не просто прейскурантные цены API или единый результат бенчмарка.