Почему искусственный интеллект не должен заниматься восстановлением ваших потоков данных
Источник: VentureBeat · Shashank Akinapalli


Когда микросервис дает сбой в облачно-нативной архитектуре, срабатывают автоматические выключатели (circuit breakers), трафик перенаправляется, и Kubernetes за секунды запускает резервные модули (поды). Система восстанавливается еще до того, как конечные пользователи успеют заметить неполадку.
Тем не менее, внутри корпоративных пайплайнов данных режимы отказов остаются на удивление хрупкими. Незаметное, несогласованное изменение вышестоящего API превращает тип поля из целого числа в строку; сторонний поставщик обновляет схему ровно в полночь; или задание ETL завершается успешно, тихо отбрасывая 15% полезной нагрузки. Ниже по цепочке руководящие дашборды отображают неточные показатели доходов, отчетность перед регуляторами рушится, а финансовые механизмы принятия решений действуют на основе поврежденных входных данных.
За последние несколько лет индустрия сплотилась вокруг «самовосстанавливающихся пайплайнов данных» как священного Грааля надежности данных. Но по мере того, как корпоративные объемы данных расширяются в многооблачных средах, а организации развертывают автономных ИИ-агентов, принимающих оперативные решения в реальном времени, простого самовосстановления уже недостаточно.
Для поддержки нового поколения корпоративного ИИ мы должны перейти от реактивного автоматизированного ремонта к Автономному управлению данными и устойчивой инфраструктуре.
Невидимое «узкое горлышко» в масштабных трансформациях
Руководя многолетними трансформациями корпоративных данных в ведущих банковских учреждениях, медицинских сетях и общенациональных дистрибьюторских экосистемах, включая сложные среды в USAA, Health Care Service Corporation (HCSC), Blue cross Blue Shield Kansas (BCBS KC) и United Natural Foods (UNFI), я наблюдал общую структурную проблему: скорость обработки данных опередила традиционное управление.
При миграции устаревших локальных хранилищ данных на современные облачные платформы (такие как Snowflake, dbt и облачные озера) команды часто переносят старые предположения. Они строят более быстрые пайплайны, но не делают их умнее.
В крупномасштабных операциях, таких как управление лимитами по кредитам для миллионов банковских клиентов или оптимизация складских запасов в сотнях дистрибьюторских центров, сбои данных редко проявляются в виде четких и резких остановок. Вместо этого они выглядят как скрытая деградация:
-
Дрифт схем: вышестоящие исходные системы эволюционируют, не сообщая аналитическим движкам о критических изменениях.
-
Семантическое повреждение: данные поступают вовремя и в правильном формате, но примененная к ним бизнес-логика перестает соответствовать текущим операциям.
-
Отсутствие прозрачности (Lineage darkness): команды знают, где произошел сбой пайплайна, но не могут отследить, какие нижестоящие модели, отчеты или нормативные документы были скомпрометированы этой ошибкой.
Три столпа автономной устойчивости данных
Чтобы решить эту проблему, современные лидеры в области инженерии данных должны изменить свою архитектурную философию. Надежность нельзя просто прикрутить на уровне отчетности; она должна быть встроена непосредственно в механизм выполнения.
Предоставлено автором
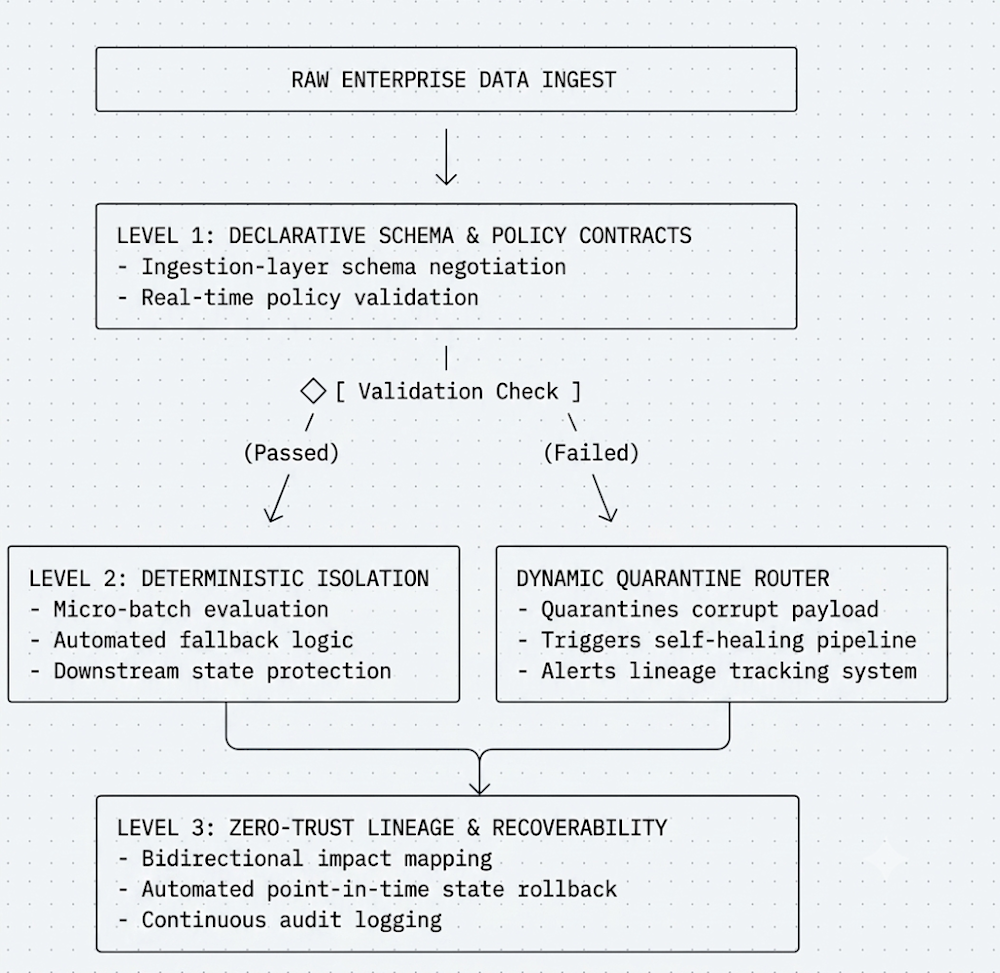
1. Декларативные контракты данных с динамическим согласованием
Традиционный ETL опирается на жестко зашитые предположения. Если поле меняется, задание падает. Устойчивая архитектура использует декларативные контракты данных, которые применяются непосредственно в точке приема.
Когда исходные системы пытаются передать данные, нарушающие ожидаемые схемы или бизнес-правила, платформа не просто падает или молча принимает некорректные записи. Она динамически согласовывает полезную нагрузку, отправляя аномальные записи в изолированные карантинные зоны, в то время как валидные данные беспрепятственно поступают дальше по цепочке.
2. Детерминированное исправление вместо эвристических догадок
Хотя обнаружение аномалий на базе ИИ полезно для отправки предупреждений, автоисправление в критически важных средах должно оставаться детерминированным. Если автоматизированный скрипт пытается «угадать», как исправить отсутствующий первичный ключ в финансовых или медицинских записях, он рискует внести синтетические ошибки в проверяемые системы.
Автономное управление сочетает обнаружение аномалий на основе машинно обучения с предопределенными, управляемыми политикой рабочими процессами исправления. Если пайплайн сталкивается с неожиданным дрифтом, система изолирует пакет, применяет историческую резервную логику и предупреждает инженерные команды, предоставляя предварительно вычисленный анализ первопричин.
3. Управление происхождением данных на основе нулевого доверия (Zero-trust)
В современных корпоративных архитектурах происхождение (lineage) данных должно работать на основе принципа нулевого доверия. Каждый шаг трансформации данных должен явно проверять происхождение, показатель качества и классификацию безопасности набора данных перед передачей его на следующий этап.
Если показатель качества набора данных падает ниже заранее установленного порога, нижестоящие зависимости (такие как ориентированные на клиента рекомендательные модели или дашборды соответствия требованиям) автоматически приостанавливают обновления или переключаются на кэшированные, проверенные векторы состояния до тех пор, пока аномалия не будет урегулирована.
Стратегия руководства: Масштабирование технологий через масштабирование стандартов
Архитектурные паттерны эффективны ровно настолько, насколько хороша инженерная культура, которая их реализует. Будучи членом жюри престижных мировых технологических премий, таких как TITAN Innovation Awards и TITAN Business Awards, а также оценив более 20 глобальных технологических конкурсов, я часто анализирую корпоративные системы, заявляющие об использовании передового ИИ и архитектур данных.
Разница между организациями, достигшими истинной операционной гибкости, и теми, что увязли в техническом долге, всегда сводится к стандартам и строгости:
-
Относитесь к пайплайнам как к распределенным программным продуктам: применяйте к данным строгие принципы программной инженерии, включая модульность, автоматизированное тестирование, непрерывную интеграцию (CI/CD) и инфраструктуру с контролем версий (Infrastructure as Code).
-
Отделите управление (governance) от исполнения: предоставьте инженерным командам возможность создавать фреймворки самообслуживания для управления данными, которые позволят доменным командам безопасно развертывать пайплайны без создания централизованных «узких мест».
-
Измеряйте то, что имеет значение: откажитесь от поверхностных метрик вроде общего объема сохраненных данных или количества построенных пайплайнов. Отслеживайте среднее время обнаружения (MTTD), среднее время восстановления (MTTR) для сбоев пайплайнов и индекс качества данных (DQI) для критически важных корпоративных активов.
Путь вперед
Поскольку предприятия переходят от пассивной аналитики к активным рабочим процессам на базе ИИ, надежность данных перестает быть просто метрикой ИТ-обслуживания — она становится ключевым бизнес-риском.
Создавая системы, которые не просто сообщают о поломке, но активно защищают, изолируют и устраняют проблемы с качеством данных в реальном времени, лидеры в области корпоративных данных могут обеспечить тот непоколебимый фундамент, который необходим в эпоху ИИ.
Шашанк Акинапалли (Shashank Akinapalli) — технический архитектор / старший инженер по данным и старший член IEEE.
Добро пожаловать в сообщество VentureBeat!
Наша программа гостевых публикаций — это площадка, где технические эксперты делятся идеями и предлагают непредвзятый, независимый глубокий анализ ИИ, инфраструктуры данных, кибербезопасности и других передовых технологий, формирующих будущее бизнеса.
Читайте далее в рамках нашей программы гостевых публикаций — и ознакомьтесь с нашими рекомендациями, если вы хотите сами написать статью!