Исследователи Salesforce повысили успешность ИИ-агента при выполнении задач в браузере с 43,5% до 93%, не меняя саму модель
Источник: VentureBeat · Ben Dickson


Самосовершенствующиеся ИИ-агенты могут анализировать свои ошибки и изменять промпты, инструменты, навыки и рабочие процессы, окружающие базовую модель, то есть так называемый «обвязочный каркас» (harness). Однако надежно суммировать эти улучшения непросто. Правка, которая помогает в решении одной задачи, может ухудшить работу агента в другой, в то время как многократное улучшение одной версии каркаса способно завести систему в тупик, где ее развитие временно останавливается.
Новый фреймворк DarwinX от Salesforce AI Research и Salesforce Agentforce применяет к этой проблеме эволюционный подход. Вместо того чтобы непрерывно переписывать единственную версию каркаса агента, он исследует несколько альтернатив, сохраняет полезные находки и позволяет изменениям внедряться только тогда, когда они повышают производительность, не ухудшая показатели в других задачах.
Эксперименты показывают, что из этого слоя можно извлечь огромный потенциал. Исследователи сообщают, что эволюция каркаса повысила баллы агента во всех четырех протестированных ими бенчмарках: от прироста на 3,4 балла на SWE-bench Verified до скачка на 49,5 балла на WebArena-Infinity.
DarwinX изменяет исключительно каркас, никогда не затрагивая веса модели. Это делает такой подход актуальным для разработчиков приложений, которые создают продукты на базе хостинговых моделей и не имеют собственных конвейеров для дообучения или тренировки моделей.
Почему существующие циклы самосовершенствования заходят в тупик
Многие фреймворки самосовершенствующихся агентов используют ту или иную вариацию одного и того же базового цикла: запустить агента на пакете задач, изучить траектории, выявить сбои, предложить изменение в каркас и протестировать модифицированного агента на валидационном наборе или наборе для проверки регрессий.
Исследователи уже вышли за рамки простой оптимизации промптов. Например, Darwin Gödel Machine (DGM) позволяет агенту изменять собственный исходный код и ведет архив прошлых вариантов. HarnessX работает непосредственно с промптами, инструментами и управлением потоком выполнения, разделяя варианты по семействам задач во избежание взаимных помех.
Тем не менее, исследователи из Salesforce выделяют две проблемы в подобных подходах.
Первая проблема — «зависимость от траектории» (path dependence). Если каждый раунд строится на базе агента, который в данный момент выглядит наилучшим образом, ранние изменения определяют фундамент для всего последующего. Локально полезная правка может отправить эволюцию по ветке, которая в конечном итоге заходит в тупик, в то время как другая перспективная ветка оказывается заброшенной до того, как успевает развиться.
Представьте, что ранняя правка учит агента-программиста агрессивно устанавливать зависимости перед началом работы над задачей. Это устраняет несколько ошибок, поэтому данный подход становится новой отправной точкой. Каждая последующая правка теперь надстраивается поверх этого поведения. Между тем система может упустить исследование альтернативной стратегии, которая сначала изучает окружение и устанавливает только то, что действительно необходимо.
Вторая проблема — «межзадачные помехи» (cross-task interference). Изменение, которое помогает в одном классе задач, может незаметно навредить в другом. Например, инструкция выполнять тщательную верификацию может улучшить сложные задачи научного вычисления, но заставить более простые задачи выйти за рамки отведенного времени. Чем шире становится распределение задач агента, тем сложнее вносить локальные улучшения без ущерба для уже имеющихся возможностей.
С этими же проблемами уже хорошо знакомы корпоративные команды, которые вручную исправляют промпты и рабочие процессы после сбоев. В комментариях для VentureBeat Ран Сюй (Ran Xu), ведущий автор статьи о DarwinX, отметил: «Ручное проектирование каркаса легко может привести к локальному оптимуму: вы исправляете промпт или рабочий процесс для одного типа сбоя, но без широкого регрессионного тестирования можете незаметно сломать то, что уже работало».
Оценки работы агентов добавляют еще одну сложность. Результаты носят стохастический характер, поэтому один и тот же агент может успешно справиться с задачей в одном запуске и провалить ее в другом. Исследователи ссылаются на предыдущие исследования, в которых фиксировались колебания на несколько процентных пунктов между различными запусками индустриальных бенчмарков. Это может быть сопоставимо с видимой пользой от отдельной правки каркаса.
Из-за этого широкое регрессионное тестирование становится столь же важным, сколь и исправление ошибки, которая спровоцировала изменение каркаса.
Следовательно, главная задача заключается в том, чтобы определить, какие улучшения являются реальными, сохранить полезные альтернативы и объединить новые возможности, не утратив старые.
DarwinX позволяет улучшениям конкурировать
DarwinX рассматривает это как задачу на выбор. Вместо поддержания одного непрерывно перезаписываемого каркаса он генерирует различные варианты и сохраняет их в архиве. Многообещающие версии могут продолжать эволюционировать, в то время как полезные находки из других ветвей остаются доступными для последующего использования. Сама базовая большая языковая модель (LLM) остается неизменной.
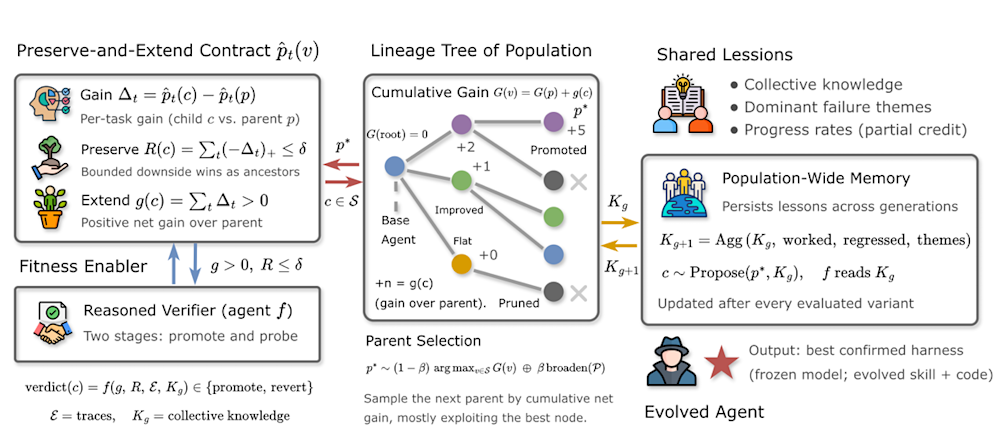
Первый ключевой механизм исследователи называют «сохранение и расширение» (preserve and extend).
Кандидат в каркасы должен улучшать что-то одно, удерживая при этом уровень регрессий по ранее решенным задачам в пределах ограниченного допуска. Проще говоря, решение задачи B не считается большим достижением, если то же изменение ломает задачи A и C.
Фреймворк DarwinX (источник: arXiv)
DarwinX также разделяет исследование и подтверждение. Многообещающая правка с ограниченными потенциальными рисками может пройти этап предварительного отсева. Но прежде чем ей доверят направлять дальнейшую эволюцию, система запускает ее повторно с более высокой точностью и проверяет на задачах, которые предыдущие версии уже научились решать. Это снижает вероятность того, что один случайный удачный запуск перенаправит вектор поиска.
DarwinX может применять эту дисциплину, поскольку результаты его экспериментов с кодом и браузером поддаются относительно надежной верификации. Это позволяет системе проверять, добавляет ли изменение каркаса новую функциональность, сохраняя при этом способность решать задачи, с которыми справлялись прошлые версии.
Для инженеров-программистов концепция «сохранения и расширения» во многом напоминает непрерывную интеграцию (CI) для агента: предложить изменение, протестировать новое поведение, запустить ранее успешно пройденные кейсы и только после этого позволить кандидату влиять на будущие версии. Как выразился Сюй: «Главное здесь то, что DarwinX не просто объединяет изменения в надежде, что результат окажется лучше. Объединенный агент все равно должен пройти проверки на сохранение и подтверждение, сохранив синергетические победы без регресса ранее решенных задач».
Второй механизм решает проблему зависимости от траектории. DarwinX сохраняет альтернативные ветки, включая те варианты, которые демонстрируют более слабые общие метрики. Какая-то ветка может в целом работать хуже, но содержать единственное изменение, решающее определенный класс задач. Вместо того чтобы выбрасывать эту работу на помойку, DarwinX может использовать ее в качестве специалиста.
Когда у разных специалистов есть взаимодополняющие сильные стороны, фреймворк может объединить их аддитивные изменения в новый каркас. После этого объединенная версия должна доказать, что она сохраняет соответствующие сильные стороны своих «родителей». Это позволяет улучшениям, обнаруженным на разных эволюционных путях, снова объединяться, вместо того чтобы оставаться запертыми в изолированных ветках.
При предложении следующего изменения DarwinX также может опираться на различные источники. Он может анализировать неудачные траектории, учиться на успешных траекториях более сильного учителя или сравнивать собственные успешные и неудачные попытки агента на одной и той же задаче. Все эти три сигнала приводят к правкам каркаса, а не к изменению весов модели.
Кроме того, исследователи агрегируют повторяющиеся сбои в общую память. Например, если несколько задач завершаются неудачно из-за того, что настройка окружения занимает слишком много времени, система может предложить возможность повторного использования настроек вместо создания отдельных патчей для каждой задачи.
Именно здесь «естественный отбор» в DarwinX становится более буквальным. Системе не требуются эталонные решения, а исследователям не нужно вручную изучать кандидатов и выбирать победителя. Варианты каркаса выживают на основе их измеренной пригодности в соответствии с оценщиком задач.
Это не значит, что DarwinX работает в отсутствие сигналов оценки. Ему по-прежнему нужен способ определить, была ли задача успешной. Например, в экспериментах с WebArena-Infinity исследователи использовали LLM-судью для оценки траекторий, сгенерированных различными вариантами их агента.
Этот процесс отбора также отличает DarwinX от таких систем, как DGM и HarnessX. У DGM уже есть открытый архив, но он мутирует только одного родителя за раз и не имеет кросс-линейного слияния или контракта явного сохранения, как у DarwinX. HarnessX изолирует варианты для предотвращения помех, в то время как DarwinX стремится безопасно объединить комплементарные возможности обратно.
DarwinX в действии
Исследователи протестировали DarwinX на Monet — проприетарном агенте Salesforce. В парных сравнениях базовая модель оставалась замороженной.
Оценки становятся все более устойчивыми к подгонке под данные (overfitting). В первом раунде экспериментов агент эволюционирует и оценивается на одном и том же бенчмарке. Второй раунд тестирует агентов на отложенных задачах. На третьем этапе каркас агента эволюционирует на синтетических браузерных задачах, а оценивается на не встречавшихся ранее реальных. Финальный эксперимент переносит каркас, эволюционировавший на одном бенчмарке, на совершенно другой бенчмарк.
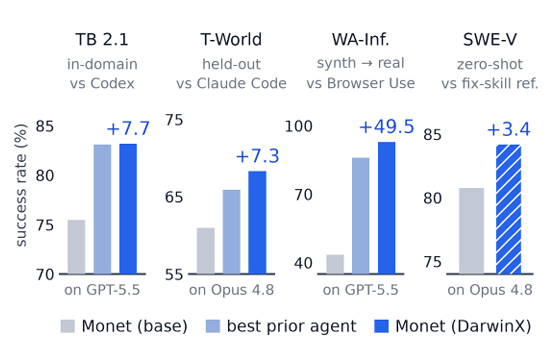
Как сообщают исследователи, на Terminal-Bench 2.1 фреймворк DarwinX увеличил показатель Monet на замороженной GPT-5.5 с 75,5% до 83,2%, а при использовании более сильной базовой модели — до 84,7%. Наибольший прирост пришелся на задачи машинного обучения и научных вычислений (рост на 14,8 балла), а также на задачи обработки данных и работы с базами данных (рост на 13,8 балла).
Однако важнее самого скачка баллов оказались изменения, которые привели к этим результатам. Эволюционировавший каркас добавил семь навыков, которые предписывают агенту определять, как должен выглядеть правильный результат, проверять сгенерированные файлы и значения перед завершением работы, а также подкреплять результаты реальным выполнением инструментов.
При этом эволюционировавший агент не просто стал тратить больше вычислительных ресурсов инференса повсеместно. На задачах, с которыми обе версии уже умели справляться, медианное количество шагов (turns) увеличилось всего с 12 до 13. Напротив, на шести заново решенных задачах этот показатель удвоился с 11 до 22. Это означает, что каркас научился понимать, в каких случаях дополнительные проверки и повторные попытки оправдывают затраты.
Производительность DarwinX (источник: arXiv)
TerminalWorld предоставляет более наглядный пример того, почему DarwinX сохраняет множество ветвей. Каркас эволюционировал на 94 тренировочных задачах, после чего был заморожен перед тестированием на 41 отдельной задаче. Согласно статье, на Opus 4.8 базовая версия решила 25 задач из 41 (61%), в то время как DarwinX справился с 28 (68,3%).
Что еще интереснее, четыре специализированных варианта решили 24, 25, 26 и 27 отложенных задач на различных пересекающихся подмножествах. Объединенный каркас достиг результата в 28 задач, превзойдя каждого специалиста по отдельности. Исследователи отмечают Opus 4.8 как главный результат статьи, поскольку аналогичная процедура на GPT-5.5 дала 56,1% (что ниже нейтрального базового агента), и называют отрыв в одну задачу от сильнейшего готового агента скорее показательныи, чем статистически решающим.
Сюй указывает на этот результат как на доказательство того, что совокупные баллы могут скрывать полезные возможности. «Вариант с более низким баллом все равно может содержать единственное успешное поведение для определенного класса задач», — отметил он.
Практическим корпоративным аналогом здесь может служить агент реагирования на инциденты. Лучшая версия общего назначения может надежно инспектировать сервисы, запускать стандартную диагностику и готовить безопасные изменения в коде. Специалист с более низким баллом мог разработать надежный рабочий процесс авторизации в Kubernetes, в то время как другой мог лучше справляться с восстановлением баз данных и верификацией артефактов. Ни одному из специалистов не обязательно быть достаточно хорошим для самостоятельного развертывания, чтобы изменения в его каркасе принесли пользу. DarwinX может сохранить это поведение, объединить его с остальными, а затем подвергнуть объединенную версию тем же проверкам на регрессию перед продвижением в производство.
Результат TerminalWorld служит измеримым доказательством, лежащим в основе этой аналогии. В статье отдельно не выделяется, какая именно доля прироста обеспечивается самой рекомбинацией по сравнению с другими частями системы DarwinX.
В экспериментах с WebArena-Infinity компания DarwinX развивала браузерный каркас на 300 синтетических намерениях (intents), сгенерированных на основе документации приложений. Финальный тест включал 1 260 не встречавшихся ранее задач с детерминированными верификаторами, а не с LLM-судьей, который использовался для оценки вариантов в процессе эволюции. Исследователи сообщают, что при замороженной модели GPT-5.5 производительность агента выросла с 43,5% до 93% — показатель увеличился более чем в два раза без изменения весов модели (эта цифра приводится после аудита, отсеявшего траектории с недействительным или эксплойтным поведением).
Наконец, исследователи взяли каркас, эволюционировавший на Terminal-Bench, и запустили его без изменений на SWE-bench Verified. Согласно статье, он достиг 84,8% против 80,8% у эталонного каркаса, не получая обратной связи от SWE-bench в процессе эволюции. Этот результат доказывает, что некоторые виды выученного поведения каркаса могут переноситься за пределы бенчмарка, на котором они развивались, хотя в статье этот перенос тестируется только в одном направлении.
Что DarwinX означает для разработчиков
Главное практическое преимущество DarwinX заключается в том, что цикл улучшений работает на уровне, которым разработчики приложений уже управляют. Доступ к весам модели не требуется.
По мере совершенствования базовых моделей этот окружающий их слой может стать еще более важным. Каркас должен адаптироваться к поведению каждой модели при использовании инструментов, требованиям к контексту и типам сбоев. Он также несет в себе специфическую для предприятия информацию, которую модель общего назначения не может просто выучить во время предварительного обучения: «живые» данные, рабочие процессы, разрешения, идентификационные данные, правила управления, инструменты и поверхности взаимодействий.
«Модель может впитывать больше возможностей к общему рассуждению, в то время как каркас все больше представляет собой специфический для предприятия контекст, действия, систему управления и адаптационный слой вокруг модели», — говорит Сюй. «Это может стать гораздо более долговечным источником дифференциации, чем любой отдельно взятый промпт».
Более сложная задача заключается в создании инфраструктуры оценки, которая сообщает циклу эволюции о том, что именно означает «лучше». В отличие от бенчмарков по программированию, реальные корпоративные рабочие процессы редко имеют один четкий бинарный верификатор.
Сюй утверждает, что предприятия должны решать эту проблему путем фиксации того, что происходит во время реальной работы, и постепенного превращения этих следов (traces) в сигналы для обучения и оценки. Рассмотрим агента службы поддержки. Компания может записывать действия агента, изменения статусов тикетов, исправления со стороны человека, эскалации, проверки политик, одобрения и последующие результаты. Некоторые из этих сигналов могут стать детерминированными тестами: достиг ли кейс правильного состояния, завершилась ли одобренная транзакция или содержала ли база данных ожидаемое значение? Другие могут поступать из человеческих исправлений, проверок на соответствие требованиям (compliance), бизнес-результатов или на основе согласия нескольких оценщиков.
«Предприятиям не обязательно нужен один идеальный целевой показатель (reward function)», — считает Сюй. «Им нужна инфраструктура, которая непрерывно превращает реальную работу в постоянно усиливающийся интеллект предприятия».
Со временем эта инфраструктура может сформировать непрерывно обновляемый набор тестов для оценки, составленный из рабочих процессов, с которыми агент действительно сталкивается. Это решает одно из главных практических ограничений, выявленных в статье: производственные задачи редко поступают с надежными верификаторами. Вместо того чтобы развивать агента непосредственно на основе «живых» запросов, команды могут периодически запускать эволюцию на поддерживаемом прокси-наборе и развертывать ту версию, которая успешно проходит регрессионные тесты.
Salesforce также открыла доступ к инфраструктуре для экспериментов с этим подходом через Beagle — открытый фреймворк, доступный на GitHub под лицензией Apache 2.0. Monet остается проприетарным решением, но команды могут использовать собственный каркас агента в Beagle. DarwinX выступает в роли метода эволюции, который ищет, оценивает и отбирает варианты каркаса, в то время как Beagle обеспечивает более широкую инфраструктуру для запусков и экспериментов с агентами, окружениями, наборами данных и методами эволюции.
Сюй описывает Beagle как «Hugging Face Trainer для эволюции агентов»: «Вы привносите агента, окружение, сигнал оценки и алгоритм эволюции, а инфраструктура берет на себя масштабируемые запуски и эксперименты».
Переход от ручного обновления промптов к такому автоматизированному CI для каркасов имеет свою цену. DarwinX исследует множество вариантов, повторяет оценки для учета зашумленных результатов и запускает проверки на сохранение до того, как кандидаты смогут повлиять на последующие поколения. Это требует больших вычислительных ресурсов для оценки и более развитой инфраструктуры, чем ручное редактирование промптов. Но ручные обновления также требуют регрессионного тестирования при внедрении в продакшн. Разница заключается в том, что автоматизированный цикл может проводить эти эксперименты систематически, избавляя инженера от необходимости вручную выявлять и исправлять ошибки по одной.
Команды также могут ограничивать затраты. Эволюция может выполняться в рамках фиксированного бюджета вычислений и останавливаться при выходе на плато улучшений. «Цель состоит в том, чтобы тратить вычислительные ресурсы на оценку до тех пор, пока предельное улучшение не перестанет оправдывать затраты», — говорит Сюй. Для предприятия в расчеты принимаются затраты времени инженеров и риски регрессии наряду с расходами на инференс: как быстро система достигает требуемого уровня качества и сколько производственных регрессий предотвращает автоматизированный цикл тестирования и отбора?
Это также означает, что DarwinX подходит далеко не для каждого агента. Сюй рекомендует оптимизацию эволюционных каркасов для долгосрочных задач, результаты которых можно оценивать с разумной долей уверенности и которые обладают широким спектром поведенческих проявлений (например, промпты, навыки, инструменты, память, управление потоком выполнения или исходный код).
Напротив, встраивание подобных сложных механизмов трудно оправдать для простого и стабильного рабочего процесса, такого как сопоставление известного ввода с фиксированным вызовом API и возврат результата. «Я бы не стал внедрять популяционную эволюцию просто ради нее самой», — говорит Сюй. Детерминированный рабочий процесс, как правило, проще для понимания, тестирования и администрирования.
Существует и срединный путь. Корпоративный агент службы поддержки может охватывать достаточное количество изменяющихся рабочих процессов, чтобы извлечь выгоду из непрерывного улучшения, не требуя при этом полноценного популяционного эволюционного поиска. Команды могут позаимствовать базовую дисциплину DarwinX: превращать типичные сбои и отзывы пользователей в предлагаемые изменения для промптов, рабочих процессов, операций с базами данных, вызовов функций или интеграций, а также проверять эти изменения на наборе для регрессионного тестирования. Простой линейный поиск или поиск по принципу «сначала лучшие» может оказаться достаточным, когда задача не оправдывает поддержку полноценной популяции вариантов.