Передача текста замедляет работу ИИ-моделей. Технология C2C позволяет им общаться напрямую через кэши KV
Источник: VentureBeat · Ben Dickson


Когда мульти-LLM-система передает работу от одной модели к другой с помощью текста — будь то маршрутизатор, переключающийся между моделями, или агенты, сотрудничающие при решении задачи, — первая модель должна сжать то, что ей известно, в текст, а следующая — прочитать этот текст и восстановить содержащуюся в нем информацию. Такая передача может привести к потере информации и увеличить время инференса.
Cache-to-Cache (C2C) — метод, предложенный исследователями из Университета Цинхуа и других китайских институтов, пытается решить эту проблему, позволяя моделям обмениваться информацией через внутренние представления, хранящиеся в их кэшах ключей-значений (KV-кэшах), вместо того чтобы полагаться исключительно на промежуточный текст.
В экспериментах исследователей C2C повысил точность примерно на 3,1–5,4 процентных пункта по сравнению с текстовой коммуникацией и снизил задержку (лаг) для всех протестированных пар моделей. Для корпоративных команд, создающих маршрутизаторы моделей или мультиагентные системы, этот результат говорит о том, что сам коммуникационный слой может стать объектом оптимизации.
C2C также вписывается в более широкое направление исследований в области мультимодельного ИИ, цель которого — позволить моделям обмениваться внутренними представлениями напрямую, а не принудительно осуществлять каждую передачу через текстовые токены. Работа была представлена на конференции ICLR 2026, а в сентябре исследователи заявили о планах выпустить реализацию «управляемого агентом KV-кэша» вместе с системой обслуживания.
Текст — дорогое «бутылочное горлышко» при общении моделей
Мульти-LLM-системы бывают разных конфигураций. В системах совместной работы модели берут на себя разные роли и обмениваются анализом, инструкциями или частичными решениями. В системах маршрутизации оркестратор переключается между моделями с различными возможностями и стоимостью по мере развития диалога или рабочего процесса.
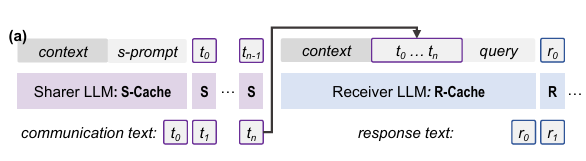
Классическая текстовая коммуникация создает дополнительную нагрузку при инференсе LLM (источник: arXiv)
В таких системах для передачи информации между моделями обычно используются текстовые токены. Исследователи утверждают, что это создает три проблемы.
Первая — потеря информации. Модель представляет контекст внутренне в виде многомерных числовых состояний. Чтобы передать информацию через текст, она должна сжать часть этого представления в последовательность текстовых токенов. Затем принимающая модель должна интерпретировать эту последовательность и построить собственное представление о том, что имела в виду первая модель, что потенциально ведет к потере информации.
Другая проблема заключается в том, что текстовая информация может быть амбивалентной (двусмысленной). Исследователи иллюстрируют это на примере моделей Coder («Программист») и Writer («Писатель»), изменяющих HTML-документ. Coder понимает, что тег
обозначает определенное структурное положение в документе, но его текстовая инструкция не передает эту информацию достаточно точно. Writer не может разместить запрошенный контент в нужном месте.
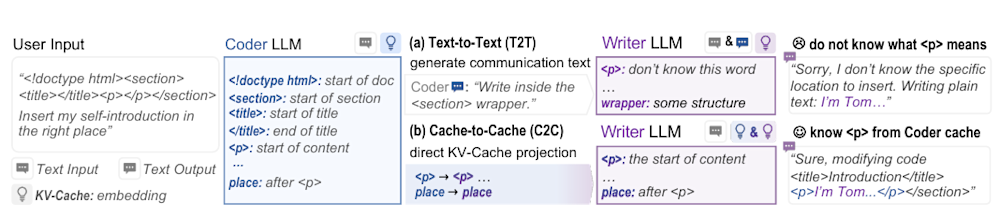
Текстовая коммуникация между LLM может вызывать двусмысленность и путаницу (источник: arXiv)
Наконец, текстовая коммуникация накладывает тяжелые вычислительные затраты на систему ИИ. Первая модель должна генерировать свое сообщение последовательно, токен за токеном. Затем эти токены добавляются к входным данным второй модели, которой приходится обрабатывать более длинный контекст, прежде чем она сможет сгенерировать ответ. Чем длиннее передача, тем больше работы приходится выполнять обеим моделям. В системах с длинным контекстом или повторяющимися передачами между агентами эти накладные расходы на коммуникацию могут быстро накапливаться.
Превращение KV-кэша в коммуникационный слой
C2C стремится избежать дополнительной генерации текста и обработки этой передачи со стороны получателя за счет обмена данными через представление, которое модели и так создают: KV-кэш.
Когда LLM впервые обрабатывает промпт, она запускает стадию «префилла» (предварительного заполнения), которая преобразует входные данные во внутренние представления ключей и значений. Они сохраняются в KV-кэше и повторно используются по мере генерации моделью ответа. Эти закэшированные состояния ключей и значений кодируют информацию, которую модель извлекла из контекста.
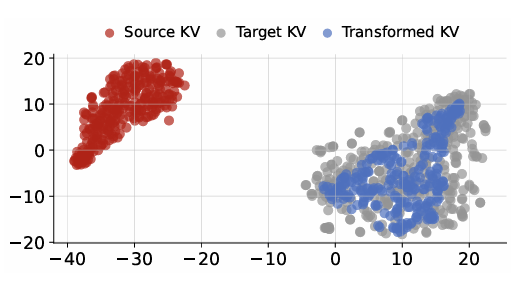
Эксперименты показывают, что KV-кэш может трансформироваться между различными моделями без повторной обработки токенов (источник: arXiv)
Исследователи сначала проверили, может ли KV-кэш служить средой коммуникации. Их эксперименты показали, что информация, хранящаяся в KV-кэше, может быть обогащена без увеличения длины кэша, а кэш, созданный одной моделью, может быть преобразован в пространственное представление другой модели.
C2C опирается на эти выводы. Обе модели обрабатывают один и тот же контекст. Одна выступает в роли «донора» (Sharer), а другая — в роли «реципиента» (Receiver). Обученный модуль слияния кэшей (cache fuser) проецирует кэш донора в пространство представлений реципиента, а затем объединяет его с собственным кэшем реципиента. Обучаемый вентиль (gate) контролирует, какие слои реципиента должны получить дополнительную информацию.
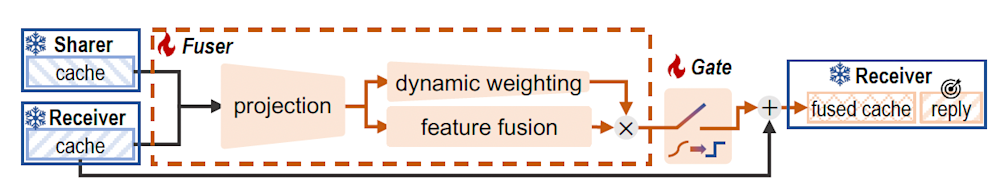
Архитектура Cache-2-cache (источник: arXiv)
В системах маршрутизации это позволяет реципиенту включать информацию из кэша донора без необходимости использования промежуточного текстового сообщения. Обе модели по-прежнему обрабатывают общий контекст для построения собственных KV-кэшей. В системах совместной работы это создает дополнительный канал связи наряду с текстом.
C2C в действии
Исследователи протестировали C2C на бенчмарках рассуждений и знаний, включая MMLU-Redux, OpenBookQA, ARC-Challenge и C-Eval. При фиксированной модели Qwen3-0.6B в качестве реципиента и трех разных донорах C2C увеличил среднюю точность реципиента примерно на 9,6–11,9 процентных пункта по сравнению с работой реципиента в одиночку, превзойдя текстовую коммуникацию примерно на 3,1–5,4 пункта. Это результаты бенчмарков, а не тесты реальных рабочих нагрузок продакшн-агентов. Измерения задержки проводились с размером батча 1 на одном чипе Nvidia A100.
Снижение задержки существенно различалось в зависимости от пары моделей. C2C оказался в 3,46, 1,51 и 14,41 раза быстрее текстовой коммуникации для трех основных конфигураций доноров. Результат в 14,41 раза был получен с базовой моделью Qwen3-4B в качестве донора; исследователи отмечают, что эта модель иногда игнорировала инструкции по текстовой коммуникации и генерировала сообщения большей длины, чем ожидалось, из-за чего текстовый базовый метод работал особенно медленно.
В одном из экспериментов с текстовой коммуникацией донор генерировал в среднем 80 коммуникационных токенов. Генерация этих токенов заняла 1312 миллисекунд. Полученное сообщение также увеличило количество токенов, которые должен был обработать реципиент. В отличие от этого, для C2C потребовалось всего около 90 миллисекунд на слияние кэшей и не нужно было генерировать текстовые токены.
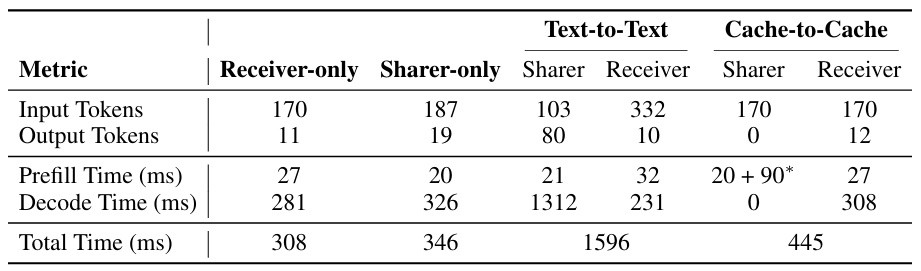
Результаты C2C
Этот метод также работал, когда две модели имели разные архитектуры или специализации. Тесты включали комбинации Gemma-to-Qwen, Qwen Math-to-Qwen и Qwen Coder-to-Qwen. C2C превзошел текстовую коммуникацию во всех пяти разнородных и переставленных конфигурациях моделей, о которых сообщалось в эксперименте.
Что требуется для развертывания C2C
C2C не требует тонкой настройки (fine-tuning) ни одной из участвующих LLM. Исследователи замораживают донор и реципиент и обучают только модуль слияния кэшей, используя стандартную задачу прогнозирования следующего токена.
Тем не менее, межмодельная коммуникация требует инженерных усилий. У разных моделей могут быть разные токенайзеры, количество слоев и размеры представлений. C2C выравнивает токены, сгенерированные различными токенайзерами, и сопоставляет соответствующие слои трансформера перед слиянием их кэшей. Обучение «моста» также требует предварительных затрат. Команда выпустила код и конфигурации C2C на GitHub под лицензией Apache 2.0 вместе с предобученными чекпоинтами объединителя C2C на Hugging Face.
Один из нюансов заключается в том, что поскольку C2C должен читать, преобразовывать и заменять состояния внутреннего KV-кэша, ему требуется стек инференса, который предоставляет доступ к этим внутренним компонентам. Из-за этого на сегодняшний день данный подход в первую очередь актуален для команд, которые контролируют собственный стек инференса, а не для приложений, объединяющих модели исключительно через закрытые API.
LLM могут не нуждаться в токенах для общения друг с другом
C2C вписывается в более широкое направление исследований, которые ставят под сомнение то, должен ли текст оставаться интерфейсом по умолчанию внутри мультимодельных систем ИИ.
Одним из примеров являются исследования Nvidia, посвященные переносу KV-кэша между моделями. Когда система переключает модели во время долгой сессии, новой модели обычно приходится обрабатывать накопившийся контекст и заново строить свой кэш. В то же время Nvidia проецирует существующий кэш в формат целевой модели. На совместимых парах моделей исследователи Nvidia сообщили, что этот метод работал в 2,7–25 раз быстрее, чем повторный префилл.
В то время как метод Nvidia переносит весь KV-кэш между исходной и целевой моделями, в C2C обе модели обрабатывают контекст, а затем их кэши объединяются, чтобы реципиент мог извлечь выгоду из семантического представления другой модели.
Другим примером в этой области является RecursiveMAS — мультиагентный фреймворк, который заменяет текстовые сообщения непрерывными латентными представлениями, передаваемыми между агентами. Согласно экспериментам, он обеспечивает ускорение инференса до 2,4 раза и снижение использования токенов на 75,6% по сравнению со своим текстовым рекурсивным аналогом.
Механизмы различаются, но у них общая исходная ставка: модели могут общаться более эффективно, если им не нужно сначала переводить все в текст.
На данный момент C2C — это результат исследований, а не продакшн-архитектура: для него требуется доступ к внутренним компонентам моделей, а его прирост производительности измерялся на бенчмарках, а не на реальных рабочих нагрузках корпоративных агентов.