


RecursiveMAS сокращает расходы на многоагентный ИИ на 75%: заявляют исследователи
Источник: VentureBeat · Ben Dickson


Одной из главных проблем современных многоагентных ИИ-систем является то, что они общаются путем генерации и обмена текстовыми последовательностями. Это приводит к задержкам, увеличивает затраты на токены и затрудняет обучение всей системы как единого целого.
Чтобы преодолеть эту трудность, исследователи из Иллинойсского университета в Урбане-Шампейне и Стэнфордского университета разработали RecursiveMAS — фреймворк, который позволяет агентам сотрудничать и передавать информацию через пространство эмбеддингов вместо текста. Это изменение обеспечивает повышение как эффективности, так и производительности.
Эксперименты показывают, что RecursiveMAS повышает точность в таких сложных областях, как генерация кода, медицинские рассуждения и поиск, одновременно увеличивая скорость инференса и сокращая расход токенов.
Обучение RecursiveMAS обходится значительно дешевле, чем стандартное полное дообучение (full fine-tuning) или методы LoRA, что делает его масштабируемой и рентабельной основой для пользовательских многоагентных систем.
Проблемы совершенствования многоагентных систем
Многоагентные системы могут помогать в решении сложных задач, с которыми с трудом справляются одноагентные системы. При масштабировании многоагентных систем для реальных приложений серьезной проблемой становится обеспечение возможности системы эволюционировать, совершенствоваться и адаптироваться к различным сценариям с течением времени.
Адаптация на основе промптов улучшает взаимодействие агентов за счет итеративного уточнения общего контекста, предоставляемого им. Обновляя промпты, система выступает в роли режиссера, направляя агентов на генерацию ответов, которые больше соответствуют общей цели. Фундаментальное ограничение заключается в том, что возможности лежащих в основе каждого агента моделей остаются статичными.
Более сложный подход заключается в обучении агентов путем обновления весов базовых моделей. Обучение целой системы агентов — сложная задача, поскольку обновление всех параметров в нескольких моделях представляет собой нетривиальную вычислительную задачу.
Даже если инженерная команда решится на обучение своих моделей, стандартный метод взаимодействия агентов посредством текста создает серьезные узкие места. Поскольку агенты полагаются на последовательную генерацию текста, это вызывает задержки, так как каждая модель должна дождаться завершения генерации текста предыдущей моделью, прежде чем начать собственную обработку.
Принудительное побуждение моделей выписывать свои промежуточные рассуждения токен за токеном только для того, чтобы их прочитала следующая модель, крайне неэффективно. Это сильно раздувает использование токенов, увеличивает вычислительные затраты и делает итеративное обучение всей системы крайне медленным для масштабирования.
Как работает RecursiveMAS
Вместо того чтобы пытаться улучшить каждого агента как изолированный автономный компонент, RecursiveMAS разработан для совместной эволюции и масштабирования всей многоагентной системы как единого целого.
Этот фреймворк вдохновлен рекурсивными языковыми моделями (RLM). В стандартной языковой модели данные движутся линейно через стек отдельных слоев. Напротив, рекурсивная языковая модель повторно использует набор общих слоев, которые обрабатывают данные и возвращают их обратно в систему. Зацикливая вычисления, модель может углублять свои рассуждения без добавления параметров.
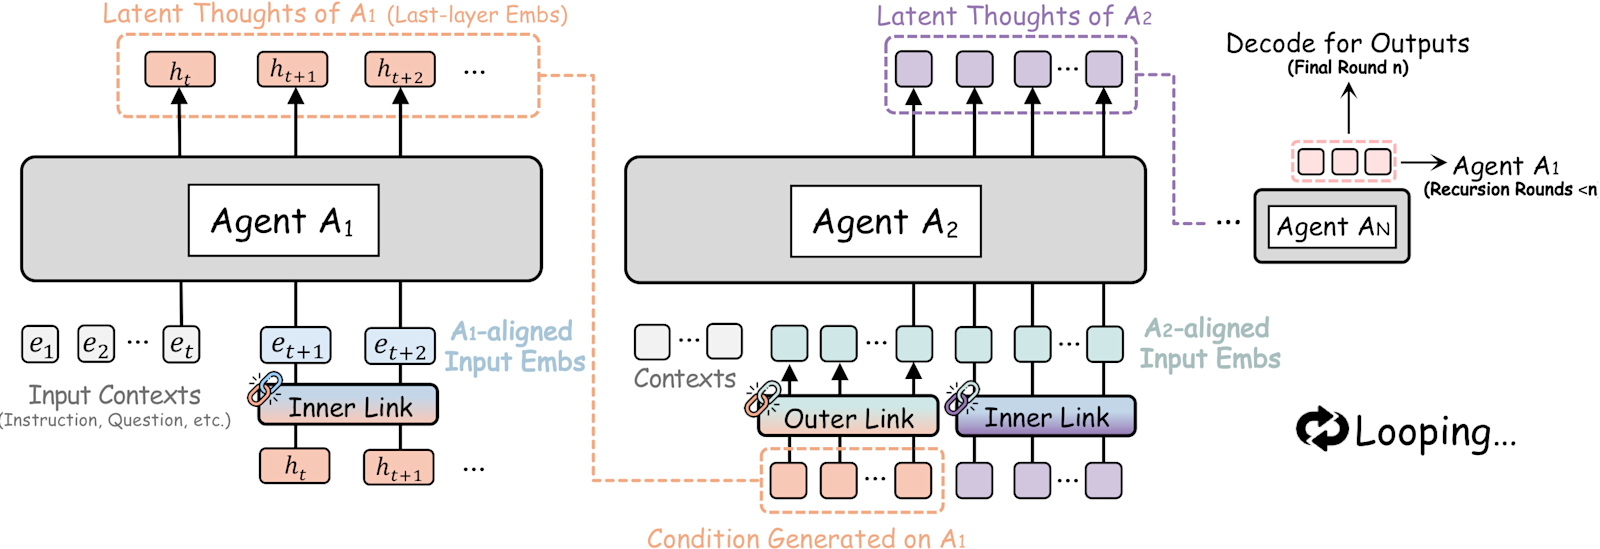
Архитектура RecursiveMAS (источник: arXiv)
RecursiveMAS распространяет этот принцип масштабирования с отдельной модели на многоагентную архитектуру, которая действует как единая рекурсивная система. В этой настройке каждый агент функционирует подобно слою в рекурсивной языковой модели. Вместо генерации текста агенты итеративно передают свои непрерывные скрытые представления (латенты) следующему агенту в последовательности, создавая закольцованный скрытый поток информации, проходящий через всю систему.
Эта передача латентных состояний продолжается по цепочке через всех агентов. Когда последний агент завершает обработку, его латентные выходы возвращаются непосредственно самому первому агенту, запуская новый раунд рекурсии.
Такая структура позволяет всей многоагентной системе взаимодействовать, рефлексировать и уточнять свои коллективные рассуждения в течение нескольких раундов исключительно в латентном пространстве, и только самый последний агент выдает текстовый вывод в финальном раунде. Это выглядит так, будто агенты общаются телепатически как единое целое, а последний агент предоставляет окончательный ответ в виде текста.
Архитектура латентного сотрудничества
Чтобы сделать возможным сотрудничество в непрерывном латентном пространстве, авторы представляют специализированный архитектурный компонент под названием RecursiveLink. Это легковесный двухслойный модуль, предназначенный для передачи и уточнения латентных состояний модели вместо того, чтобы заставлять ее декодировать текст.
Скрытые состояния последнего слоя языковой модели содержат богатые семантические представления ее процесса рассуждения. RecursiveLink разработан для сохранения и передачи этой информации высокой размерности из одного пространства эмбеддингов в другое.
Чтобы избежать затрат на обновление каждого параметра во множестве больших языковых моделей, фреймворк оставляет параметры моделей замороженными. Вместо этого он оптимизирует систему, обучая только параметры модулей RecursiveLink.
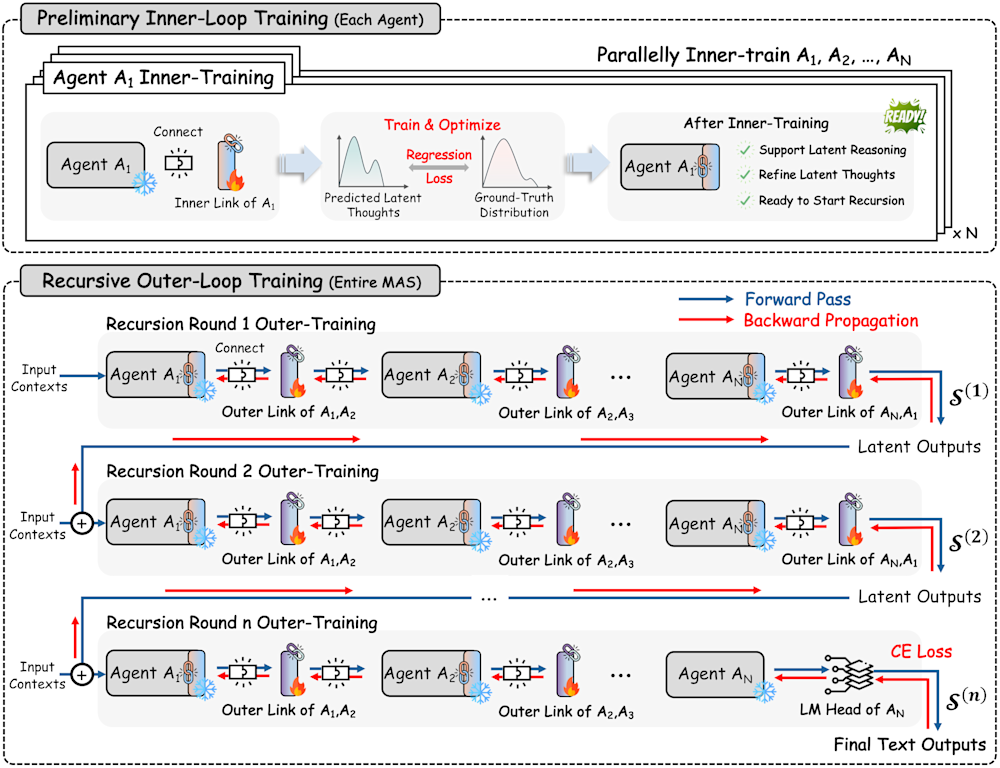
Процесс рекурсивного обучения (источник: arXiv)
Для обработки как внутренних рассуждений, так и внешнего взаимодействия система использует две вариации модуля. Внутренний RecursiveLink работает внутри агента на этапе его рассуждений. Он принимает заново сгенерированные моделью эмбеддинги и отображает их обратно в пространство входных эмбеддингов самой модели. Это позволяет агенту непрерывно генерировать поток скрытых мыслей без генерации дискретных текстовых токенов.
Внешний RecursiveLink служит мостом между агентами. Поскольку агенты в реальной системе могут использовать различные архитектуры и размеры моделей, их внутренние латентные пространства имеют совершенно разные размерности. Внешний RecursiveLink включает в себя дополнительный слой, предназначенный для сопоставления эмбеддингов из скрытой размерности одного агента с пространством эмбеддингов следующего.
Во время обучения сначала независимо тренируются внутренние связи (интервалы), чтобы разогреть способность каждого агента мыслить в непрерывных латентных эмбеддингах. Затем система переходит к обучению по внешнему циклу, где разнообразные замороженные модели объединяются в цепочку в виде петли, а система оценивается на основе финального текстового вывода последнего агента.
Единственное, что обновляется в процессе обучения — это параметры RecursiveLink, в то время как исходные веса моделей остаются неизменными, подобно низкоранговой адаптации (LoRA). Еще одно преимущество этой системы проявляется, когда у вас есть несколько агентов поверх одной и той же базовой модели.
Если у вас есть многоагентная система, в которой два агента построены на одной и той же базовой модели, но выполняют разные роли, вам не нужно загружать две копии модели в память графического процессора и обучать их раздельно. Агенты будут делить одну и ту же основу в качестве «мозга» и использовать RecursiveLink в качестве соединительной ткани.
RecursiveMAS в действии
Исследователи оценили RecursiveMAS по девяти бенчмаркам, охватывающим математику, естественные науки и медицину, генерацию кода и вопросно-ответные системы на основе поиска. Они создали многоагентную систему с использованием моделей с открытыми весами, включая Qwen, Llama-3, Gemma3 и Mistral. Этим моделям были назначены роли для формирования различных паттернов взаимодействия агентов, таких как последовательные рассуждения и совместная работа по принципу смеси экспертов (mixture-of-experts).
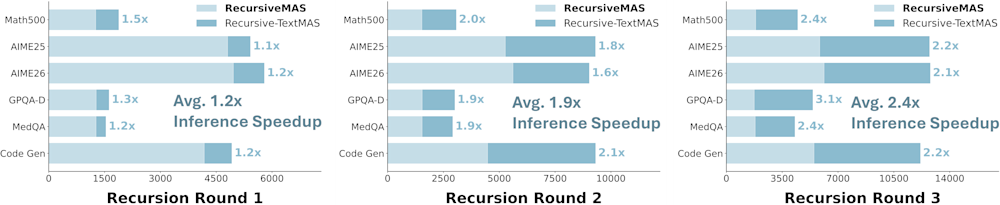
RecursiveMAS увеличивает скорость инференса в 1,2–2,2 раза (источник: GitHub)
RecursiveMAS сравнивался с базовыми моделями в условиях идентичных бюджетов на обучение, включая автономные модели, усовершенствованные с помощью LoRA или полного контролируемого дообучения (SFT), альтернативные многоагентные фреймворки вроде Mixture-of-Agents и TextGrad, а также рекурсивные бенчмарки вроде LoopLM. Он также сравнивался с Recursive-TextMAS, который использует ту же структуру рекурсивной петли, что и RecursiveMAS, но заставляет агентов общаться исключительно через текст.
RecursiveMAS достиг среднего прироста точности на 8,3% по сравнению с сильнейшими базовыми моделями по всем бенчмаркам. Он особенно преуспел в задачах, требующих сложных рассуждений, превзойдя текстовые методы оптимизации вроде TextGrad на 18,1% на AIME2025 и на 13% на AIME2026.
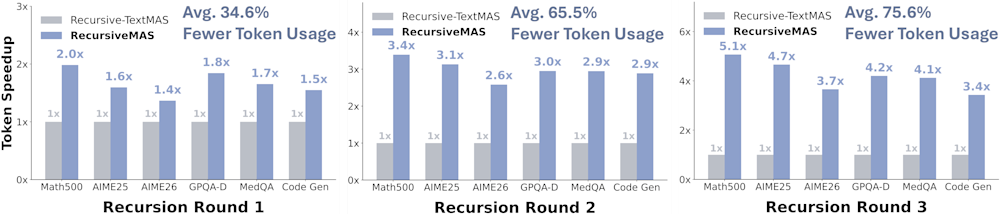
RecursiveMAS сокращает потребление токенов на величину до 75% (источник: GitHub)
Поскольку RecursiveMAS избегает генерации текста на каждом шаге, он обеспечивает ускорение сквозного (end-to-end) инференса в 1,2–2,4 раза. RecursiveMAS также гораздо эффективнее расходует токены по сравнению с альтернативами. По сравнению с текстовым Recursive-TextMAS он сокращает использование токенов на 34,6% в первом раунде рекурсии, а к третьему раунду достигает сокращения токенов на 75,6%. RecursiveMAS также оказался удивительно дешевым в обучении. Поскольку он обновляет только легковесные модули RecursiveLink, состоящие примерно из 13 миллионов параметров (около 0,31% от обучаемых параметров замороженных моделей), он требует минимального пикового объема памяти GPU и сокращает расходы на обучение более чем вдвое по сравнению с полным дообучением.
Внедрение на уровне предприятий
Повышение эффективности — снижение потребления токенов, уменьшение требований к памяти GPU и более быстрый инференс — призвано сделать сложные многоэтапные рабочие процессы агентов жизнеспособными в производственных средах без вычислительных накладных расходов, которые ограничивают развертывание агентских систем на уровне предприятий. Исследователи опубликовали код и обученные веса моделей под лицензией Apache 2.0.




