


Google и Массачусетский технологический институт переосмысляют производительность агентных систем
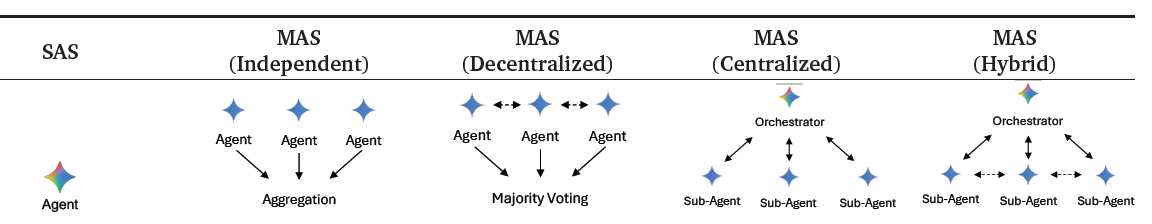


Исследователи из Google и MIT провели комплексный анализ агентных систем и динамики взаимосвязи между количеством агентов, структурой координации, возможностями моделей и свойствами задач. Хотя в индустрии доминирует мнение «все, что вам нужно, — это больше агентов», исследование показывает, что масштабирование команд агентов не является гарантией повышения эффективности.
Основываясь на своих выводах, исследователи разработали количественную модель, способную предсказать производительность агентной системы при решении новой задачи. Их работа показывает, что добавление новых агентов и инструментов действует как обоюдоострый меч: хотя это может раскрыть потенциал решения определенных проблем, на других задачах это зачастую создает лишь лишние накладные расходы и приводит к снижению отдачи.
Эти результаты служат важным ориентиром для разработчиков и лиц, принимающих решения в компаниях, которые пытаются определить, когда следует развертывать сложные многоагентные архитектуры, а когда — более простые и экономичные одноагентные решения.
Состояние агентных систем
Чтобы понять выводы исследования, необходимо различать две основные архитектуры, используемые сегодня. Одноагентные системы (SAS) имеют единственный центр рассуждений. В такой конфигурации все процессы восприятия, планирования и выполнения происходят в рамках единого последовательного цикла, управляемого одним экземпляром языковой модели (LLM), даже если система использует инструменты, саморефлексию или рассуждения по цепочке мыслей (CoT). Напротив, многоагентная система (MAS) состоит из нескольких агентов на базе LLM, которые общаются посредством структурированной передачи сообщений, общей памяти или оркестрируемых протоколов.
В корпоративном секторе наблюдается всплеск интереса к MAS, вызванный предпосылкой, что специализированное сотрудничество может стабильно превосходить одноагентные системы. По мере того как задачи усложняются и требуют постоянного взаимодействия со средой (например, помощники по написанию кода или боты для финансового анализа), разработчики часто предполагают, что разделение работы между «специализированными» агентами является лучшим подходом.
Тем не менее, исследователи утверждают, что, несмотря на столь быстрое внедрение, до сих пор не существует обоснованной количественной структуры, которая позволяла бы предсказать, когда добавление агентов повышает производительность, а когда — ухудшает ее.
Ключевым вкладом статьи является различие между «статическими» и «агентными» задачами. Исследователи применили «Контрольный список агентных бенчмарков» (Agentic Benchmark Checklist), чтобы отделить задачи, требующие непрерывного многоэтапного взаимодействия, итеративного сбора информации и адаптивной корректировки стратегии, от тех, которые в этом не нуждаются. Это различие жизненно важно, поскольку стратегии, работающие для решения статических задач (например, голосование в тесте по программированию), часто терпят неудачу при применении к настоящим агентным задачам, где «накладные расходы на координацию» и «распространение ошибок» могут охватывать весь процесс решения проблемы.
Проверка пределов сотрудничества
Чтобы изолировать специфические эффекты системной архитектуры, исследователи разработали строгую экспериментальную структуру. Они протестировали 180 уникальных конфигураций, включающих пять различных архитектур, три семейства LLM (OpenAI, Google и Anthropic) и четыре агентных бенчмарка. Архитектуры включали одноагентную контрольную группу и четыре многоагентных варианта: независимые (параллельные агенты без связи), централизованные (агенты, отчитывающиеся перед оркестратором), децентрализованные (одноранговые дискуссии) и гибридные (сочетание иерархии и одноранговой связи).
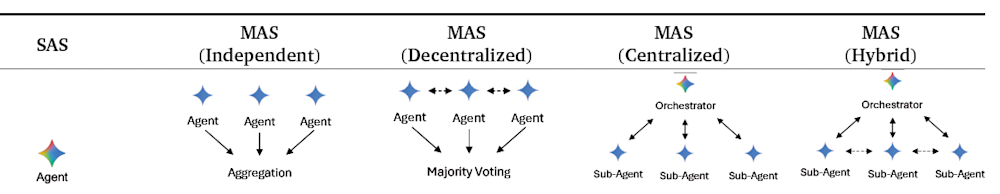
Различные одно- и многоагентные системы (источник: arXiv)
Исследование было спланировано так, чтобы исключить искажения, связанные с реализацией, путем стандартизации инструментов, структуры промптов и бюджетов токенов. Это гарантировало, что если многоагентная система превосходила одиночного агента, то прирост объяснялся именно структурой координации, а не доступом к лучшим инструментам или большим вычислительным мощностям.
Полученные результаты бросают вызов концепции «чем больше, тем лучше». Оценка показывает, что эффективность многоагентных систем определяется «количественно определяемыми компромиссами между свойствами архитектуры и характеристиками задач». Исследователи выделили три доминирующих паттерна, определяющих эти результаты:
Компромисс между инструментами и координацией: в условиях фиксированных вычислительных бюджетов многоагентные системы страдают от фрагментации контекста. Когда вычислительный бюджет разделен между несколькими агентами, у каждого из них остается недостаточно емкости для оркестрации инструментов по сравнению с единственным агентом, поддерживающим единый поток памяти.
В результате в средах с большим количеством инструментов (более 10) эффективность многоагентных систем резко падает. Исследователи обнаружили, что задачи со множеством инструментов страдают от потери эффективности в 2–6 раз при использовании многоагентных систем по сравнению с одиночными агентами. Более простые архитектуры парадоксальным образом становятся более эффективными, поскольку позволяют избежать накладных расходов на координацию, которые усугубляются с ростом сложности окружающей среды.
Насыщение возможностей: данные установили эмпирический порог примерно в 45% точности для производительности одиночного агента. Как только базовый показатель одиночного агента превышает этот уровень, добавление новых агентов обычно приводит к убывающей или отрицательной отдаче.
Тем не менее, соавтор работы Синь Лю (Xin Liu), научный сотрудник Google, отметил важный нюанс для корпоративных пользователей. «Предприятиям следует инвестировать как в [одно-, так и в многоагентные системы], — рассказал он VentureBeat. — Лучшие базовые модели поднимают исходный уровень, но для задач с естественной декомпозицией и потенциалом распараллеливания (например, наш бенчмарк Finance Agent с улучшением на +80,9%) координация множества агентов продолжает приносить существенную пользу независимо от возможностей модели».
Ошибки, зависящие от топологии: структура команды агентов определяет, исправляются ошибки или усугубляются. В «независимых» системах, где агенты работают параллельно без общения, количество ошибок возрастало в 17,2 раза по сравнению с базовым показателем одиночного агента. Напротив, в централизованных архитектурах это увеличение сдерживалось до 4,4 раза.
«Ключевым фактором отличия является наличие выделенного узкого места проверки, которое перехватывает ошибки до того, как они распространятся на финальный результат», — сказал ведущий автор Юбин Ким (Yubin Kim), аспирант MIT. — При логических противоречиях «централизованная» структура снижает базовый уровень… [на] 36,4%… А при ошибках пропуска контекста «централизованная» структура снижает его… [на] 66,8%».
Практические выводы для внедрения на предприятиях
Для разработчиков и руководителей предприятий эти выводы предоставляют конкретные рекомендации по созданию более эффективных систем ИИ.
-
Правило «последовательности»: прежде чем создавать команду агентов, проанализируйте структуру зависимостей вашей задачи. Главным предсказателем сбоя многоагентной системы являются строго последовательные задачи. Если Шаг Б полностью зависит от идеального выполнения Шага А, то лучшим выбором, скорее всего, станет одноагентная система. В таких сценариях ошибки каскадируются, а не нивелируют друг друга. И наоборот, если задача является параллельной или поддается декомпозиции (например, одновременный анализ трех разных финансовых отчетов), многоагентные системы обеспечивают колоссальный прирост.
-
Не чините то, что не сломано: предприятия всегда должны сначала проводить тестирование с одним агентом. Если одноагентная система достигает уровня успешности выше 45% в конкретной задаче, которую нельзя легко декомпозировать, добавление новых агентов, скорее всего, ухудшит производительность и увеличит затраты, не принеся дополнительной пользы.
-
Считайте свои API: будьте предельно осторожны при применении многоагентных систем к задачам, требующим множества различных инструментов. Разделение бюджета токенов между несколькими агентами фрагментирует их память и контекст. «Для интеграций со множеством инструментов (более примерно 10 инструментов) предпочтительнее использовать одноагентные системы», — отметил Ким, указав, что в таких сценариях исследование зафиксировало «падение эффективности в 2–6 раз» для многоагентных вариантов.
-
Сопоставляйте топологию с целью: если многоагентная система необходима, ее топология должна соответствовать конкретной цели. Для задач, требующих высокой точности и аккуратности (например, в финансах или программировании), централизованная координация превосходит остальные, поскольку оркестратор обеспечивает необходимый уровень верификации. Для задач, требующих исследования (например, динамического серфинга в интернете), децентрализованная координация превосходит другие за счет того, что позволяет агентам исследовать разные пути одновременно.
-
«Правило 4»: хотя может возникнуть искушение создать огромные рои, исследование показало, что эффективный размер команды в настоящее время ограничен примерно тремя-четырьмя агентами. «Ограничение в три-четыре агента, которое мы выявили, проистекает из измеримых ресурсных ограничений», — сказал Ким. Помимо этого, накладные расходы на связь растут сублинейно (а именно с показателем степени 1,724), что означает, что стоимость координации быстро превосходит ценность добавленных рассуждений.
Взгляд в будущее: преодоление предела пропускной способности
Хотя текущие архитектуры упираются в потолок при небольших размерах команд, это, вероятно, является ограничением существующих протоколов, а не фундаментальным пределом ИИ. Эффективный предел многоагентных систем проистекает из того факта, что в настоящее время агенты общаются плотным, ресурсоемким образом.
«Мы считаем это текущим ограничением, а не постоянным потолком», — сказал Ким, указав на несколько ключевых инноваций, которые могут раскрыть потенциал крупномасштабного сотрудничества агентов:
Протоколы разреженной связи: «Наши данные показывают, что плотность сообщений достигает насыщения примерно на уровне 0,39 сообщения за ход, после чего дополнительные сообщения добавляют избыточность, а не новую информацию. Более умная маршрутизация может сократить накладные расходы», — пояснил он.
Иерархическая декомпозиция: вместо плоских роев из 100 агентов вложенные структуры координации могли бы сегментировать граф связи.
Асинхронная координация: «В наших экспериментах использовались синхронные протоколы, а асинхронные схемы могли бы снизить накладные расходы на блокировку», — отметил он.
Маршрутизация с учетом возможностей: «Наши эксперименты с гетерогенностью показывают, что стратегическое смешивание возможностей моделей может повысить эффективность», — добавил Ким.
Этого стоит ждать в 2026 году. А до тех пор для корпоративных архитекторов данные ясны: побеждают меньшие, более умные и более структурированные команды.




