


Nvidia установила, что простая линейная математика может заменить дорогостоящую передачу задач между ИИ-моделями
Источник: VentureBeat · Ben Dickson


Когда агентная система ИИ передает задачу от небольшой модели к более крупной — или обратно, — ей приходится платить высокую цену: принимающей модели нужно пересчитывать всю беседу с нуля, что увеличивает вычислительные затраты и задержки. Это серьезное узкое место для предприятий, создающих долгосрочные рабочие процессы с использованием нескольких языковых моделей (LLM).
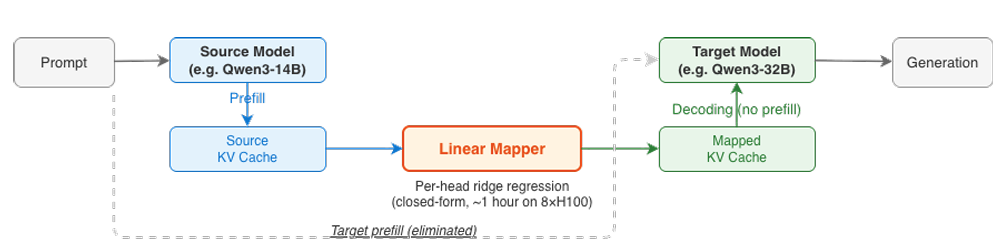
Чтобы решить эту проблему, исследователи из Nvidia представили метод переноса кэша ключей-значений (KV cache) между моделями, который напрямую сопоставляет предварительно заполненный кэш KV из исходной модели в целевую. Этот подход соответствует реальным сценариям применения агентов, где большие контексты накапливаются на протяжении множества шагов.
Для реальных ИИ-приложений перенос кэша KV между моделями позволяет снизить вычислительные затраты и задержки в долгоиграющих многомодельных рабочих процессах — причем за счет простой линейной математики, а не дорогостоящей модели глубокого обучения.
Эксперименты показывают, что для совместимых пар моделей этот процесс линейного сопоставления выполняется в 2,7–25 раз быстрее, чем пересчет беседы, сохраняя при этом до 98% автономной точности целевой модели.
Почему смена моделей посреди сессии стоит так дорого
Анализ того, как языковые модели работают с памятью, помогает понять, почему многомодельные рабочие процессы упираются в производственные ограничения по производительности. Когда LLM получает промпт, она должна сначала выполнить стадию «предварительного заполнения» (prefill) — первоначальный проход вперед, который вычисляет ключи и значения для всех входных токенов и заполняет кэш ключей-значений (KV cache).
После этого модель переступает к фазе «декодирования» (decode), на которой она вычисляет и генерирует следующие токены в последовательности. На этом этапе модель считывает данные из кэша KV для предсказания новых токенов по одному, избегая необходимости заново оценивать всю историю беседы для каждого нового токена.
В многошаговых беседах или долгосрочных агентских сессиях контекст постепенно увеличивается. Поскольку вычислительные затраты на этап предварительного заполнения напрямую зависят как от размера модели, так и от длины входных данных, обработка таких длинных сессий становится все более дорогой и приводит к значительным задержкам в случае аннулирования кэша KV.
Это аннулирование происходит всякий раз, когда ИИ-система пытается переключить модели посреди сессии — например, перенаправляя сложный этап рассуждений на более крупную модель или переключаясь на модель поменьше для экономии средств. Поскольку разные LLM имеют разную архитектуру, они ожидают входящие данные кэша в различных форматах.
В результате любое переключение модели заставляет принимающую модель заново оплачивать всю стоимость предварительного заполнения с нуля для пересчета кэша KV накопленного контекста.
Сопоставление памяти между моделями без необходимости начинать все сначала
Исследователи Nvidia изучили перенос кэша KV между моделями, чтобы выяснить, как разработчики могут преобразовывать кэш KV одной модели в ожидаемый формат другой без повторного запуска фазы предварительного заполнения.
В случае успешного решения перенос кэша KV между моделями дает преимущества в обоих направлениях. Перенос от малой модели к крупной повышает качество результатов. Например, недорогая маленькая модель справляется с рутинными частями агентского рабочего процесса, но пасует перед сложной задачей на рассуждение — тогда вы переносите кэш KV в более крупную модель и беспрепятственно продолжаете процесс.
С другой стороны, перенос от крупной модели к малой снижает вычислительные затраты. Высокопроизводительная крупная модель может использоваться для разбора массивного сложного системного промпта или синтеза плотного PDF-файла в начале сессии. Как только эта тяжелая работа выполнена, кэш KV сессии уменьшается и отображается на более скромную и экономичную модель, которая справляется с быстрыми последовательными репликами в диалоге.
Ранее уже предпринимались попытки решить проблему переноса кэша KV, но они страдали от ряда существенных ограничений. К ним относятся необходимость дорогостоящего обучения на основе градиентов или очень жесткие архитектурные ограничения.
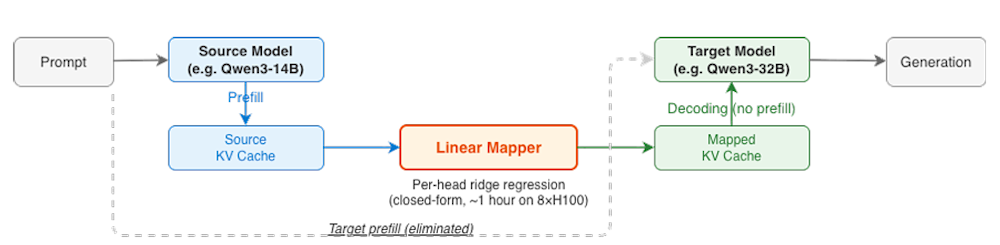
Межмодельный перенос кэша KV (источник: arXiv)
Для этого первоначального исследования авторы ограничили фокус переносом внутри семейств — например, переходом между моделями разного размера в семействах Qwen, Llama или Ministral. Эти модели используют общие токенизаторы, ДНК обучающих данных и базовые архитектурные стили, но отличаются по размеру и глубине. Тем не менее, этот фреймворк оставляет большой простор для будущих экспериментов. Исследователи отмечают, что в конечном итоге технику можно будет распространить на перенос между разными семействами, с несовпадающим количеством головок KV (KV heads) или на гибридные архитектуры, объединяющие стандартное внимание (attention) с другими механизмами памяти.
Ключевой вывод исследования Nvidia заключается в том, что межмодельный кэш KV имеет выраженную линейную структуру. Это означает, что сопоставление можно выполнять с помощью простых алгебраических трюков, без необходимости тяжелого обучения нейросетей. Например, экспериментируя с переносом кэша KV из модели Qwen3 с 14 миллиардами параметров в версию с 32 миллиардами параметров, авторы обнаружили, что простое сопоставление методом линейной регрессии из одного исходного слоя в целевой позволяет восстановить 56% дисперсии в ключах целевой модели и 32% дисперсии в ее значениях. При объединении нескольких исходных слоев эти показатели возрастали до 79% и 65% соответственно.
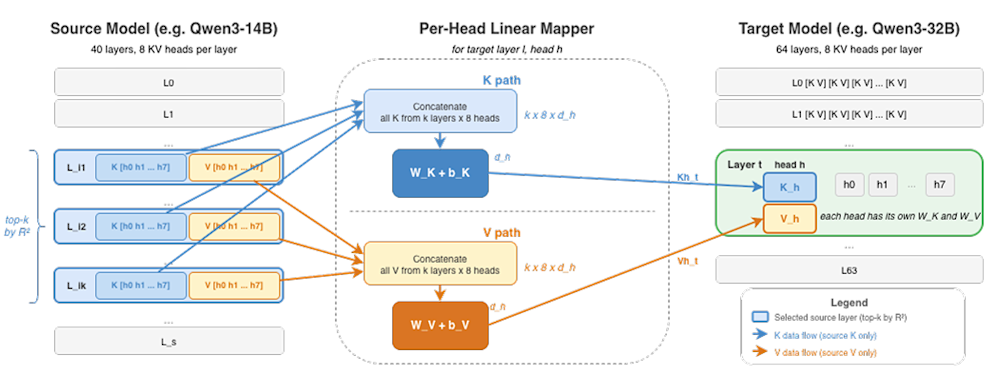
Трехслойное решение Nvidia для переноса кэша KV (источник: arXiv)
Чтобы воплотить эту линейную взаимосвязь в практическую систему, исследователи разработали замкнутый (closed-form) гребневый сопоставитель (ridge mapper) для каждой головки внимания, состоящий из трех ключевых компонентов:
-
Гребневая регрессия для каждой головки (Per-head ridge regression): Вместо использования сложного глубокого обучения для тренировки системы, они настраивают простую линейную регрессию, используя крошечный калибровочный набор из нескольких сотен текстовых последовательностей. Этот метод решает классическую задачу поиска линии наилучшего соответствия независимо для каждой головки внимания.
-
Межслойный выбор источников (Cross-layer source selection): Поскольку исходная и целевая модели имеют разное количество слоев, сопоставитель оценивает и выбирает наиболее предсказуемые исходные слои для передачи в каждый конкретный целевой слой. Таким образом, система выбирает только самые полезные фрагменты памяти из старой модели для формирования памяти новой модели.
-
Сопоставление в пространстве содержимого (Content-space mapping): Перед трансляцией данных сопоставитель удаляет кодирования RoPE. RoPE (Rotary Position Embedding — поворотное позиционное кодирование) представляет собой стандартный механизм, который применяет математическое вращение данных в зависимости от позиции, чтобы модель понимала порядок токенов в последовательности. Удаление значений RoPE позволяет сопоставителю обобщать данные на последовательности, длина которых превышает объем обучающих данных.
Проверка линейного сопоставителя в деле
Чтобы проверить работоспособность метода, исследователи оценили конвейер переноса на шести семействах моделей с «согласованным кэшем KV» (matched-KV). Согласованный кэш KV означает, что исходная и целевая модели имеют одинаковое количество головок KV и размерности на одну головку, что типично для моделей разного размера в рамках одного семейства.
Семейства моделей включали Qwen3, Llama 3.1 и Ministral 3, при этом тесты переноса кэша KV проводились для разных размеров — от 3 миллиардов до 70 миллиардов параметров. Эксперименты включали масштабный скачок параметров в 8,8 раза — от Llama 3.1 8B до 70B.
Для охвата широкого спектра задач модели оценивались по пяти основным бенчмаркам точности (ARC-Challenge, HellaSwag, WinoGrande, MMLU и GSM8K), а также по перплексии языкового моделирования на WikiText-2 и многошаговой разговорной задаче CoQA. Для настройки линейного транслирующего сопоставителя использовался крошечный калибровочный датасет, состоящий всего из 500 текстовых последовательностей по 1024 токена в каждой.
Исследователи сравнили фреймворк с базовым уровнем точности (baseline ceiling), при котором целевая модель выполняет полное традиционное предварительное заполнение. Они также сопоставили свою полную систему с конфигурациями с абляцией, такими как сокращение числа выбранных слоев или деактивация различных компонентов. Кроме того, они сравнили свой простой метод с глубокой нейросетью, обученной методом обратного распространения ошибки, чтобы выяснить, сможет ли более сложное глубокое обучение восстановить точность для пар, где линейный метод испытывал трудности.
Для четырех из шести протестированных пар быстрый замкнутый линейный гребневый сопоставитель сохранил от 73% до 98% автономной точности предварительного заполнения целевой модели, включая масштабный скачок от Llama 3.1 8B к 70B, где сохранилось 72,8% целевой точности.
Сопоставитель также работает в 2,7–25 раз быстрее, чем повторное предварительное заполнение. Например, при переносе кэша KV размером 32 768 токенов из модели Qwen3 14B в модель 32B перенос занял всего 278 миллисекунд по сравнению почти с 7 секундами для стандартного повторного префилла.
Система также продемонстрировала высокую стабильность в задачах, выполняемых в несколько этапов. При тестировании на многошаговых диалогах дрейф (или потеря точности) между базовым уровнем целевой модели и перенесенным кэшем оставался невероятно малым на протяжении 10 ходов, доказывая отсутствие риска каскадного сбоя во время длительных агентских сессий.
Тем не менее, простой линейный подход столкнулся с ограничениями на определенных парах моделей. Для двух конфигураций Ministral линейный сопоставитель резко ухудшил показатели, поскольку простая линейная подгонка не смогла экстраполировать данные вне калибровочного набора. Чтобы исправить это, исследователи заменили линейный сопоставитель нелинейным многослойным перцептроном (MLP) с двумя скрытыми слоями по 1024 нейрона, обученным на тех же данных. Это усложнило настройку и потребовало дополнительных затрат на обучение, но позволило восстановить точность выше 90%.
Более масштабная отраслевая проблема, чем та, которую может решить одна статья
Внедрение межмодельного переноса является частью более широкой общеотраслевой тенденции по устранению узкого места кэша KV, которое стало одним из главных препятствий на пути масштабирования корпоративного ИИ. Поскольку разработчики заставляют LLM обрабатывать массивы документов или кодовые базы и выполнять долгосрочные задачи на рассуждение, управление этим слоем памяти становится столь же важным, как и сами модели.
За последний год исследователи атаковали эту проблему вычислений и памяти с разных сторон. Например, компания Nvidia недавно представила динамическое разрежение памяти (DMS) — метод, который интеллектуально удаляет менее важные токены из кэша KV, сокращая расходы на рассуждения до 8 раз.
Другие подходы сосредоточены на агрессивном сжатии данных. Исследователи из MIT разработали технику алгебраического уплотнения под названием Attention Matching, которая сжимает кэш KV в 50 раз без ухудшения качества. Аналогичным образом Nvidia представила трансформирующее кодирование кэша KV (KVTC), заимствующее концепции сжатия медиаданных для уменьшения объема памяти в 20 раз без изменения базовых весов модели.
Помимо сжатия, исследователи также борются с вычислительными накладными расходами при извлечении памяти. Оптимизаторы вроде IndexCache устраняют избыточные вычисления слоев, обеспечивая значительно более высокую скорость получения первого токена в приложениях с длинным контекстом. А такие модели, как DeepSeek и серия GLM, оптимизируют кэш KV за счет архитектурных инноваций.
По мере того как системы ИИ берут на себя более долгосрочные задачи и используют более сложные архитектуры, базовая инфраструктура памяти становится столь же важной, как и сами модели. Межмодельный перенос кэша KV дает разработчикам еще один инструмент для снижения затрат на инференс при масштабировании многомодельных агентских систем.




