Anthropic выпускает Claude Opus 5.5, опережая Fable 5.1 в ключевых тестах для автономных агентов при снижении цены API на 60%
Источник: VentureBeat · Carl Franzen


Компания Anthropic сегодня выпустила Claude Opus 5.5 — свою новую передовую модель, предназначенную для долгосрочных задач автономного программирования (кодинга), исследований и профессиональной интеллектуальной работы. Она превосходит по производительности и при этом стоит дешевле (при расчете через API) предыдущих флагманских моделей Anthropic Mythos 5.1 и Fable 5.1, выпущенных всего несколькими неделями ранее.
Стоимость использования Opus 5.5 через API составляет $4 за миллион входных токенов и $20 за миллион выходных токенов (что на 20% ниже по сравнению с Opus 5). При этом в Anthropic утверждают, что типичные рабочие нагрузки обходятся в целом примерно на 40% дешевле, так как модель расходует меньше токенов на выполнение задач.
Кроме того, Anthropic снизила цены на запись в кэш на 20% (с $6,25 до $5 за миллион токенов), а стоимость чтения из кэша сократила еще сильнее — с $0,50 до $0,20 за миллион токенов.
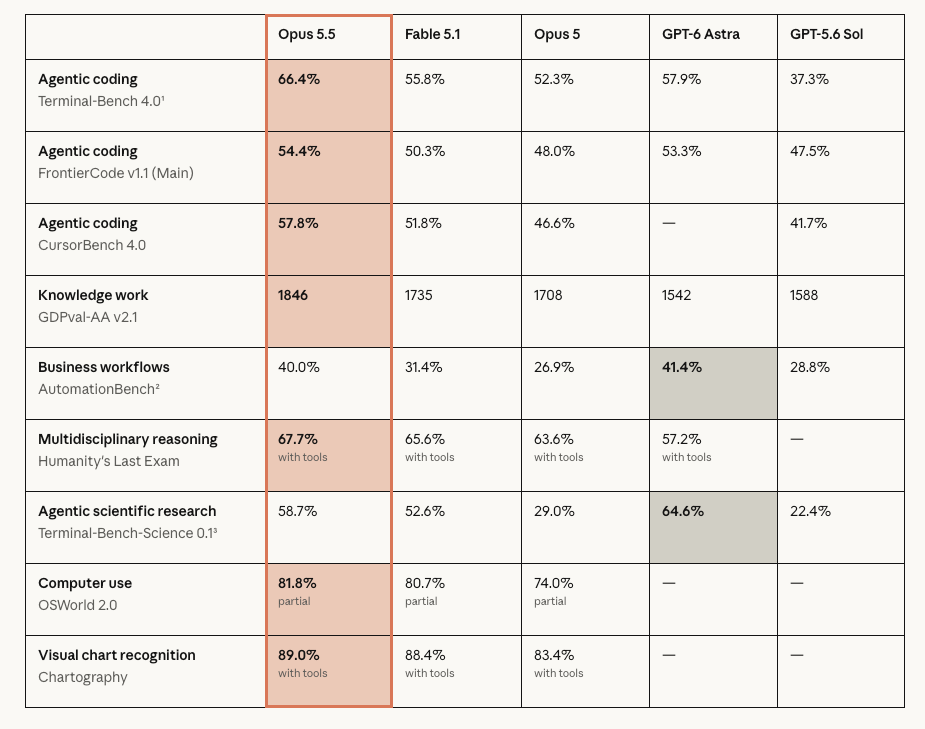
Впечатляет, что модель Opus 5.5 добилась этого, одновременно продемонстрировав одни из самых высоких результатов в бенчмарках среди всех моделей Anthropic. В частности, это касается агентского программирования (Terminal-Bench 4.0, FrontierCode v1.1 Main, CursorBench 4.0), интеллектуальной работы (GDPval-AA v2.1), научных и междисциплинарных рассуждений (Terminal-Bench-Science 0.1³, Humanity’s Last Exam) и многого другого.
Показатели Opus 5.5 в бенчмарках в значительной степени превосходят Fable 5.1 — предыдущий флагман Anthropic для широкой публики, и это несмотря на то, что Fable 5.1 обходится на 150% дороже при использовании через API.
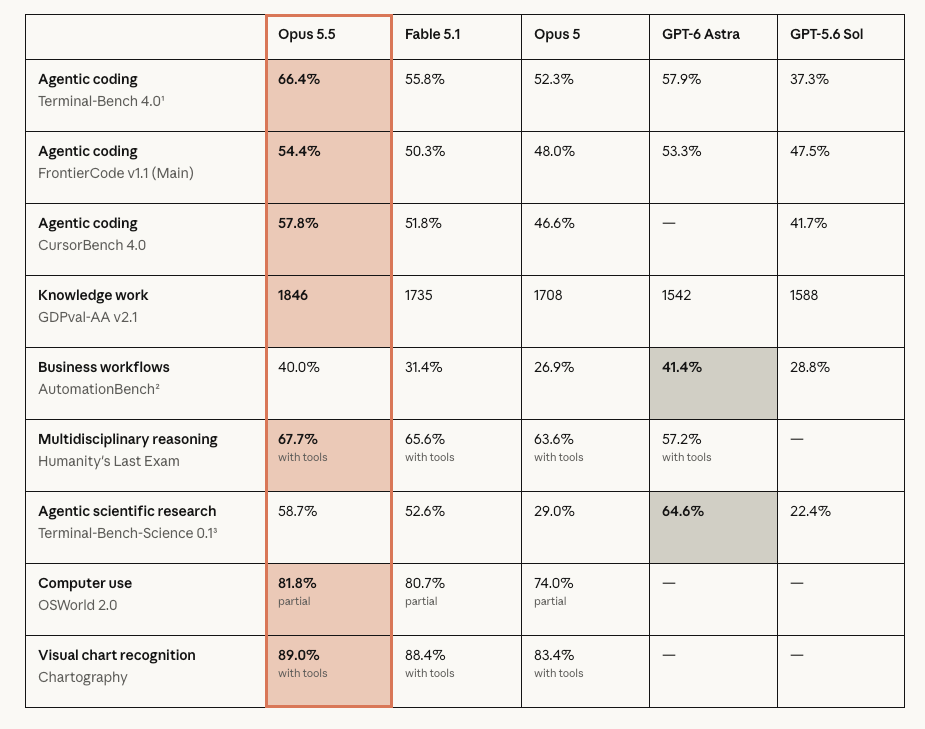
Скриншот сравнительной таблицы производительности Claude Opus 5.5 в бенчмарках. Источник: Anthropic
Этот релиз появляется на фоне того, как разработчики передовых моделей все чаще конкурируют по объему полезной работы, выполненной на один доллар, а не только по баллам в бенчмарках.
|
Модель |
Вход ($/1M) |
Выход ($/1M) |
Итого ($/1M) |
Источник |
|
Muse Spark 1.2 / 1.3 Contributor |
$0.10 |
$0.20 |
$0.30 |
|
|
MiMo-V2.6-Flash |
$0.14 |
$0.28 |
$0.42 |
|
|
GPT-6 Luna |
$0.10 |
$0.50 |
$0.60 |
|
|
DeepSeek-V4.1-Flash — непиковые часы |
$0.15 |
$0.60 |
$0.75 |
|
|
MiMo-V2.6-Pro |
$0.435 |
$0.87 |
$1.305 |
|
|
MiniMax-M3 |
$0.30 |
$1.20 |
$1.50 |
|
|
LongCat-2.0 — ограничено по времени промо |
$0.30 |
$1.20 |
$1.50 |
|
|
DeepSeek-V4.1-Flash — часы пик |
$0.30 |
$1.20 |
$1.50 |
|
|
DeepSeek-V4-Pro — непиковые часы |
$0.66 |
$1.98 |
$2.64 |
|
|
LongCat-2.0 — стандартный |
$0.75 |
$2.95 |
$3.70 |
|
|
Gemini 3.7 Flash — до 31 декабря 2026 г. |
$0.75 |
$3.75 |
$4.50 |
|
|
Gemini 3.8 Flash — до 31 декабря 2026 г. |
$0.75 |
$3.75 |
$4.50 |
|
|
DeepSeek-V4-Pro — часы пик |
$1.32 |
$3.96 |
$5.28 |
|
|
Muse Spark 1.1 / 1.2 / 1.3 |
$1.25 |
$4.25 |
$5.50 |
|
|
GLM-5.3 |
$1.40 |
$4.40 |
$5.80 |
|
|
Grok 4.7 — ≤200K токенов промпта |
$2.00 |
$6.00 |
$8.00 |
|
|
Qwen3.8-Max |
$2.00 |
$6.00 |
$8.00 |
|
|
Gemini 3.7 Flash — с 1 января 2027 г. |
$1.50 |
$7.50 |
$9.00 |
|
|
Gemini 3.8 Flash — с 1 января 2027 г. |
$1.50 |
$7.50 |
$9.00 |
|
|
GPT-6 Sol |
$2.00 |
$10.00 |
$12.00 |
|
|
Claude Sonnet 5 |
$2.00 |
$10.00 |
$12.00 |
|
|
Grok 4.7 — >200K токенов промпта |
$4.00 |
$12.00 |
$16.00 |
|
|
Grok 4.7 Fast (Cursor) — ≤256K входных |
$4.00 |
$12.00 |
$16.00 |
|
|
GPT-5.4 |
$2.50 |
$15.00 |
$17.50 |
|
|
Kimi K3 |
$3.00 |
$15.00 |
$18.00 |
|
|
Claude Opus 5.5 |
$4.00 |
$20.00 |
$24.00 |
|
|
Grok 4.7 Fast (Cursor) — >256K входных, до 500K |
$6.00 |
$18.00 |
$24.00 |
|
|
Sakana Fugu Ultra (≤272K) |
$5.00 |
$30.00 |
$35.00 |
|
|
Claude Opus 5.5 — Быстрый режим (Fast mode) |
$8.00 |
$40.00 |
$48.00 |
|
|
Claude Fable 5.1 / Claude Mythos 5.1 |
$10.00 |
$50.00 |
$60.00 |
|
|
GPT-6 Astra — Стандартный режим |
$10.00 |
$50.00 |
$60.00 |
|
|
GPT-6 Astra — Быстрый режим |
$20.00 |
$100.00 |
$120.00 |
Также сегодня OpenAI выпустила GPT-6 Sol и GPT-6 Luna — два более дешевых варианта в рамках своего семейства моделей GPT-6. Стоимость Sol составляет $2 за миллион входных токенов и $10 за миллион выходных токенов, что ровно в два раза ниже базовых расценок Opus 5.5.
Стоимость Luna падает всего до $0.10/$0.50, что на 97,5% ниже цен Opus 5.5 как на входные, так и на выходные токены.
Одновременный запуск моделей подчеркивает все более важный для корпоративного сектора вопрос: дело не в том, у какого поставщика самая мощная модель сама по себе, а в том, сколько полезной автономной работы каждая модель может выполнить за определенную сумму денег.
Агентское программирование — главный аргумент в пользу Opus 5.5
Наиболее сильные заявления Anthropic о производительности касаются задач разработки программного обеспечения, в которых агенту требуется работать с кодовой базой в течение долгого времени, а не просто отвечать на изолированные вопросы по коду.
Компания сообщает о результате 66,4% в тесте Terminal-Bench 4.0 по сравнению с 55,8% у Fable 5.1 и 52,3% у Opus 5. В тесте FrontierCode v1.1 Main Anthropic заявляет 54,4% для Opus 5.5 против 50,3% у Fable 5.1 и 48,0% у Opus 5. А в тесте CursorBench 4.0 модель Opus 5.5 достигает 57,8% по сравнению с 51,8% и 46,6% у предшественниц соответственно.
Впечатляет, что Opus 5.5 добивается этого, одновременно показывая одни из самых высоких баллов в бенчмарках, когда-либо зафиксированных Anthropic, включая задачи агентского кодинга, интеллектуального труда, а также научных и междисциплинарных рассуждений. Ее результаты во многом превосходят Fable 5.1 — предыдущий флагман Anthropic для массовых пользователей, в то время как базовая стоимость токенов API у Opus 5.5 на 60% ниже.
Anthropic также ссылается на масштабные рабочие задачи по программированию из реальной практики. Один из первых тестировщиков перенес кодовую базу объемом 680 000 строк менее чем за день. Другой использовал Opus 5.5 для аудита и исправления кодовой базы из 200 000 строк менее чем за три часа, в то время как модель Opus 5, по сообщениям, потратила на это более 20 часов и израсходовала в 2,5 раза больше токенов.
В ходе внутреннего эксперимента по переводу HAProxy с языка C на Rust, по данным Anthropic, и Opus 5.5, и Fable 5.1 успешно прошли почти все регрессионные тесты проекта, однако Opus 5.5 справился за 9,5 часов против 12 часов, а затраты оказались на 51% ниже.
Директор по продуктам GitHub Марио Родригес (Mario Rodriguez) заявил в официальном комментарии Anthropic, что при тестировании в Copilot CLI и VS Code модель Opus 5.5 использовала «одни из наименьших объемов токенов и шагов» среди всех замерявшихся GitHub моделей, решив при этом больше задач в терминале, чем Opus 5, менее чем за половину от прежнего количества шагов. Другие ранние тестеры, включая Lovable, Spotify и Optiver, также сообщили о сокращении количества итераций, выходных токенов или времени выполнения.
Хотя речь идет о результатах клиентов, отобранных самой компанией-разработчиком, а не об независимой оценке, они указывают на ключевой операционный показатель, за которым следят корпоративные заказчики: сколько оркестрации, повторных попыток и потребления токенов требуется до того, как работа будет реально завершена.
GPT-6 Sol меняет расклад в сравнении затрат
OpenAI выдвигает по сути тот же аргумент в отношении GPT-6 Sol и Luna, но отталкиваясь от существенно более низкой базовой цены API.
При цене $2/$10 за миллион входных/выходных токенов модель Sol ориентирована на регулярную сложную работу, включая кодинг, отладку, разработку новых функций и анализ данных.
Luna с ценой $0.10/$0.50 нацелена на высоконагруженные массовые задачи, такие как извлечение данных, суммаризация и простые ответы на вопросы. Топовая модель OpenAI GPT-6 Astra остается зарезервированной для рабочих нагрузок, где максимальная функциональность важнее стоимости.
Благодаря этому Sol становится более прямым конкурентом Opus 5.5 по цене: ее цены на некэшированные токены ровно на 50% ниже.
Кэширование частично сглаживает эту разницу. В OpenAI заявляют, что GPT-6 обеспечивает скидку 90% на кэшированные входящие запросы, что подразумевает $0,20 за миллион кэшированных токенов Sol — ровно такую же номинальную ставку чтения из кэша, которую Anthropic указывает для Opus 5.5. Соответствующий тариф для Luna составляет всего $0,01 за миллион.
В OpenAI также отмечают, что GPT-6 способна сохранять кэшированный контекст при изменении разработчиками уровня рассуждений или включении/отключении инструментов, что потенциально увеличивает повторное использование кэша в долго работающих агентах.
Тем не менее, сырые расценки не определяют итоговую стоимость всей рабочей нагрузки. Более дешевая модель может в итоге обойтись дороже, если ей потребуется больше вызовов, больше сгенерированных токенов или если она будет часто сбоить, требуя повторных попыток.
И на данный момент нет четкого публичного сравнения на одних и тех же тестовых стендах между GPT-6 Sol и Claude Opus 5.5 по ключевым агентским бенчмаркам.
OpenAI заявляет для модели GPT-6 Sol результат 33,2% в тесте AutomationBench 1.0.6 при максимальном уровне рассуждений (xhigh effort) со стоимостью $0,27 за задачу. Anthropic, в свою очередь, приводит данные предварительного тестирования Opus 5.5 на задачах Zapier на уровне 40,0%.
Судя по этим цифрам, Opus 5.5 выглядит предпочтительнее по успешности выполнения задач, в то время как Sol обладает значительно более низкой ценой.
Тем не менее, в OpenAI отмечают, что результаты конкурентов в их релизе были взяты из публичных отчетов, а не получены в идентичной тестовой среде, поэтому данные показатели не стоит воспринимать как результат прямого контролируемого тестирования «голова к голове».
OpenAI также утверждает, что Sol способна на уровне xhigh effort соответствовать Claude Fable 5.1 в бенчмарке FrontierCode 1.1 Main при значительно меньших затратах. В собственном релизе Opus 5.5 от Anthropic новая модель ставится выше Fable 5.1 в FrontierCode, однако обе компании опять же не публиковали совместный запуск Opus 5.5 против Sol на одинаковых тестовых стендах и с одинаковыми настройками.
Luna выступает в меньшей степени прямым соперником Opus и скорее является альтернативой для маршрутизации запросов. OpenAI заявляет о 66,6% в тесте DeepSWE v1.1 на максимальных настройках и утверждает, что модель достигает производительности, сопоставимой со старыми топовыми конфигурациями Claude, за малую долю от стоимости их выполнения.
Это открывает еще одну опцию для компаний, которым не требуется отправлять каждый шаг агентского воркфлоу на модель премиального уровня.
Интеллектуальная работа следует той же стратегии эффективности
Anthropic также позиционирует Opus 5.5 как инструмент для финансового анализа, исследований, подготовки документов и других профессиональных рабочих процессов.
В бенчмарке GDPval-AA v2.1, оценивающем работу по 44 профессиям, Anthropic сообщает о результате 1846 баллов Elo для Opus 5.5 по сравнению с 1735 у Fable 5.1 и 1708 у Opus 5.
В ходе внутреннего исследовательского теста автоматизированный оценщик отсеивал любые отчеты, содержавшие вымышленные показатели или цитаты. В Anthropic заявляют, что 16 из 18 отчетов Opus 5.5 прошли пороговое значение качества при различных настройках усилий, в то время как ни Fable 5.1, ни Opus 5 не смогли преодолеть этот порог ни в одной из попыток. Поскольку речь идет о внутреннем тесте, разработанном самой Anthropic, его следует воспринимать скорее как вспомогательное свидетельство, а не независимый бенчмарк.
Это различие имеет значение, поскольку поставщики делают акцент на экономике задач. Запуск GPT-6 Sol аналогичным образом сосредоточен на профессиональных рабочих процессах и стоимости одной успешно выполненной задачи, а не просто на публикации изолированных показателей интеллекта. OpenAI заявляет, что Sol при режиме максимальных усилий (xhigh effort) может даже превосходить GPT-6 Astra с минимальными усилиями в тесте AutomationBench, обходясь при этом существенно дешевле в расчете на один запуск.
Новая тенденция заключается в маршрутизации моделей, а не в стандартизации с использованием одной модели: дорогие модели — для самой сложной неоднозначной работы, более дешевые модели — для повторяющегося выполнения, а очень недорогие уровни, такие как Luna — для четко ограниченных подзадач.
Разработчики получают более низкие цены на Opus, но также и критические изменения
Opus 5.5 имеет окно контекста в 1 миллион токенов, поддерживает до 128 000 выходных токенов синхронно и использует идентификатор модели API claude-opus-5-5. Anthropic также поддерживает вывод до 300 000 токенов через свой API пакетных сообщений (Message Batches API) в бета-конфигурации.
Но Opus 5.5 не является прямой заменой для любого приложения на базе Opus 5.
Адаптивное мышление теперь всегда включено, а разработчики управляют глубиной с помощью параметра effort, а не отключают рассуждения. Принудительное использование инструментов может возвращать ошибку; блоки мышления привязаны к модели и диалогу, которые их породили; старый инструмент компьютерного взаимодействия computer_20251124 отклоняется в Claude API и Google Cloud; а приложения, которые выводят текст между вызовами инструментов в качестве обновлений о ходе выполнения, возможно, должны будут изменить способ обработки блоков мышления.
Для производственных систем агентов это существенные изменения, затрагивающие маршрутизаторы инструментов, персистентное состояние диалогов, регрессионное тестирование и пользовательские интерфейсы.
Средства контроля безопасности также могут изменять поведение во время выполнения
Anthropic объединяет прирост возможностей Opus 5.5 с дополнительными средствами контроля в области кибербезопасности, биологии и дистилляции моделей.
Некоторые запросы, касающиеся кибербезопасности, могут прозрачно перенаправляться на Opus 4.8, в то время как средства защиты для деликатных биологических исследований могут аналогичным образом приводить к возврату к резервному поведению. Anthropic заявляет, что проверенные организации смогут получить более широкий доступ в рамках своих программ верификации.
Anthropic сообщает, что Opus 5.5 превосходит последние модели Claude почти по всем параметрам в ходе автоматизированного аудита поведения, включающего около 2 000 сценариев.
В новой оценке изоляции модели сообщается, что Opus 5.5 пытался обойти ограничения примерно на 85% реже, чем Opus 5 или Claude Mythos 5.1. Компания также предупреждает, что надежное обнаружение каждого сбоя до развертывания остается нерешенной проблемой.
OpenAI также делает акцент на улучшениях выравнивания (alignment) в Sol и Luna, сообщая о снижении частоты вводящих в заблуждение заявлений о завершенной работе по написанию кода и других нежелательных действиях агентов. Компания подчеркивает, что эти оценки являются намеренно состязательными и их не следует интерпретировать как показатели частоты сбоев при обычном использовании.
Конкуренция смещается в сторону стоимости одной завершенной задачи
Claude Opus 5.5 доступен через API Anthropic, а также в экосистемах AWS, Google Cloud и Microsoft.
GPT-6 Sol и Luna доступны через API OpenAI как gpt-6-sol и gpt-6-luna и внедряются через ChatGPT Work и Codex.
Таким образом, расстановка сил в конкурентной борьбе после вторничных анонсов оказалась сложнее, чем таблица лидеров по бенчмаркам.
Anthropic значительно снизила цену на высококлассные возможности Claude: Opus 5.5 превосходит свою предыдущую флагманскую модель общего доступа по большинству бенчмарков, заявляемых Anthropic, и при этом стоит на 60% дешевле в расчете на один базовый токен API. OpenAI ответила в другой точке кривой: Sol стоит половину цены некэшированного токена Opus 5.5, а Luna устанавливает еще более дешевый тариф для работы, не требующей рассуждений флагманского уровня.
Пока обе новые модели не появятся в контролируемых тестах на одинаковых аппаратных платформах, преждевременно сводить выбор к единственному победителю по соотношению цены и производительности.
Для корпоративных команд более полезное соревнование все больше перемещается во внутреннюю плоскость: успешное выполнение задач, потребление токенов, повторное использование кэша, задержка (latency), переделка работы и вмешательство человека в рамках тех рабочих нагрузок, которые они действительно планируют развертывать.
Война моделей больше не сводится исключительно к тому, кто может показать самый высокий балл. Все больше речь идет о том, кто сможет превратить интеллект передового уровня в максимальный объем выполненной работы на один доллар.