Замена RAG на bash cut снижает затраты на извлечение данных ИИ на 30%


Когда агентные рабочие процессы дают сбой, разработчики часто предполагают, что проблема заключается в способностях базовой модели к рассуждениям. На практике же основным ограничивающим фактором зачастую выступает ограниченный объем информации, предоставляемый интерфейсом поиска.
Исследователи из нескольких университетов предлагают метод под названием прямое взаимодействие с корпусом (direct corpus interaction — DCI), который позволяет агентам полностью обходить эмбеддинг-модели, выполняя поиск по необработанным корпусам напрямую с помощью стандартных инструментов командной строки.
Ограничения классического поиска
В классических поисковых системах, таких как RAG, документы разбивают на фрагменты, преобразуют в векторные представления (или эмбеддинги) и индексируют оффлайн в векторной базе данных. Когда система ИИ обрабатывает запрос, поисковый модуль фильтрует всю базу данных, чтобы вернуть ранжированный «топ-k» список фрагментов документов, соответствующих запросу. Все доказательства должны пройти через этот механизм оценки до того, как начнутся какие-либо последующие рассуждения.
Но современные агентские приложения требуют гораздо большего. «Плотный поиск очень полезен для широкого семантического извлечения, но когда агенту нужно решить многоэтапную задачу, ему часто требуется искать точные строки, числа, версии, коды ошибок, пути к файлам или разреженные комбинации улик», — отмечают авторы статьи о DCI в комментариях для VentureBeat. — «Именно в этих деталях с длинным хвостом семантическое сходство может оказаться ненадежным».
В отличие от статического поиска, агенты также должны динамически пересматривать свои планы поиска после наблюдения частичных или локализованных данных. Точные лексические ограничения и многоэтапное уточнение гипотез трудно реализуемы с помощью семантических поисковых систем. Поскольку поисковый модуль сжимает доступ до одного шага, любые критические свидетельства, отсеянные поиском по сходству, не могут быть восстановлены позже, какими бы продвинутыми ни были возможности агента по последующим рассуждениям. Как поясняют авторы, текущие поисковые конвейеры могут стать узким местом, поскольку «слишком рано решают, что агенту разрешено видеть».
Прямое взаимодействие с корпусом
Этот прямой доступ решает фундаментальную проблему корпоративных сред — устаревание данных. Индексы эмбеддингов всегда представляют собой снимок конкретного момента времени, на создание и поддержание которого уходит значительное время и вычислительные ресурсы.
«Во многих корпоративных средах данные не представляют собой стабильную коллекцию документов. Это ежедневные финансовые отчеты, живые логи, тикеты, коммиты кода, файлы конфигурации, хронологии инцидентов и внутренние документы, которые постоянно меняются», — говорят авторы. DCI позволяет агенту рассуждать о текущем состоянии рабочей среды, а не о вчерашнем векторном индексе.
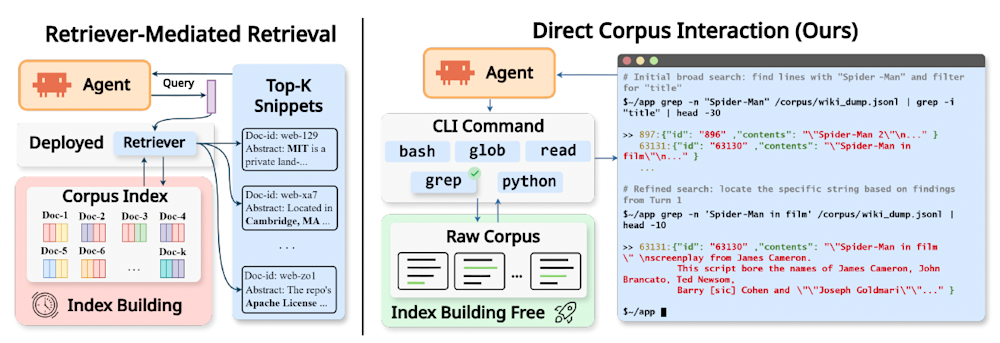
Прямое взаимодействие с корпусом (DCI) против классического поиска (источник: arXiv)
Агент работает в среде, напоминающей терминал, где его наблюдениями являются сырые результаты работы инструментов, такие как пути к файлам, совпавшие текстовые фрагменты и окружающие строки. Основные инструменты, предоставляемые DCI, немногочисленны, но обладают высокой выразительностью. Агенты используют такие команды, как «find» и «glob», для навигации по структуре каталогов и поиска файлов. Для точного сопоставления применяются «grep» и «rg», позволяющие находить конкретные ключевые слова, регулярные выражения и точные строки. Когда требуется локальный осмотр, такие инструменты, как «head», «tail», «sed», «cat» и легковесные скрипты на Python, позволяют агенту заглянуть в контекст вокруг совпадения или прочитать определенные разделы файла.
Агент может комбинировать эти инструменты с помощью конвейеров оболочки (shell pipelines) для выполнения сложной логики поиска за один шаг. Агент может передавать команды по конвейеру для обеспечения жестких лексических ограничений, например, искать в файле один термин, а затем передавать вывод дальше для поиска второго термина. Он может объединять несколько слабых улик по всему корпусу, находя определенный тип файла, ища ключевое слово вроде «report» и фильтруя по году вроде «2024». Он также может мгновенно проверить гипотезу, изучив точные строки вокруг совпадения ключевого слова.
DCI делегирует семантическую интерпретацию непосредственно агенту, а не полагается на поиск сходства на основе эмбеддингов. Агент может формулировать гипотезы, тестировать точные лексические паттерны и извлекать подробную информацию, которую традиционный семантический поисковик может упустить.
Исследователи предлагают две версии этой системы. DCI-Agent-Lite создана как легкая, недорогая установка на базе модели GPT-5.4 nano, строго ограниченная взаимодействием с терминалом (вроде bash-команд) и базовым чтением файлов. Поскольку чтение «сырых» файлов может быстро забить память небольшой модели, эта версия опирается на легковесные стратегии управления контекстом во время выполнения для поддержания долгосрочных исследований.
DCI-Agent-CC — это более производительная версия, разработанная для команд с большим бюджетом на вычисления. Она работает на Claude Code под управлением Claude Sonnet 4.6. Claude Code обеспечивает более качественный промптинг, надежную оркестрацию инструментов и превосходную встроенную обработку контекста, что повышает стабильность агента во время сложных многоэтапных поисков по разнородным наборам данных.
DCI в действии
Исследователи протестировали обе версии DCI на таких бенчмарках агентского поиска, как BrowseComp-Plus, задачи QA (вопрос-ответ) с интенсивным использованием знаний, требующие одношаговых и многошаговых рассуждений, а также задачи ранжирования при информационном поиске, требующие доменно-специфичных рассуждений и проверки научных фактов.
Они протестировали DCI в сравнении с тремя базовыми линиями (baseline). Первая включала агентов поиска с открытыми весами, таких как Search-R1, и проприетарных агентов на базе передовых моделей (вроде GPT-5 и Claude Sonnet 4.6), работающих в паре со стандартными поисковыми системами. Вторая базовая линия включала классические разреженные поисковики вроде BM25 и плотные поисковики, такие как OpenAI text-embedding-3-large и Qwen3-Embedding-8B. Третья базовая линия состояла из высокопроизводительных реранкеров, ориентированных на рассуждения, таких как ReasonRank-32B и Rank-R1.
DCI систематически превосходила базовые линии, по словам исследователей. На сложном бенчмарке BrowseComp-Plus замена традиционного семантического поисковика Qwen3 на DCI с бэкэндом Claude Sonnet 4.6 повысила точность с 69,0% до 80,0%, одновременно снизив затраты на API с $1440 до $1016. Окупаемость инвестиций для легковесных агентов также оказалась заметной. DCI-Agent-Lite с моделью GPT-5.4 nano конкурировала с моделью OpenAI o3, использующей традиционный поиск, при этом сократив расходы более чем на $600.
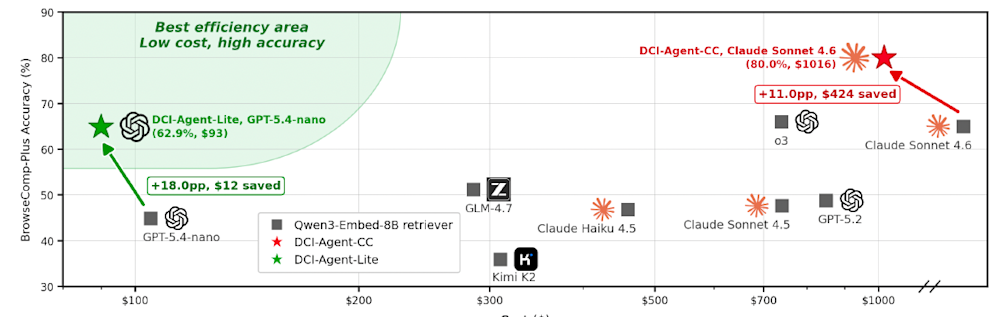
DCI повышает производительность и существенно снижает затраты (источник: arXiv)
На бенчмарках многошагового QA (вопрос-ответ) DCI-Agent-CC достигла средней точности в 83,0%, превзойдя сильнейший базовый вариант с открытыми весами на 30,7 пункта, отмечают исследователи.
Данные показывают, что у DCI общая полнота поиска документов (recall) ниже, чем у плотных моделей эмбеддингов, однако, найдя релевантный документ, система извлекает из него значительно больше ценности.
«Если бы руководитель отдела корпоративного ИИ спросил, где DCI наиболее явно полезна, я бы указал на задачи, требующие точной локализации свидетельств в динамичной рабочей среде: отладку производственных инцидентов, поиск по крупным кодовым базам, анализ логов, расследования на предмет соблюдения нормативных требований (комплаенс), аудиторские следы или многодокументный анализ первопричин», — отмечают исследователи.
В одной сложной глубокой исследовательской задаче агенту нужно было идентифицировать конкретный футбольный матч на основе 12 взаимосвязанных улик, включая точную посещаемость, желтые карточки и даты рождения игроков. Традиционный поисковик потерпел бы неудачу, выдавая короткие, несвязанные фрагменты. Вместо этого агент DCI исследовал каталог файлов, прочитал конкретные строки отчета о матче между сборными Англии и Бельгии 1990 года, чтобы проверить точное количество замен, вытащил цитату из файла интервью и сверил точные даты рождения двух игроков, заглянув в их текстовые файлы Wikipedia. Связывая эти простые команды в цепочку, DCI гарантирует, что ни одно доказательство не будет безвозвратно утеряно за несовершенным алгоритмом семантического поиска.
Ограничения и практическая реализация DCI
У DCI есть четкая область эффективного применения: она отлично масштабируется по глубине поиска, но испытывает трудности с его шириной. Когда экспериментальный корпус был увеличен со 100 000 до 400 000 документов, точность системы значительно упала, а среднее количество вызовов инструментов возросло. Хотя DCI мощна после обнаружения перспективного документа, затраты на поиск этого первоначального полезного «якоря» резко возрастают по мере увеличения размера пространства кандидатов.
Кроме того, у DCI более низкая общая полнота поиска документов по сравнению с плотными моделями эмбеддингов. Она жертвует исчерпывающей полнотой ради высокой локальной точности. Если корпоративный рабочий процесс строго требует нахождения каждого отдельного релевантного документа во всем огромном наборе данных, DCI может оказаться неподходящим инструментом.
Предоставление агенту выразительных инструментов вроде неограниченной оболочки bash увеличивает задержки и вычислительные затраты из-за большого объема итеративных вызовов инструментов, необходимых для завершения поиска. Это также создает серьезные проблемы управления контекстом и безопасности для ИТ-отделов.
«Вызовы инструментов могут возвращать большие объемы данных; длинные траектории могут заполнить контекстное окно; а прямой доступ к терминалу требует песочницы, контроля прав и тщательной инженерии», — говорят авторы. Чтобы управлять контекстным окном, исследователи выяснили, что умеренное усечение и компактизация помогают агенту поддерживать более длительные поиски, в то время как чрезмерно агрессивное суммирование имеет тенденцию отбрасывать полезные улики.
Из-за этих реалий эксплуатации DCI не задумывалась как обязательная замена существующей векторной инфраструктуре. Скорее, она служит ее дополнением.
«По нашему мнению, для инженеров по оркестрации и архитекторов данных наиболее практичным шаблоном развертывания в ближайшей перспективе является гибридный», — говорят авторы. Семантический поиск по-прежнему может обеспечивать обнаружение кандидатов с высокой полнотой, когда намерение пользователя широко или недостаточно конкретизировано. «Затем DCI может работать как уровень точности и верификации: агент может осуществлять поиск внутри найденных документов, переходить от них к соседним файлам, проверять точные ограничения и объединять слабые сигналы в разных документах».
Исследователи опубликовали код DCI под либеральной лицензией MIT.
«В более долгосрочной перспективе DCI меняет наше представление о корпоративных данных. Данные нужно будет не просто хранить для людей или индексировать для поисковых систем — их потребуется организовывать для агентов, которые умеют проводить инспекции, сравнивать, использовать grep, трассировать и проверять», — заключают авторы. — «Имена файлов, временные метки, стабильные идентификаторы, метаданные, история версий и машиночитаемая структура становятся частью поискового интерфейса».