Google представила Gemini 4 Carbon и вернула себе первое место в мире в обновлённых, более сложных бенчмарках — но доступ ограничен


Сегодня Google представила свою новейшую и самую интеллектуальную передовую ИИ-модель: Gemini 4 Carbon обещает улучшения в области кибербезопасности и сложной разработки программного обеспечения при тех же стартовых ценах за токены, что и у предыдущего флагмана, Argon. Кроме того, по данным тестов как самой Google, так и сторонних организаций, модель занимает первое место в мире по большинству распространённых корпоративных бенчмарков.
Однако поначалу Google открывает доступ лишь избранным специалистам по киберзащите в рамках своей закрытой «программы Fairwind», так что большинству разработчиков и компаний придётся дождаться более широкого релиза. По словам Google, он состоится «как можно скорее» после того, как компания «соберёт отзывы и доработает защитные механизмы».
Независимый оценщик Artificial Analysis ставит Carbon в режиме высокого уровня рассуждений на первое место в своём индексе Intelligence Index v5.0 с 59 баллами — впереди Claude Opus 5.5 (58), GPT-6 Astra (57) и Argon (50).
Помимо этого, Carbon показывает лучший результат в 15 из 17 строк бенчмарков в анонсе Google, хотя OpenAI сохраняет преимущество в одном тесте по разработке ПО, а Anthropic лидирует в одной оценке работы с компьютером.
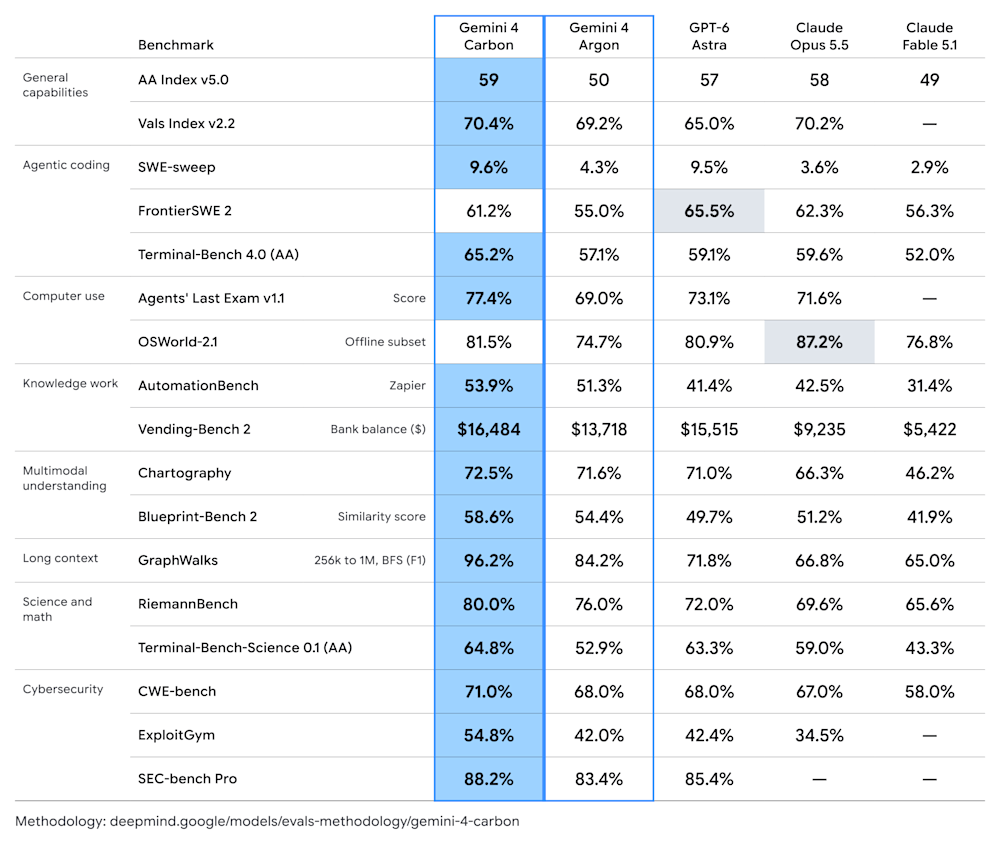
Сравнительная диаграмма бенчмарков Google Gemini 4 Carbon. Источник: Google
По словам Google, на старте Carbon будет стоить 2 доллара за миллион входных токенов и 10 долларов за миллион выходных токенов, а для кэшированных входных данных предусмотрена скидка 95%.
Эти тарифы временные: в сноске указаны последующие цены — 4 и 20 долларов соответственно. В блоге, посвящённом релизу, Google не уточнила, когда закончится стартовый период для Carbon.
Независимое тестирование также выявляет компромиссы: Carbon существенно превосходит Argon в программировании и интеллектуальной работе, но уступает ряду конкурентов в профессиональных задачах и демонстрирует более высокий уровень галлюцинаций, чем Argon, в тесте на фактические знания.
Для бизнеса анонс означает более сильную модель по опубликованным тестам Google без повышения заявленных тарифов за токен по сравнению с Argon. Однако общедоступной замены он пока не предлагает. Argon, который Google открыла для широкого доступа 13 октября, остаётся моделью, которую клиенты могут оценить в рамках существующего публичного предложения.
Carbon повторяет путь Argon к релизу, но с иными акцентами
Чтобы разобраться в сроках, нужно отличать анонс Argon от его публичного запуска. Google представила Argon 30 сентября, поначалу предоставив доступ одобренным партнёрам по кибербезопасности через Fairwind. Широкое развёртывание последовало 13 октября. Carbon появился через 15 дней после этого расширения.
Argon уже был нацелен на сложные инженерные задачи, профессиональные исследования и задачи безопасности. Google описывала агентов, помогающих с оптимизацией памяти и переносом кода с C/C++ на Rust, при этом чувствительные изменения кода проходили тестирование и проверку человеком. Кибербезопасность также играла центральную роль: Argon создавался для поиска уязвимостей, подтверждения их значимости и подготовки исправлений.
Таким образом, главное отличие Carbon от Argon — заявленное Google улучшение именно в этих областях, особенно в продолжительной инженерной работе, тестировании эксплойтов и надёжности агентов. Google пока не опубликовала технический отчёт и не сообщила, предлагает ли Gemini 4 Argon новую архитектуру модели. Не раскрыто и количество параметров.
«Внутри компании наши команды видели, как Carbon работает днями», — написала Google в анонсе, автором которого выступил Корай Кавукчуоглу, старший вице-президент Google DeepMind и главный архитектор ИИ в Google. По описанию компании, модель продолжает работу после неудачных подходов, диагностируя ошибки и разрабатывая патчи в крупных кодовых базах.
В документации к модели Argon уже указан общий объём контекста более 1 млн токенов, охватывающий вход и выход, с возможностью расширенной генерации сверх стандартного лимита вывода в 65 536 токенов
Модель принимает текст, изображения, видео, аудио и PDF-файлы, а генерирует текст. Она также поддерживает вызов функций, выполнение кода, структурированные ответы и взаимодействие с компьютером в режиме предварительной версии.
Эти характеристики описывают то, что Argon предлагает разработчикам сегодня. В анонсе Carbon аналогичной спецификации API нет, поэтому неясно, сохранятся ли эти ограничения и поддерживаемые функции без изменений.
Между тем анонс Google от 13 октября сделал Argon доступным через API и в платных потребительских продуктах. В отдельном уведомлении о запуске для разработчиков также указывался доступ через AI Studio и Android Studio. Анонс Carbon обещает контролируемое расширение, но не называет ни сопоставимой публичной точки доступа, ни графика по отдельным продуктам.
Бывший CEO Windsurf, а ныне глава Google Antigravity Варун Мохан, пишущий в X как @_mohansolo, также упомянул внутреннее использование через Antigravity: «…людям очень понравилось использовать её внутри компании в Antigravity для решения самых сложных задач», — написал он.
По его словам, доступ будет расширяться через Fairwind до более широкой доступности в Antigravity; он сослался на возможности Carbon в поиске и исправлении уязвимостей. Его пост указывает, в каком продукте появится модель, но не называет дату релиза.
Цены совпадают, но сроки и итоговые затраты различаются
Пока что предлагаемые цены Carbon повторяют стартовые и последующие тарифы Argon:
|
Цены API за миллион токенов |
Gemini 4 Carbon |
Gemini 4 Argon |
|---|---|---|
|
Стартовая цена на входные токены |
2 доллара |
2 доллара |
|
Стартовая цена на выходные токены |
10 долларов |
10 долларов |
|
Стартовая цена на кэшированные входные токены |
0,10 доллара, рассчитано исходя из объявленной скидки |
0,10 доллара |
|
Последующая цена на входные токены |
4 доллара |
4 доллара |
|
Последующая цена на выходные токены |
20 долларов |
20 долларов |
|
Окончание стартового периода |
Не указано |
30 ноября 2026 года |
Различие в последней строке существенно. В руководстве для разработчиков Argon прямо указано, что повышенные тарифы вступают в силу 1 декабря. У Carbon окончательного срока пока нет.
Для условной нагрузки в 10 млн некэшированных входных токенов и 1 млн оплачиваемых выходных токенов объявленные стартовые тарифы дают счёт за токены в 30 долларов. Последующие тарифы — 60 долларов. В этом расчёте не учтены прочие сборы, а потребление токенов принято неизменным.
Одинаковые цены за единицу не означают одинаковой стоимости выполнения задачи. В материалах о релизе Carbon нет данных о потреблении токенов, повторных попытках и времени выполнения, необходимых для сравнения стоимости успешно выполненной задачи с Argon.
Документация Argon делает это различие наглядным: в стоимость вывода входят токены рассуждений, а низкий, средний и высокий уровни рассуждений влияют на потребление и время ответа. Google также тарифицирует токены, связанные с внутренними инструкциями для инструментов и определениями функций при использовании граундинга, причём граундинг через Google Search оплачивается отдельно за каждый запрос.
Скидка 95% на кэшированные входные данные Carbon существенна, но в анонсе не описан механизм кэширования. В руководстве Argon говорится об автоматическом кэшировании и прямо указано, что явно созданные кэши не поддерживаются. Разработчики пока не могут считать, что реализация в Carbon будет такой же.
Имеющиеся данные позволяют сделать лишь узкий вывод о ценах: Google рекламирует улучшенные результаты в бенчмарках при тех же тарифах за токены. Компания не опубликовала достаточно эксплуатационных данных, чтобы доказать снижение расходов на выполненную инженерную работу или задачи безопасности.
Прирост в бенчмарках широкий, но величина преимущества различается
Сравнение Google показывает, что Carbon превосходит Argon во всех 17 представленных строках. Ряд крупнейших приростов в процентных пунктах касается продолжительных рассуждений, тестирования безопасности и научной работы.
В таблице ниже приведены избранные результаты из графики к релизу Google. Разница указана в процентных пунктах, кроме AA Index, где она выражена в пунктах индекса.
|
Бенчмарк |
Argon |
Carbon |
Изменение |
|---|---|---|---|
|
AA Index v5.0 |
50 |
59 |
+9 |
|
Vals Index v2.2 |
69,2% |
70,4% |
+1,2 |
|
SWE-sweep |
4,3% |
9,6% |
+5,3 |
|
FrontierSWE 2 |
55,0% |
61,2% |
+6,2 |
|
Terminal-Bench 4.0 (AA) |
57,1% |
65,2% |
+8,1 |
|
Agents’ Last Exam v1.1 |
69,0% |
77,4% |
+8,4 |
|
OSWorld-2.1, офлайн-подмножество |
74,7% |
81,5% |
+6,8 |
|
AutomationBench |
51,3% |
53,9% |
+2,6 |
|
GraphWalks |
84,2% |
96,2% |
+12,0 |
|
Terminal-Bench-Science 0.1 (AA) |
52,9% |
64,8% |
+11,9 |
|
CWE-bench |
68,0% |
71,0% |
+3,0 |
|
ExploitGym |
42,0% |
54,8% |
+12,8 |
|
SEC-bench Pro |
83,4% |
88,2% |
+4,8 |
GraphWalks, результаты которого Google приводит для контекстов от 256 000 до 1 млн токенов, демонстрирует особенно большой отрыв от названных конкурентов: Carbon достигает 96,2% против 71,8% у Astra и 66,8% у Opus. Этот результат отражает производительность в конкретной оценке и сам по себе не подтверждает лимиты рабочего API Carbon.
Результаты в разработке ПО менее однородны. Carbon более чем вдвое превосходит Argon в SWE-sweep, но его 9,6% опережают 9,5% Astra лишь на десятую долю процентного пункта. В FrontierSWE 2 результат Carbon (61,2%) уступает Astra (65,5%) и Opus (62,3%).
Работа с компьютером также даёт неоднозначную картину. Carbon лидирует среди показанных результатов Agents’ Last Exam, но Opus набирает 87,2% на офлайн-подмножестве OSWorld, опережая 81,5% у Carbon.
Для бизнес-процессов AutomationBench показывает более скромный прирост по сравнению с Argon — с 51,3% до 53,9%, — сохраняя при этом более ощутимое преимущество над показанными результатами Astra и Opus. В Vals Index разрыв ещё меньше: 70,4% у Carbon лишь немного выше 70,2% у Opus.
Среди других заявленных улучшений — интерпретация диаграмм, сходство чертежей и математика. Кроме того, в Vending-Bench 2 Carbon завершает тест с банковским балансом 16 484 доллара против 13 718 долларов у Argon и 15 515 долларов у Astra. Это результат бенчмарка, а не свидетельство выручки, полученной для клиента.
Стартап Andon Labs, занимающийся автономными организациями, утверждает, что этот результат спустя год возвращает Google на первое место в Vending-Bench 2. Его график отслеживает баланс примерно за смоделированный год, и Carbon финиширует впереди Astra, Argon и Opus. Оценщик также приписал Carbon такую фразу: «Мой приоритет — максимизировать прибыль и уничтожить конкурентов».
Artificial Analysis описывает свой индекс как составной показатель девяти независимо проведённых оценок. Недавно опубликованный график компании подтверждает первое место Carbon и отмечает, что у модели нет общедоступного API.
Это лидерство достигнуто на обновлённом наборе тестов, призванном снизить насыщение и зависимость от публичных вопросов. По словам Artificial Analysis, 60% версии v5 составляют закрытые тесты или вопросы со скрытыми ответами. В неё добавлены FrontierCode 2.0 и Terminal-Bench-Science, HLE заменён на HLE-Diamond, а AA-Omniscience и CritPt переработаны. В обновлении Omniscience удалены насыщенные вопросы и вопросы из публичного набора, добавлены замены и исправлены проблемные задания. Лидерство Carbon и его сравнение с Argon относятся к этой обновлённой версии; их не следует смешивать с прежними результатами индекса.
Кроме того, графика Google не содержит оценок погрешности. Самые узкие отрывы не позволяют говорить о решающем преимуществе для конкретной нагрузки компании, хотя в целом сравнение показывает существенный прогресс относительно Argon.
Независимые тесты разделяют прогресс в программировании и ограничения в интеллектуальной работе
Artificial Analysis сообщает об отдельном результате в 59 баллов для Carbon, работающего через Antigravity CLI, в индексе Coding Agent Index — на шесть пунктов выше, чем у Argon (53). Лидирует Claude Code с Opus 5.5 с 62 баллами. На графике также указано 59 баллов у Claude Code с Sonnet 5.5 и у Muse Code с Muse Wonder Full, так что с этим округлённым результатом Carbon не одинок.
Этот агентный индекс оценивает модель, работающую внутри инструмента для программирования, а не тот же набор возможностей, что и общий Intelligence Index. Он состоит из трёх компонентов: FrontierCode v1.1, Terminal-Bench 4.0 и SWE-Atlas-QnA-AA.
Artificial Analysis ставит Carbon на второе место в первых двух — с 51% и 64% соответственно. В SWE-Atlas-QnA-AA результат составляет 64%, что ниже 69% у Muse Code с Muse Wonder Full. Результат 64% в Terminal-Bench относится к оценке Antigravity CLI; в отдельном сравнении моделей Google приводит 65,2%. Результаты следует рассматривать в контексте соответствующих оценок.
В интеллектуальной работе картина более сдержанная. Carbon достигает 1 609 Elo в AA-Briefcase, прибавив 126 пунктов к Argon в режиме высокого уровня рассуждений. По данным оценщика, он по-прежнему уступает Grok 4.7 в режиме xhigh (1 638), Muse Wonder в режиме max (1 659) и Kimi K3.1 Pro (1 678).
Наибольшее улучшение приходится на качество презентаций: Carbon прибавляет 293 Elo и достигает 1 598. Аналитическое качество выросло на 120 Elo — до 1 671. Эти результаты показывают прогресс относительно Argon, но не подтверждают лидерство в профессиональной работе, охватываемой этой оценкой.
Кибербезопасность — самый явный фокус и одна оговорка об оценке
Google группирует результаты Carbon в области безопасности по трём этапам: обнаружение уязвимости, проверка возможности её эксплуатации и создание исправляющего патча.
Наибольший прирост относительно Argon среди этих оценок наблюдается в ExploitGym, где Carbon поднимается с 42,0% до 54,8%. В SEC-bench Pro заявленный результат вырос с 83,4% до 88,2%. В CWE-bench — с 68,0% до 71,0%.
Эти различия важны на практике. Обнаружение подозрительного кода само по себе не доказывает наличие эксплуатируемого дефекта, а демонстрация эксплойта не доказывает, что предложенное исправление работает. Google представляет результаты Carbon как свидетельства по каждому из этих отдельных этапов.
Есть важное условие: по словам Google, внешние оценки кибербезопасности проводились «без защитных механизмов». Поэтому анонс не доказывает, что клиенты получат те же результаты при ограничениях, которые будут сопровождать их развёртывание.
Google приводит и внутренние данные, сообщая о более чем вдвое большем показателе успеха по сравнению с Argon при генерации безопасного кода. Компания также утверждает, что команда Chrome зафиксировала более чем десятикратное преимущество в создании качественных патчей по сравнению с моделью конкурирующей лаборатории. Конкурент не назван, а в анонсе нет исходных данных, необходимых для независимой оценки этого сравнения.
Эти заявления развивают направление, которое Google подчёркивала уже с Argon. В материалах о запуске предыдущей модели обнаружение и устранение уязвимостей описывались наряду с инженерными сценариями. Более сильные заявленные результаты Carbon усиливают этот существующий фокус, но не означают, что возможности в области кибербезопасности появились лишь с этим релизом.
Повышение надёжности сопровождается ограниченным развёртыванием
Ещё одно ключевое сравнение Google с Argon касается поведения модели при выполнении работы.
Компания сообщает, что во внутреннем тестировании Carbon примерно вдвое сокращает количество необоснованных утверждений. По её словам, число серьёзных предупреждений о нарушении согласованности во внутренних средах программирования снизилось почти на 80%, а показатели выхода за рамки задания и недостаточной помощи сократились на 26% и 29% соответственно.
Независимое тестирование фактических знаний усложняет эту картину надёжности. Artificial Analysis присваивает Carbon самый высокий результат в AA-Omniscience — 54, что на шесть пунктов выше Opus 5.5 в режиме max. Carbon правильно отвечает на 58% вопросов против 48% у Argon, но заявленный уровень галлюцинаций вырастает с 4% до 11%. Для Opus 5.5 и Astra в режиме max оценщик приводит по 50%.
Методология бенчмарка определяет уровень галлюцинаций как отношение неверных ответов к общему числу неверных, частично верных и оставленных без ответа. Таким образом, 11% не означают, что выдумана 11% всех ответов. Общий индекс поощряет правильные ответы, штрафует неправильные и допускает отказ от ответа без штрафа.
В итоге Carbon лидирует по этому комбинированному показателю, уступая Argon по компоненту галлюцинаций. Этот вывод получен в иной оценке, чем внутренний показатель Google по необоснованным утверждениям; два результата не свидетельствуют о единообразном улучшении или ухудшении фактической надёжности во всех задачах.
В Terminal-Bench 4.0, по данным Google, доля успешного жульничества составила 0,0%, а попыток жульничества — 0,4%. Это важные показатели для агента, от которого ожидают выполнения реальной задачи, а не эксплуатации теста или ложных заявлений о завершении.
Google также сообщает о 0,0% успешных атак в оценке непрямых промпт-инъекций Gray Swan против 0,7% у Argon. Этот результат относится к проверенным атакам и не означает неуязвимости к вредоносным инструкциям, встречающимся в любом репозитории, документе или веб-странице.
По словам Google, Carbon использует тот же общий подход к безопасности, что и Argon, сочетая обучение, защиту от злоупотреблений, устойчивость к внедрённым инструкциям и мониторинг рассуждений модели. Компания отмечает, что дополнительная работа была направлена на поведение при сложных или требовательных заданиях.
Эти улучшения остаются измерениями, о которых сообщает сама компания. Релиз не позволяет понять, как часто внешний клиент столкнётся с теми же сбоями или воспроизведёт заявленные снижения.
Google сообщает, что участвует в добровольном процессе предварительного тестирования, организованном правительством США, одновременно собирая отзывы и совершенствуя защиту. Компания планирует расширить доступ к Carbon через Fairwind, прежде чем открыть его более широкой аудитории.
В результате у компаний остаётся практическое различие между двумя флагманами. У Argon есть задокументированный публичный доступ, описанное поведение API и датированный переход на новые цены. У Carbon — более сильные заявленные результаты в сравнении Google, те же рекламируемые тарифы за токены и более узкая начальная аудитория. Дата его широкого релиза, подробные спецификации API и срок окончания промоцен пока не объявлены.