


Метод Attention Matching от MIT сжимает память ИИ в 50 раз


Корпоративные приложения искусственного интеллекта, работающие с большими документами или долгосрочными задачами, сталкиваются с серьезным узким местом в памяти. По мере увеличения контекста растет и кэш KV (KV cache) — область, где хранится рабочая память модели.
Новый метод, разработанный исследователями из Массачусетского технологического института (MIT), решает эту проблему с помощью быстрого метода сжатия кэша KV. Эта техника, получившая название Attention Matching (сопоставление внимания), позволяет сжимать контекст до 50 раз с минимальной потерей качества.
Хотя это не единственная доступная техника компактизации памяти, Attention Matching выделяется скоростью выполнения и впечатляющими возможностями сохранения информации.
Узкое место памяти кэша KV
Большие языковые модели генерируют ответы последовательно, по одному токену за раз. Чтобы не пересчитывать всю историю беседы с нуля для каждого предсказанного слова, модель сохраняет математическое представление каждого предыдущего обработанного токена (также известное как пары ключей и значений). Эта критически важная рабочая память называется кэшем KV.
Кэш KV масштабируется в зависимости от длины диалога, поскольку модель вынуждена сохранять эти ключи и значения для всех предыдущих токенов в рамках конкретного взаимодействия. Это потребляет дорогостоящие аппаратные ресурсы. «На практике память кэша KV является самым большим узким местом при обслуживании моделей в условиях сверхдлинного контекста», — рассказал VentureBeat соавтор научной работы Адам Цвайгер (Adam Zweiger). — Она ограничивает параллелизм, вынуждает использовать меньшие батчи и/или требует более агрессивной выгрузки».
В современных корпоративных сценариях использования, таких как анализ массивных юридических контрактов, ведение многосессионных диалогов с клиентами или запуск автономных агентов программирования, кэш KV может раздуваться до многих гигабайт памяти для одного запроса пользователя.
Чтобы решить эту масштабную проблему, индустрия ИИ испробовала несколько стратегий, однако эти методы оказываются неэффективными при развертывании в корпоративных средах, где требуется экстремальное сжатие. Класс технических решений включает оптимизацию кэша KV посредством удаления токенов, которые модель считает менее важными, либо объединения похожих токенов в единое представление. Эти методы работают при умеренном сжатии, но «быстро деградируют при высоких коэффициентах уменьшения», по словам авторов.
Реальные приложения часто полагаются на более простые методы, причем наиболее распространенный подход заключается в простом отбрасывании более старого контекста при достижении лимита памяти. Но из-за этого подхода модель теряет более старую информацию по мере роста контекста. Другая альтернатива — суммирование контекста, при котором система делает паузу, пишет короткую текстовую выжимку более старого контекста и заменяет исходную память этой выжимкой. Хотя это стандарт индустрии, суммаризация приводит к большим потерям и сильно ухудшает производительность на последующих этапах, так как из контекста может быть удалена важная информация.
Недавние исследования доказали, что технически возможно сильно сжать эту память с помощью метода, называемого Cartridges. Однако этот подход требует обучения скрытых моделей кэша KV посредством медленной сквозной математической оптимизации. Такое обучение на основе градиентов может занимать несколько часов на дорогостоящих графических процессорах (GPU) просто для сжатия одного контекста, что делает его совершенно нежизнеспособным для корпоративных приложений реального времени.
Как Attention Matching сжимает данные без лишних затрат
Attention Matching обеспечивает высокие коэффициенты компактизации и качество, будучи при этом на порядки быстрее оптимизации на основе градиентов. Метод обходит медленный процесс обучения с помощью остроумных математических приемов.
Исследователи поняли, что для идеального моделирования взаимодействия ИИ со своей памятью необходимо сохранить два математических свойства при сжатии исходных векторов ключей и значений в меньший объем. Первое — это «выход внимания» (attention output), то есть фактическая информация, которую ИИ извлекает при обращении к своей памяти. Второе — «масса внимания» (attention mass), которая выступает в роли математического веса токена относительно всего остального в рабочей памяти модели. Если сжатая память способна соответствовать этим двум свойствам, она будет вести себя точно так же, как массивная исходная память, даже при добавлении в дальнейшем новых непредсказуемых пользовательских промптов.
«Attention Matching в некотором роде является «правильным» целевым показателем для компактизации скрытого контекста, поскольку он напрямую направлен на сохранение поведения каждой головы внимания после компактизации», — отметил Цвайгер. Хотя отсесечение токенов и связанные с ним эвристики могут работать, явное сопоставление поведения внимания просто приводит к лучшим результатам.
Attention Matching
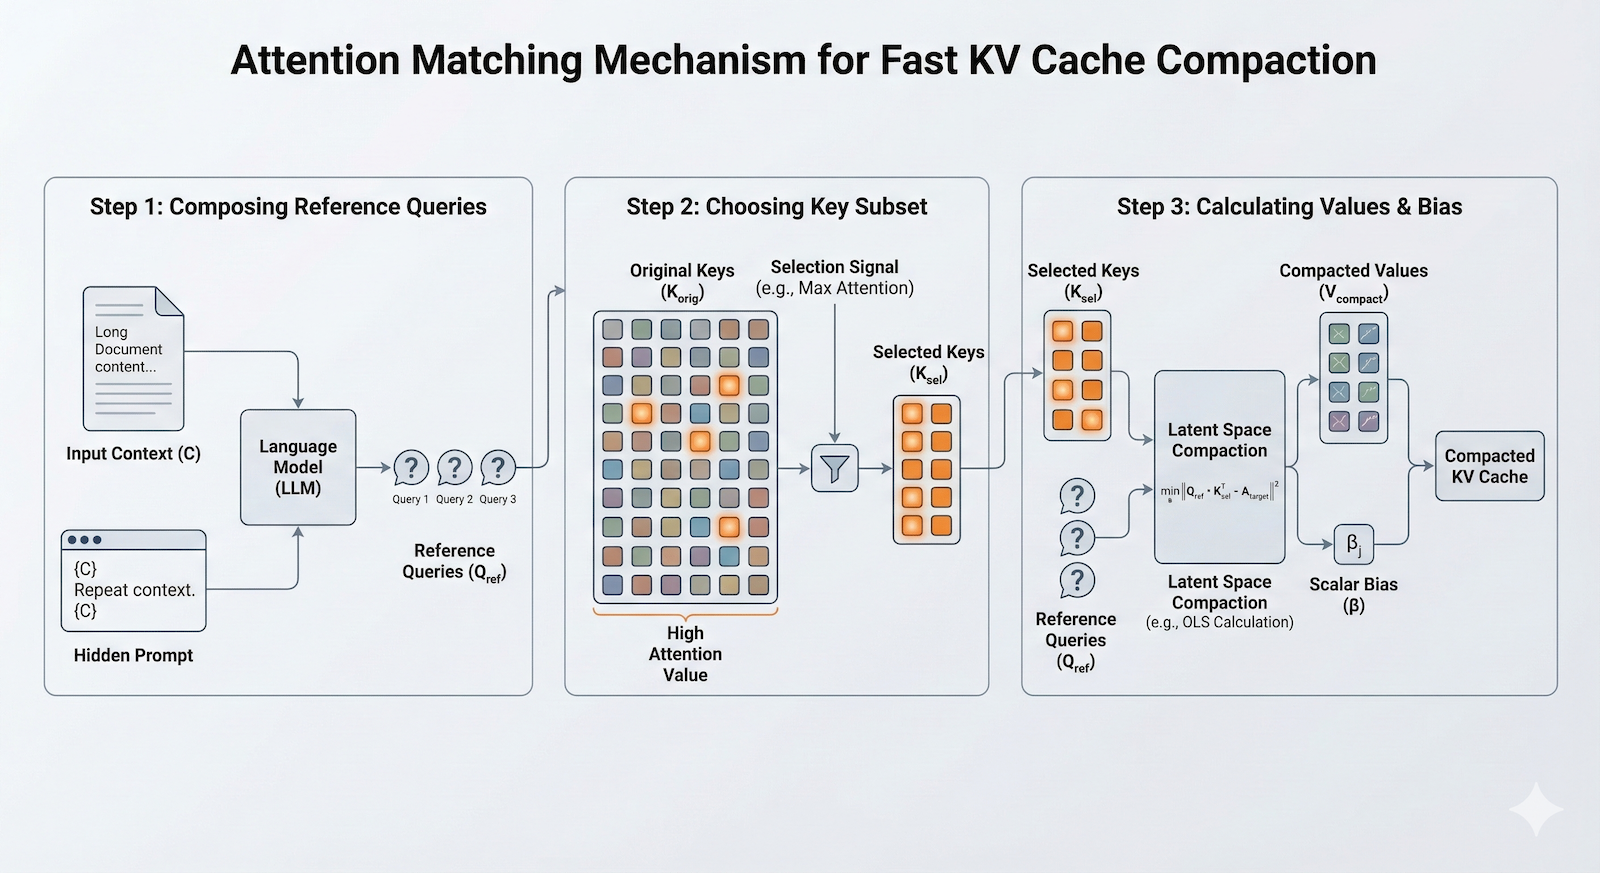
Перед сжатием памяти система генерирует небольшой набор «эталонных запросов» (reference queries), которые служат прокси-сервером для типов внутренних поисковых запросов, которые модель, вероятнее всего, выполнит при рассуждении о конкретном контексте. Если сжатая память сможет точно ответить на эти эталонные запросы, она с очень высокой долей вероятности успешно ответит и на реальные вопросы пользователя позже. Авторы предлагают различные методы генерации таких эталонных запросов, включая добавление скрытого промпта к документу с указанием модели повторить предыдущий контекст (так называемый метод «repeat-prefill»). Они также предлагают подход «самообучения», при котором модель получает промпт выполнить несколько быстрых синтетических задач над документом, таких как агрегирование всех ключевых фактов или структурирование дат и чисел в формат JSON.
Имея эти запросы, система выбирает набор ключей для сохранения в уплотненном кэше KV на основе таких сигналов, как наибольшее значение внимания. Затем она использует ключи и эталонные запросы для расчета соответствующих значений наряду со скалярным членом смещения. Это смещение гарантирует сохранение актуальной информации, позволяя каждому сохраненному ключу представлять массу множества удаленных ключей.
Эта формулировка позволяет подогнать значения с помощью простых алгебраических методов, таких как обычный метод наименьших квадратов и неотрицательный метод наименьших квадратов, полностью избегая ресурсоемкой градиентной оптимизации. Именно это делает Attention Matching сверхбыстрым по сравнению с методами компактизации, требующими тяжелой оптимизации. Исследователи также применяют сегментированную компактизацию, обрабатывая непрерывные фрагменты входных данных независимо и объединяя их, чтобы еще больше улучшить производительность при работе с длинным контекстом.
Attention Matching в действии
Чтобы понять, как этот метод работает в реальном мире, исследователи провели серию стресс-тестов с использованием популярных открытых моделей, таких как Llama 3.1 и Qwen-3, на двух различных типах корпоративных наборов данных. Первым был QuALITY — стандартный бенчмарк проверки понимания прочитанного, использующий документы объемом от 5 000 до 8 000 слов. Вторым, представляющим реальную корпоративную задачу, стал LongHealth — высокоплотный набор данных объемом 60 000 токенов, содержащий сложные медицинские карты нескольких пациентов.
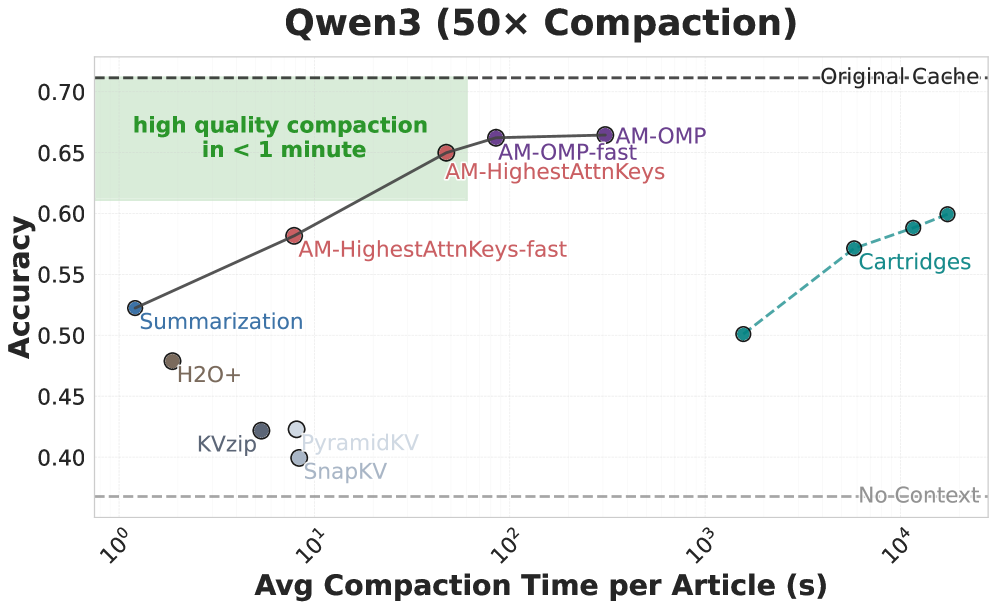
Ключевым открытием стала способность Attention Matching сжимать кэш KV модели в 50 раз без снижения точности, затрачивая на обработку документов всего несколько секунд. Для достижения такого же уровня качества ранее Cartridges требовали часов интенсивных вычислений на GPU для каждого контекста.
Attention Matching с Qwen-3 (источник: arXiv)
При работе с плотными медицинскими записями стандартные отраслевые обходные пути полностью терпели крах. Исследователи отметили, что при попытке использовать стандартное суммирование текста для этих медицинских карт точность модели падала настолько сильно, что соответствовала базовому уровню «без контекста», то есть ИИ работал так, будто вообще не читал документ.
Attention Matching кардинально превосходит суммаризацию, однако корпоративным архитекторам придется снижать коэффициент сжатия для задач с высокой плотностью информации по сравнению с более простыми тестами на понимание прочитанного. Как поясняет Цвайгер: «Главный практический компромисс заключается в том, что если вы пытаетесь сохранить практически все в контексте для задач с высокой плотностью информации, вам, как правило, требуется более мягкий коэффициент компактизации для сохранения высокой точности».
Исследователи также изучили, что происходит в случаях, когда абсолютная точность не нужна, но требуется экстремальная экономия памяти. Они запустили Attention Matching поверх стандартного текстового резюме. Такой комбинированный подход позволил достичь 200-кратного сжатия. Он успешно соответствовал точности одной лишь стандартной суммаризации, но с очень малым объемом занимаемой памяти.
Одним из интересных экспериментов для корпоративных рабочих процессов стало тестирование оперативной компактизации (online compaction), хотя авторы отмечают, что это концептуальное доказательство и метод еще не прошел строгие испытания в производственных средах. Исследователи протестировали модель на продвинутом математическом тесте AIME. Они заставили ИИ решить проблему со строго ограниченным лимитом физической памяти. Каждый раз, когда память модели заполнена до отказа, система делала паузу, мгновенно сжимала свою рабочую память на 50 процентов с помощью Attention Matching и позволяла ей продолжать размышления. Даже после того, как модель упиралась в предел памяти и ее кэш KV сжимался до шести раз подряд прямо в процессе мышления, она успешно решала математические задачи. Ее производительность не уступала модели, которой выделили огромный неограниченный объем памяти.
Существуют и оговорки, которые следует учитывать. При 50-кратном коэффициенте сжатия Attention Matching является явным лидером по балансу скорости и качества. Однако если предприятие попытается довести сжатие до экстремальных пределов в 100 раз на очень сложных данных, более медленный метод Cartridges на основе градиентов фактически окажется эффективнее.
Исследователи опубликовали код для Attention Matching. Тем не менее, они отмечают, что на данный момент это не простое программное обновление по принципу «подключи и работай». «Я думаю, что скрытую компактизацию лучше рассматривать как технику на уровне модели», — отмечает Цвайгер. — Хотя ее можно применить поверх любой существующей модели, она требует доступа к весам модели». Это означает, что компании, полностью полагающиеся на закрытые API, не смогут внедрить это самостоятельно; им нужны модели с открытыми весами.
Авторы отмечают, что интеграция этой компактизации KV в скрытом пространстве в существующие, высокооптимизированные коммерческие движки инференса все еще требует значительных усилий. Современная инфраструктура ИИ использует сложные приемы, такие как кэширование префиксов и упаковка памяти переменной длины, чтобы серверы работали эффективно, и бесшовное внедрение этой новой техники компактизации в существующие системы потребует целенаправленной инженерной работы. Тем не менее, существуют и возможности для немедленного корпоративного применения. «Мы считаем, что компактизация после приема данных является перспективным вариантом использования, когда большие вызовы инструментов или длинные документы сжимаются сразу после обработки», — сказал Цвайгер.
В конечном счете, переход к механической компактизации в скрытом пространстве согласуется с будущими линейками продуктов основных игроков на рынке ИИ, утверждает Цвайгер. «Мы наблюдаем, как компактизация превращается из того, что предприятия внедряют самостоятельно, в то, что поставляют сами провайдеры моделей, — сказал Цвайгер. — Это еще более справедливо для скрытой компактизации, где необходим доступ к весам модели».




