


Nvidia снижает расходы на память для языковых моделей в 8 раз
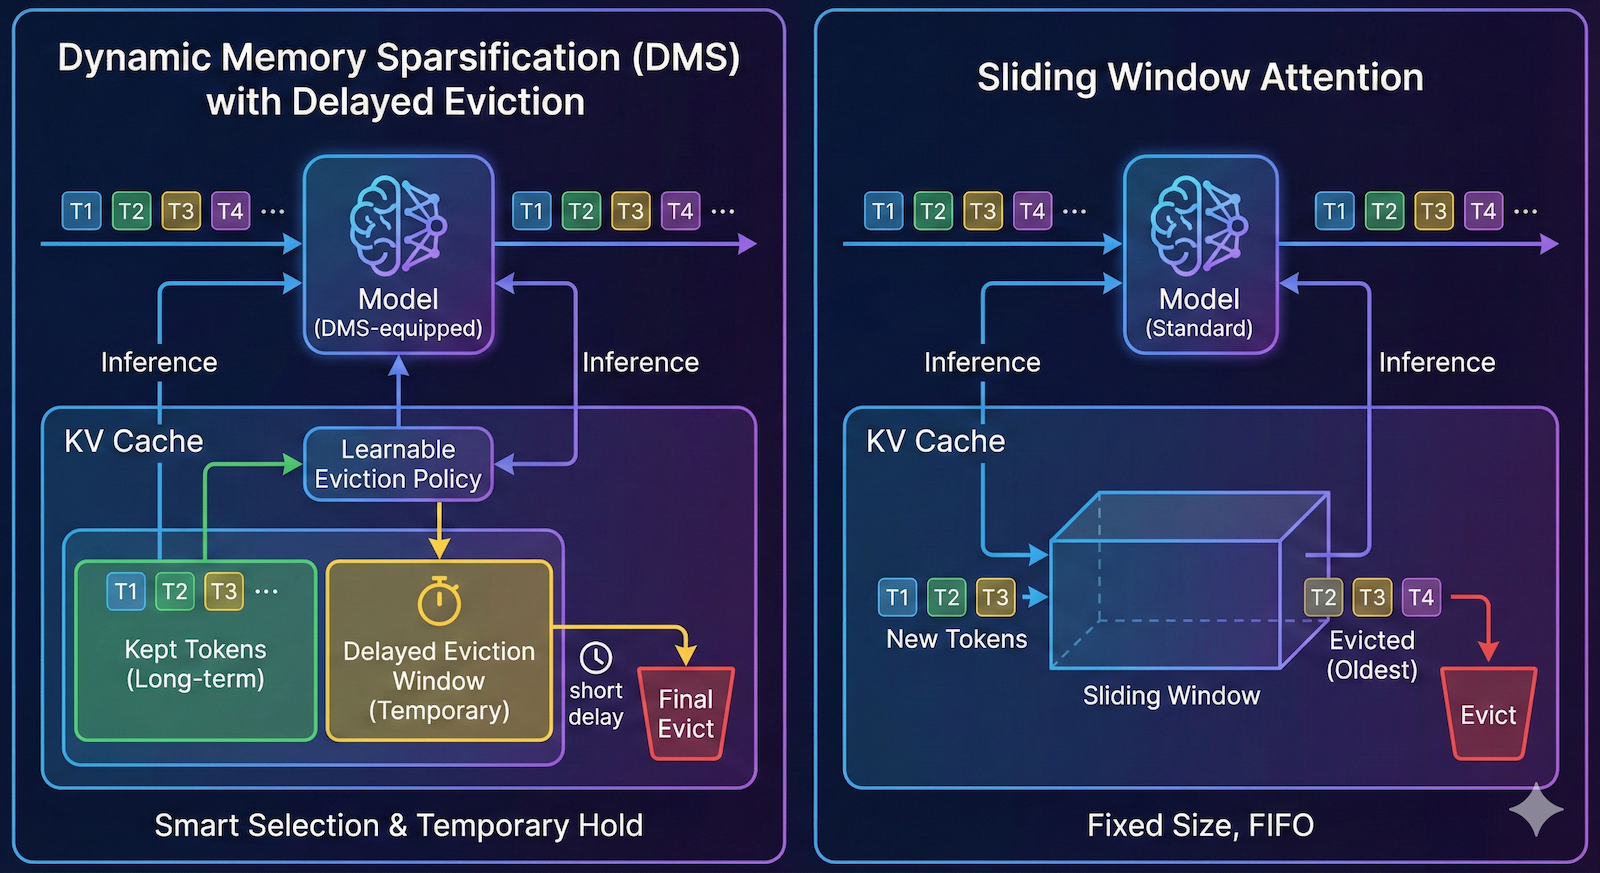


Исследователи из Nvidia разработали метод, способный сократить затраты памяти на рассуждения больших языковых моделей (LLM) до восьми раз. Их методика, получившая название динамического разрежения памяти (dynamic memory sparsification, DMS), сжимает кэш ключей-значений (KV cache) — временную память, которую LLM генерируют и хранят по мере обработки промптов и решения задач и документов.
Хотя исследователи и ранее предлагали различные методы сжатия этого кэша, большинство из них с трудом справляются с задачей без ущерба для интеллектуальных возможностей модели. Подход Nvidia позволяет отбросить значительную часть кэша, сохранив (а в некоторых случаях и улучшив) способность модели к рассуждениям.
Эксперименты показывают, что DMS позволяет LLM «мыслить» дольше и исследовать больше решений без обычных потерь в скорости или затратах памяти.
Узкое место рассуждений
LLM повышают свою производительность при выполнении сложных задач за счет генерации токенов в рамках концепции «цепочки мыслей» (chain-of-thought), фактически прописывая свои шаги рассуждения перед тем, как прийти к окончательному ответу. Методы масштабирования на этапе инференса используют это, предоставляя модели больший запас токенов для размышлений или позволяя параллельно изучать несколько возможных путей рассуждения.
Однако улучшение возможностей рассуждения сопряжено со значительными вычислительными затратами. По мере того как модель генерирует все больше токенов, она накапливает KV-кэш.
Для реальных приложений KV-кэш является главным узким местом. По мере роста цепочки рассуждений кэш увеличивается линейно, потребляя колоссальные объемы памяти на графических процессорах. Это заставляет оборудование тратить больше времени на чтение данных из памяти, чем на сами вычисления, что замедляет генерацию и увеличивает задержки. Это также ограничивает количество пользователей, которых система может обслуживать одновременно, поскольку исчерпание видеопамяти (VRAM) приводит к сбою системы или резкому замедлению ее работы.
Исследователи из Nvidia рассматривают это не просто как техническое препятствие, а как фундаментальную экономическую проблему для бизнеса.
«Вопрос не только в количестве оборудования; вопрос в том, обрабатывает ли ваша инфраструктура 100 потоков рассуждений или 800 потоков за те же деньги», — рассказал VentureBeat Петр Наврот (Potr Nawrot), старший инженер по глубокому обучению в Nvidia.
Предыдущие попытки решить эту проблему были сосредоточены на эвристических подходах. В этих методах используются жесткие правила, такие как «скользящее окно», при котором кэшируются только самые свежие токены, а остальные удаляются. Хотя это снижает использование памяти, оно часто заставляет модель отбрасывать критически важную информацию, необходимую для решения задачи, что ухудшает точность результатов.
«Стандартные методы вытеснения пытаются выбрать старые и неиспользуемые токены для удаления с помощью эвристики», — говорят исследователи. — Они упрощают задачу в надежде, что при приближенном моделировании внутренней механики модели ответ останется верным».
Другие решения используют пейджинг (страничную организацию памяти) для выгрузки неиспользуемых частей KV-кэша в более медленную память, но постоянный обмен данными создает дополнительные задержки, из-за чего приложения реального времени начинают работать медленно.
Динамическое разрежение памяти
DMS использует иной подход, «модернизируя» существующие LLM для интеллектуального управления собственной памятью. Вместо применения фиксированного правила удаления, DMS обучает модель определять, какие токены необходимы для будущих рассуждений, а какие можно отбросить.
«Она не просто угадывает важность; она изучает политику, которая явно сохраняет итоговое распределение выходных данных модели», — отметил Наврот.
Этот процесс превращает стандартную предобученную LLM, такую как Llama 3 или Qwen 3, в самосжимающуюся модель. Что особенно важно, это не требует обучения модели с нуля, что было бы непомерно дорого. Вместо этого DMS перепрофилирует существующие нейроны в слоях внимания модели для выдачи сигнала «сохранить» или «вытеснить» для каждого токена.
Для команд, обеспокоенных сложностью модернизации, исследователи отметили, что процесс спроектирован так, чтобы быть легковесным. «Для повышения эффективности этого процесса веса модели можно заморозить, что делает его похожим на метод низкоранговой адаптации (LoRA)», — пояснил Наврот. Это означает, что стандартную корпоративную модель вроде Qwen3-8B «можно оснастить DMS в течение нескольких часов на одном ускорителе DGX H100».
Одной из важных частей DMS является механизм под названием «отложенное вытеснение» (delayed eviction). При стандартном разрежении, если токен признается неважным, он немедленно удаляется. Это рискованно, поскольку модели может потребоваться доля секунды, чтобы интегрировать контекст этого токена в свое текущее состояние.
DMS смягчает этот эффект, помечая токен для вытеснения, но оставляя его доступным в течение короткого промежутка времени (например, несколько сотен шагов). Такая задержка позволяет модели «извлечь» всю оставшуюся необходимую информацию из токена и объединить ее в текущий контекст до того, как токен будет стерт из KV-кэша.
«Механизм „отложенного вытеснения“ имеет решающее значение, поскольку не все токены делятся исключительно на „важные“ (сохранять вечно) или „бесполезные“ (удалять немедленно). Многие находятся посередине — они несут определенную информацию, но недостаточную для того, чтобы занимать целый слот в памяти, — сказал Наврот. — Именно здесь кроется избыточность. Сохраняя эти токены в локальном окне в течение короткого времени перед вытеснением, мы позволяем модели обращаться к ним и перераспределять их информацию в будущие токены».
Исследователи обнаружили, что этот процесс модернизации отличается высокой эффективностью. Они смогли оснастить предобученную LLM технологией DMS всего за 1000 шагов обучения, что составляет лишь малую долю вычислительных затрат, необходимых для первоначального обучения. Полученные модели используют стандартные ядра и могут напрямую встраиваться в существующие высокопроизводительные стеки инференса без необходимости применения специализированного оборудования или сложного переписывания программного обеспечения.
DMS в действии
Чтобы проверить метод на практике, исследователи применили DMS к нескольким моделям рассуждений, включая серию Qwen-R1 (дистиллированную из DeepSeek R1) и Llama 3.2, и протестировали их на сложных бенчмарках, таких как AIME 24 (математика), GPQA Diamond (наука) и LiveCodeBench (программирование).
Результаты показывают, что DMS эффективно сдвигает границу Парето — оптимальный баланс между стоимостью и производительностью. На математическом бенчмарке AIME 24 модель Qwen-R1 32B с поддержкой DMS показала результат на 12,0 балла выше, чем стандартная модель, при ограничении тем же бюджетом пропускной способности памяти. За счет сжатия кэша модель смогла позволить себе «мыслить» гораздо глубже и шире, чем стандартная модель при том же бюджете памяти и вычислений.
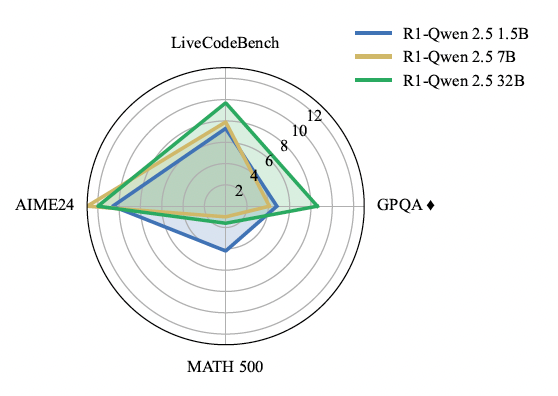
DMS повышает производительность моделей на задачах рассуждения по сравнению со стандартными LLM при равном вычислительном бюджете (источник: arXiv)
Пожалуй, самым удивительным стало то, что DMS опровергла распространенное мнение о том, что сжатие ухудшает понимание длинного контекста. В тестах «иголка в стоге сена» (needle-in-a-haystack), которые измеряют способность модели находить конкретный фрагмент информации, затерянный в большом документе, варианты с DMS фактически превзошли стандартные модели. Активно управляя своей памятью, а не пассивно накапливая шум, модель поддерживала более чистый и полезный контекст.
Для корпоративной инфраструктуры прирост эффективности напрямую выражается в увеличении пропускной способности и экономии оборудования. Поскольку кэш памяти стал значительно меньше, графический процессор тратит меньше времени на извлечение данных, сокращая время ожидания для пользователей. В тестах с моделью Qwen3-8B технология DMS обеспечила точность стандартной модели, одновременно повысив пропускную способность до 5 раз. Это означает, что один сервер может обрабатывать в пять раз больше пользовательских запросов в секунду без потери качества.
Будущее памяти
Nvidia выпустила DMS в рамках своего фреймворка Model Optimizer. Говоря о том, как компании могут начать работу с DMS, Наврот подчеркнул низкий порог входа. «„Минимально жизнеспособная инфраструктура“ — это стандартные пайплайны Hugging Face, никаких пользовательских ядер CUDA не требуется», — отметил Наврот, добавив, что код полностью совместим со стандартным механизмом FlashAttention.
Глядя в будущее, команда рассматривает DMS как часть более масштабного сдвига, при котором управление памятью становится отдельным интеллектуальным слоем стека искусственного интеллекта. Наврот также подтвердил, что DMS «полностью совместима» с новыми архитектурами, такими как многоглавое латентное внимание (Multi-Head Latent Attention, MLA), используемое в моделях DeepSeek, что говорит о возможности получения еще большей эффективности при объединении этих подходов.
По мере перехода предприятий от простых чат-ботов к сложным агентным системам, требующим расширенных рассуждений, стоимость инференса становится главной заботой. Такие методы, как DMS, открывают путь к устойчивому масштабированию этих возможностей.
«Мы лишь едва поцарапали поверхность того, что возможно, — сказал Наврот, — и мы ожидаем дальнейшего развития масштабирования на этапе инференса».




