


Память ИИ-агента на уровне 0,12% от параметров модели


ИИ-агенты забывают. Каждый раз, когда ассистент программиста теряет нить отладки или агент по анализу данных заново обрабатывает уже пройденный контекст, команда расплачивается за это задержками, затратами на токены и хрупкостью рабочих процессов. Способ, к которому прибегает большинство команд — расширение контекстного окна или добавление новых механизмов RAG — становится всё дороже и по-прежнему не гарантирует стабильной работы.
Чтобы решить эту проблему, исследователи из Mind Lab и нескольких университетов предложили delta-mem — эффективный метод, который сжимает историческую информацию модели в динамически обновляемую матрицу без изменения самой модели. Полученный модуль добавляет всего 0,12% параметров к базовой модели (по сравнению с 76,40% у одного из ведущих альтернативных вариантов), превосходя ее на бенчмарках с интенсивным использованием памяти. Delta-mem позволяет моделям непрерывно накапливать и повторно использовать исторические данные, снижая зависимость от огромных контекстных окон или сложных внешних поисковых модулей для поддержания последовательности поведения.
Проблема долгой памяти
Традиционное решение заключается в том, чтобы просто поместить всю информацию в контекстное окно модели.
Однако, как рассказал VentureBeat соавтор статьи Цзинди Лей (Jingdi Lei), современные системы рассматривают память исключительно как проблему управления контекстом. «Мы либо продолжаем расширять контекстное окно, либо извлекаем больше документов с помощью RAG, — пояснил Лей. — Эти подходы полезны и останутся важными, но они становятся всё более дорогими и ненадежными, когда агентам приходится работать с долгосрочными многоэтапными взаимодействиями, и они не совсем работают подобно человеческой памяти, напоминая скорее поиск документов».
В корпоративной среде узким местом является не просто способность модели получить доступ к истории, а то, насколько эффективно, непрерывно и с минимальной задержкой она может эту историю использовать. Стандартные механизмы внимания влекут за собой квадратичные вычислительные затраты по мере увеличения длины последовательности. Кроме того, расширение контекстного окна не гарантирует, что модель действительно сможет эффективно вспомнить информацию. Модели часто страдают от деградации контекста или «гниения контекста», оказываясь перегруженными большим количеством (и часто противоречивой) информации, даже если теоретически они поддерживают один миллион токенов.
Исследователи выступают за продвинутые механизмы памяти, которые могут компактно представлять историческую информацию и динамически поддерживать ее в ходе взаимодействий. Существующие решения сопряжены с серьезными компромиссами и в целом делятся на три парадигмы:
-
Текстовая память: хранит историю в виде текста, внедряемого в контекст — ограничена пределами окна и подвержена потере информации при сжатии.
-
Внешний канал (RAG): кодирует данные и извлекает их из внешних модулей — добавляет задержки, сложность интеграции и потенциальное несоответствие с базовой моделью.
-
Параметрическая память: кодирует память в веса модели с помощью адаптеров — статична после обучения, не может адаптироваться к новой информации во время интерактивного взаимодействия.
Внутри delta-mem
Для создания компактной и динамически обновляемой памяти delta-mem сжимает прошлые взаимодействия агента в «оперативное состояние ассоциативной памяти» (OSAM). Это состояние поддерживается в виде матрицы фиксированного размера, которая сохраняет историческую информацию, в то время как лежащая в основе языковая модель остается замороженной.
Для корпоративных рабочих процессов это напрямую означает устранение операционных узких мест. Лей отметил, что постоянный помощник по программированию, например, «может нуждаться в запоминании конвенций проекта, недавних шагов отладки, пользовательских предпочтений или промежуточных решений в ходе рабочего процесса». Аналогичным образом, агент анализа данных может «поддерживать состояние задачи, предположения и предыдущие наблюдения при итерации по нескольким вызовам инструментов».
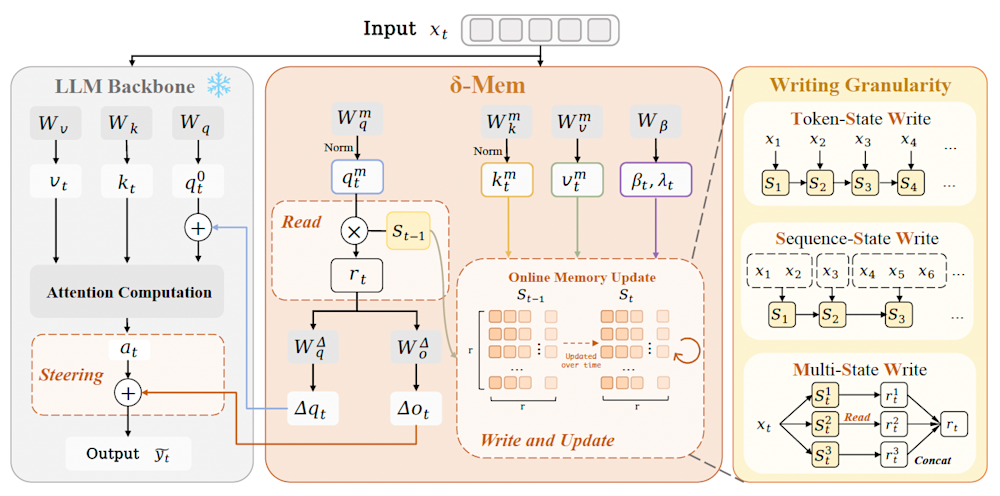
Архитектура Delta-mem (источник: arXiv)
Вместо многократного извлечения и повторной вставки всей релевантной истории для этих задач, матрица delta-mem обеспечивает низкие накладные расходы при передаче полезных состояний взаимодействия внутри прямых вычислений модели.
Во время генерации система не извлекает сырые текстовые сегменты для добавления в промпт. Вместо этого текущее скрытое состояние базовой LLM проецируется в матрицу для извлечения старой памяти. Эта операция извлекает из delta-mem ассоциативные сигналы памяти, релевантные контексту. Затем эти сигналы преобразуются в числовые поправки, которые применяются к вычислениям модели. Это направляет рассуждения модели во время инференса без изменения ее внутренних параметров.
После каждого взаимодействия delta-mem обновляет оперативное состояние с помощью «обучения по дельта-правилу». Когда поступает новая информация, предыдущее состояние делает прогноз относительно получаемых значений внимания. Затем оно сравнивает этот прогноз с фактическим значением и корректирует матрицу памяти на основе расхождения.
Этот механизм обновления опирается на «дельта-правило с управлением шлюзами». По сути, модуль памяти имеет различные регуляторы, которые контролируют, какая часть предыдущей памяти сохраняется и какая часть новой памяти применяется. Такое исправление ошибок с контролируемым забыванием позволяет матрице эволюционировать со временем, удерживая стабильные исторические ассоциации и не сбиваясь из-за кратковременного шума.
Исследователи изучили три стратегии определения того, когда и как обновляется матрица:
-
Запись на уровне токенов фиксирует мелкозернистые изменения, но уязвима к кратковременному шуму.
-
Запись на уровне последовательности усредняет токены в сегменте сообщения, сглаживая обновления ценой некоторой локализованной детализации.
-
Многоуровневая запись декомпозирует память на подсостояния для различных типов информации, таких как факты или прогресс выполнения задач.
Delta-mem в действии
Исследователи оценили работу delta-mem на трех базовых LLM: Qwen3-8B, Qwen3-4B-Instruct и SmolLM3-3B. Они настроили фреймворк с компактной матрицей 8×8. Система тестировалась на бенчмарках общих возможностей, включая HotpotQA, GPQA-Diamond и IFEval. Она также оценивалась на задачах с интенсивным использованием памяти, таких как LoCoMo (проверка долгосрочной разговорной памяти) и Memory Agent Bench (оценка удержания, извлечения, избирательного забывания и обучения во время инференса в ходе расширенных взаимодействий).
Фреймворк сравнивался с репрезентативными моделями из трех существующих парадигм памяти: базовыми моделями текстовой памяти (например, BM25 RAG, LLMLingua-2 и MemoryBank), параметрическими системами (Context2LoRA и MemGen) и подходом внешнего канала MLP Memory.
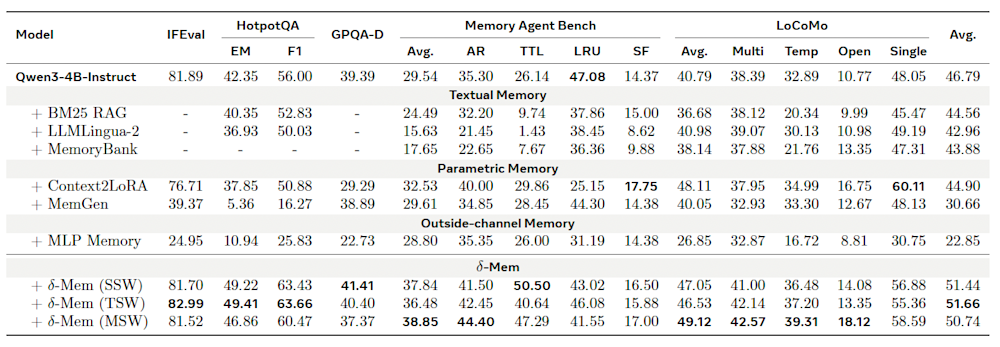
Delta-mem повышает производительность на ключевых отраслевых бенчмарках (источник: arXiv)
По всем направлениям delta-mem превзошла базовые модели, согласно данным исследователей. На базе Qwen3-4B-Instruct вариант с записью на уровне токенов достиг среднего балла 51,66%, легко превзойдя замороженную стандартную базовую модель с 46,79% и сильнейший базовый вариант Context2LoRA с 44,90%. На ресурсоемком бенчмарке Memory Agent Bench средний балл подскочил с 29,54% до 38,85%. Производительность в специфической подзадаче обучения во время инференса выросла почти вдвое — с 26,14 до 50,50.
Тем не менее, самыми убедительными выводами являются показатели операционной эффективности системы. Исследователи протестировали фреймворк в условиях полного отсутствия контекста, когда исторический текст был полностью удален. Даже без явного повторного воспроизведения текста delta-mem успешно восстанавливала релевантные контексту свидетельства в многошаговых задачах. Исследователи утверждают, что модель помнит прошлые взаимодействия без необходимости обрабатывать огромные объемы токенов промпта.
Фреймворк также добавляет всего 4,87 миллиона обучаемых параметров, что составляет лишь 0,12% от базовой модели Qwen3-4B-Instruct. Для сравнения, базовый вариант MLP Memory требовал 3 миллиардов параметров, масштабируясь до 76,40% от размера базовой модели при худших результатах. Когда длина промптов в тестах на инференс увеличивалась до 32 000 токенов, фреймворк сохранял практически тот же объем памяти GPU, что и стандартная, немодифицированная модель. Он позволяет избежать сильного раздувания памяти, от которого страдают другие продвинутые системы памяти, такие как MemGen и MLP Memory.
Различные стратегии обновления оказались полезными в зависимости от емкости базовой модели. Стратегия записи на уровне последовательности оказалась наиболее эффективной для более мощных базовых моделей, таких как Qwen3-8B. Эти более способные модели используют запись на уровне сегментов для сглаживания обновлений и снижения шума на уровне токенов. И наоборот, стратегия многоуровневой записи обеспечила огромный прирост производительности для более мелких базовых моделей, таких как SmolLM3-3B. Для этих моделей с меньшей емкостью разделение памяти на несколько состояний оказалось критически важным для минимизации взаимного влияния информации.
Внедрение delta-mem в корпоративный стек
Исследователи опубликовали код для delta-mem на GitHub и веса для обученных адаптеров на Hugging Face. Для инженерных команд ИИ, стремящихся интегрировать этот фреймворк в свой существующий стек инференса, процесс требует минимальных вычислительных ресурсов.
«На практике инженерная команда начинает с существующей базовой модели, настроенной на следование инструкциям, присоединяет модули адаптера Delta-Mem к выбранным слоям внимания, обучает только параметры адаптера на релевантных для предметной области многошаговых или длинноконтекстных данных… а затем запускает инференс с состоянием памяти, обновляемым онлайн во время взаимодействия», — сказал Лей. Что особенно важно, командам не нужен огромный корпус для предварительного обучения. Данные для обучения должны лишь отражать целевое поведение памяти, такое как многошаговые диалоги, трассировки агентов или доменные рабочие процессы, где более ранняя информация должна влиять на последующие решения.
Хотя сжатие истории взаимодействий в математическую матрицу фиксированного размера обеспечивает колоссальную эффективность, это сопряжено с определенными компромиссами. Delta-mem не является безубыточной заменой явных текстовых логов или поиска документов. Поскольку разные фрагменты информации конкурируют в рамках одного и того же ограниченного состояния, существует риск смешивания памяти.
«Delta-Mem полезна, когда системе требуется быстрое, оперативное, непрерывно обновляемое состояние поведения, — сказал Лей. — RAG лучше подходит, когда системе требуется точное фактическое извлечение, цитирование, соответствие требованиям, аудируемость или доступ к крупной внешней базе знаний». Запоминание рабочего стиля пользователя или траектории многошаговых рассуждений отлично подходит для delta-mem, в то время как поиск юридического договора или медицинского руководства должен оставаться в векторной базе данных.
Это означает, что наиболее реалистичной корпоративной архитектурой в будущем станет гибридный подход. Delta-mem выступает в роли легкой внутренней рабочей памяти, снижая необходимость постоянно извлекать или воспроизводить всё подряд, в то время как RAG служит явным слоем памяти высокой емкости.
«Глядя в будущее, я не думаю, что векторные базы данных устареют, — отметил Лей. — Вместо этого я ожидаю, что корпоративные стеки ИИ станут более многослойными. Мы, вероятнее всего, увидим краткосрочную рабочую память внутри модели, долгосрочную явную память в поисковых системах, а также слои политик или аудита, которые решают, что должно храниться, извлекаться, забываться или показываться пользователю».




