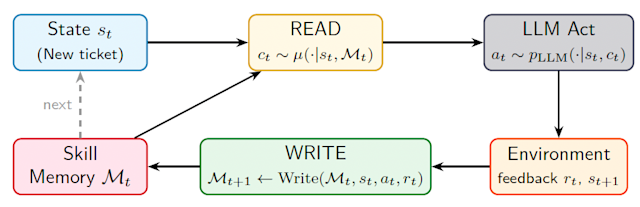
Одной из главных проблем при развертывании автономных агентов является создание систем, способных адаптироваться к изменениям в окружающей среде без необходимости дообучения базовых больших языковых моделей (LLM). Memento-Skills, новый фреймворк, разработанный…
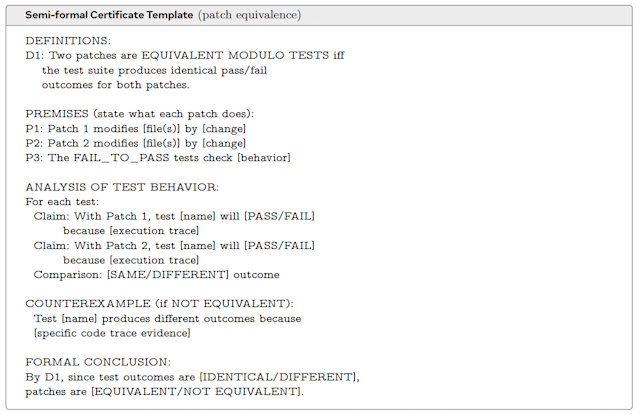
Развертывание ИИ-агентов для задач репозиторного масштаба, таких как обнаружение багов, верификация патчей и анализ кода, требует преодоления серьезных технических препятствий. Одна из главных проблем — необходимость настраивать динамические среды изоляции…
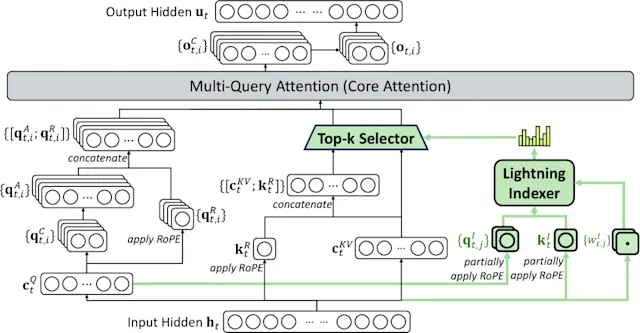
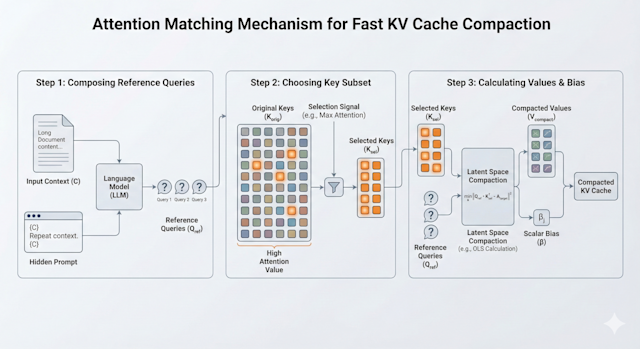
Обраработка 200 000 токенов с помощью большой языковой модели стоит дорого и происходит медленно: чем длиннее контекст, тем быстрее растут затраты. Исследователи из Университета Цинхуа и компании Z.ai создали метод…
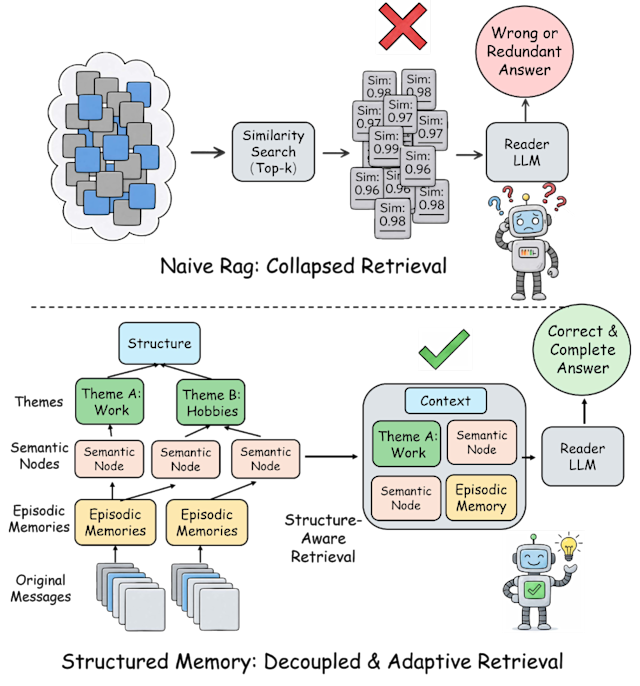
Стандартные пайплайны RAG дают сбой, когда компании пытаются использовать их для долгосрочного развертывания LLM-агентов, работающих в рамках множества сессий. Это критическое ограничение по мере роста спроса на постоянных ИИ-ассистентов. xMemory,…
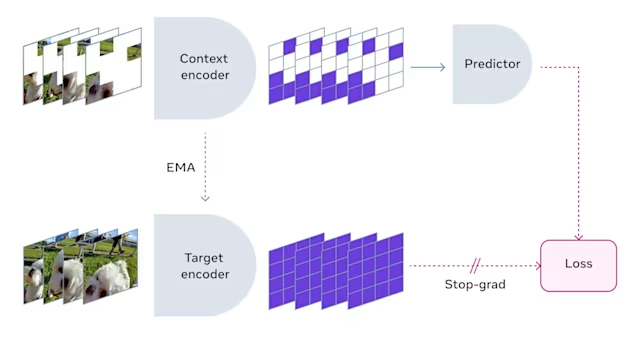
Большие языковые модели сталкиваются с ограничениями в областях, требующих понимания физического мира — от робототехники и автономного вождения до производства. Это ограничение подталкивает инвесторов к моделям мира (world models): компания…
Исследователи Nvidia представили новую технику, которая кардинально — вплоть до 20 раз — сокращает объем памяти, необходимый большим языковым моделям для отслеживания истории диалогов, причем без внесения изменений в саму…
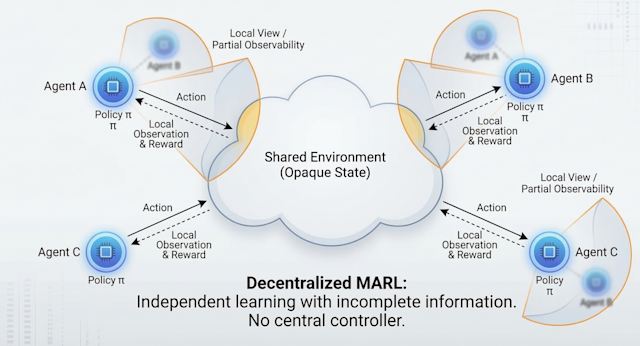
Обучение стандартных ИИ-моделей на разнообразном пуле противников — вместо создания сложных жестко заданных правил координации — позволяет создавать кооперативные многоагентные системы, которые адаптируются друг к другу на лету. К такому…
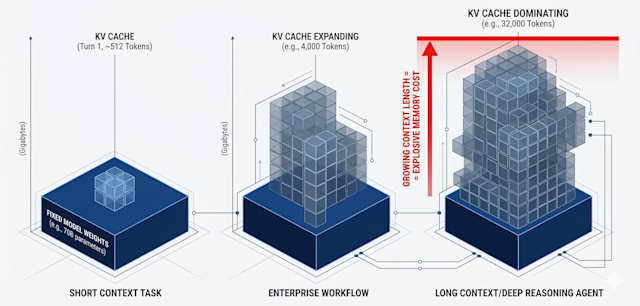
Корпоративные приложения искусственного интеллекта, работающие с большими документами или долгосрочными задачами, сталкиваются с серьезным узким местом в памяти. По мере увеличения контекста растет и кэш KV (KV cache) — область,…
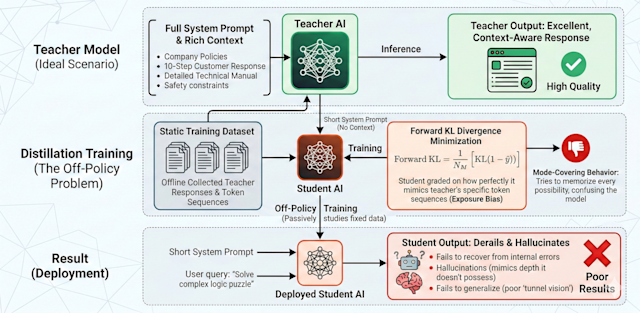
При создании приложений на базе больших языковых моделей (LLM) компаниям часто приходится писать очень длинные системные промпты, чтобы настроить поведение модели под свои задачи. Эти промпты содержат корпоративные знания, предпочтения…
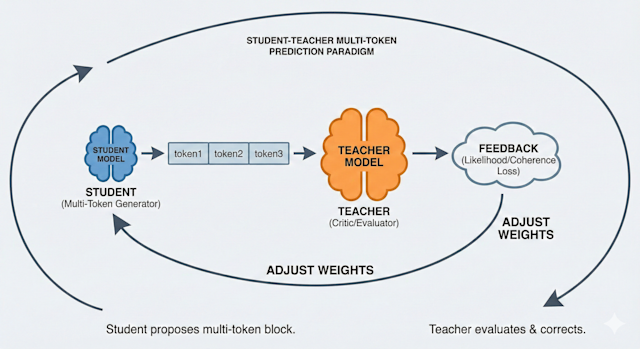
Поскольку агентские рабочие процессы на основе ИИ многократно увеличивают затраты и задержки при длинных цепочках рассуждений, команда из Мэрилендского университета, Ливерморской национальной лаборатории имени Лоуренса, Колумбийского университета и TogetherAI нашла…
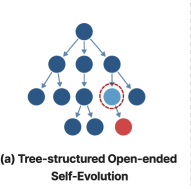
Агенты, созданные на базе современных моделей, часто дают сбой при малейших изменениях — появлении новой библиотеки или модификации рабочего процесса — и требуют вмешательства человека-инженера. Это одна из самых устойчивых…
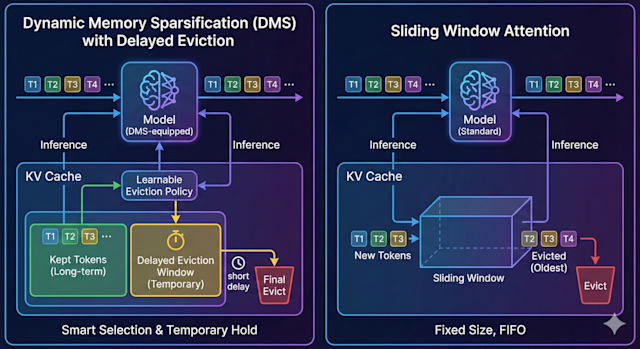
Исследователи из Nvidia разработали метод, способный сократить затраты памяти на рассуждения больших языковых моделей (LLM) до восьми раз. Их методика, получившая название динамического разрежения памяти (dynamic memory sparsification, DMS), сжимает…
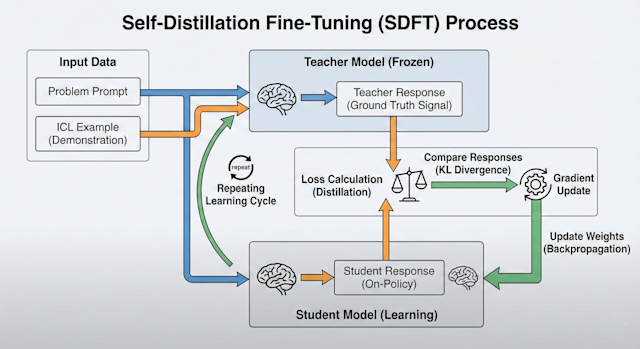
Когда предприятия дорабатывают большие языковые модели (LLM) для новых задач, они рискуют разрушить все то, что модели уже знают. Это заставляет компании поддерживать отдельные модели для каждого конкретного навыка. Исследователи…
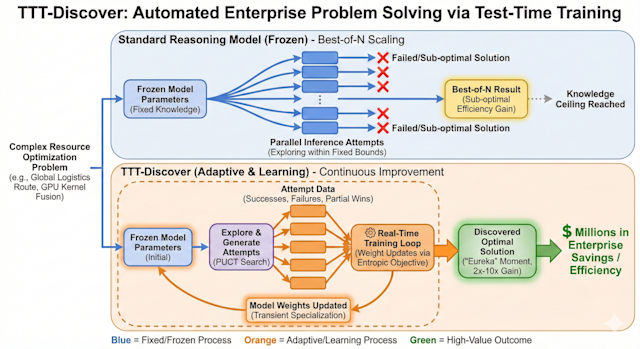
Исследователи из Стэнфорда, Nvidia и Together AI разработали новый метод, способный находить решения для сложнейших задач. Например, им удалось оптимизировать критически важное ядро GPU так, что оно стало работать в…
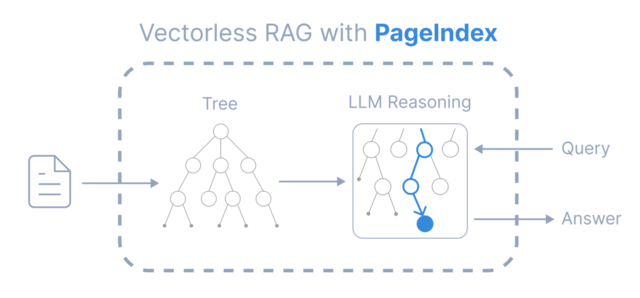
Новый фреймворк с открытым исходным кодом под названием PageIndex решает одну из давних проблем генерации с дополненной выборкой (RAG) — обработку очень длинных документов. Классический рабочий процесс RAG (разбиение документов…