


Nvidia сокращает потребности LLM в памяти в 20 раз
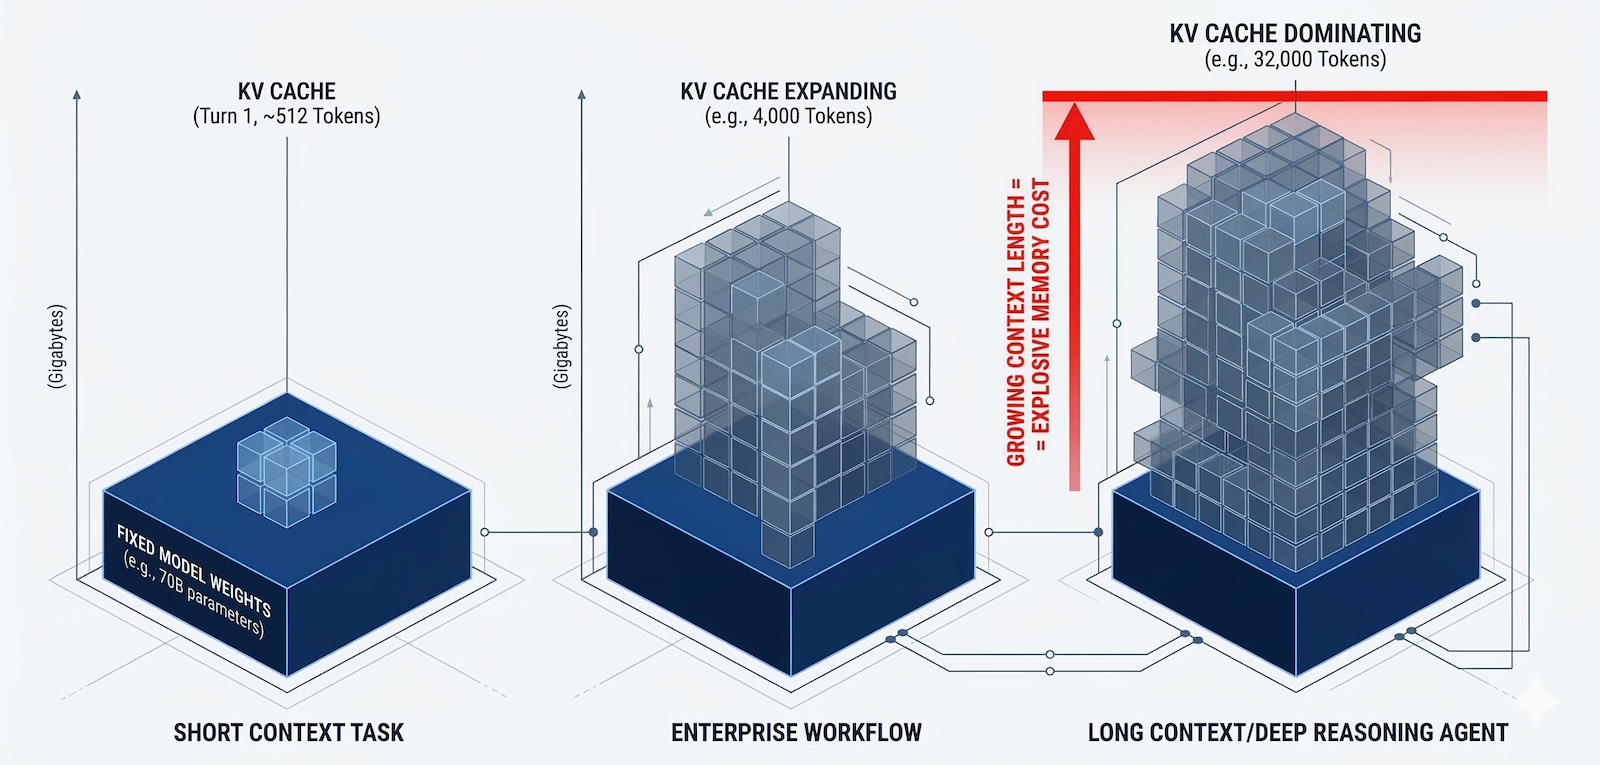


Исследователи Nvidia представили новую технику, которая кардинально — вплоть до 20 раз — сокращает объем памяти, необходимый большим языковым моделям для отслеживания истории диалогов, причем без внесения изменений в саму модель. Этот метод, названный преобразованным кодированием кэша ключей-значений (KVTC), заимствует идеи из форматов сжатия мультимедиа (например, JPEG) для уменьшения размера KV-кэша (key-value cache) в многоуровневых ИИ-системах. Это снижает требования к видеопамяти (GPU) и ускоряет генерацию первого токена (time-to-first-token) до 8 раз.
Для корпоративных ИИ-приложений, опирающихся на агенты и длинный контекст, это означает снижение затрат на память GPU, более эффективное повторное использование промптов и уменьшение задержки до 8 раз за счет устранения необходимости повторного вычисления отброшенных значений KV-кэша.
Обслуживание больших языковых моделей в промышленных масштабах требует управления огромными объемами данных, особенно в случае многошаговых диалогов и длительных сеансов программирования. Каждый раз, когда пользователь дополняет промпт, система опирается на сохраненную память, чтобы избежать повторного вычисления всей истории беседы с нуля.
Однако этот объем памяти стремительно растет, создавая серьезное «бутылочное горлышко» для задержек и инфраструктурных затрат.
Почему KV-кэш становится узким местом при масштабировании
Для обеспечения работы многошаговых ИИ-приложений, таких как ассистенты программиста или чат-боты, большие языковые модели используют механизм, известный как кэш ключей-значений (KV cache). Этот кэш сохраняет скрытые числовые представления для каждого предыдущего токена в диалоге. Поскольку модель помнит прошлое общение, ей не нужно избыточно пересчитывать всю историю чата каждый раз, когда пользователь отправляет новый промпт.
Тем не менее, для ИИ-приложений с задачами на длинный контекст этот кэш может легко раздуваться до нескольких гигабайт. По мере того как модели масштабируются и генерируют все более длинные цепочки рассуждений, KV-кэш становится критическим узким местом для пропускной способности и задержек системы.
Это создает сложную проблему для производственных сред. Поскольку языковые модели сильно ограничены по памяти во время инференса, одновременное обслуживание множества пользователей упирается в исчерпание памяти GPU, а не в вычислительное время. «Эффективное управление KV-кэшем становится критически важным, поскольку неактивные кэши должны быстро выгружаться из памяти GPU для размещения других пользователей и оперативно восстанавливаться для возобновленных диалогов», — рассказал VentureBeat Адриан Ланкуцкий (Adrian Lancucki), старший инженер по глубокому обучению в Nvidia. «Теперь эти инфраструктурные затраты отражаются в коммерческом ценообразовании (например, как «кэширование промптов») с дополнительной платой за кэширование».
Даже компромиссные решения, такие как выгрузка кэша в хранилище низшего уровня (например, память CPU или SSD), создают значительные издержки на передачу данных, которые могут насытить пропускную способность сети и породить новые задержки.
Одно из распространенных решений заключается в сжатии KV-кэша, чтобы он занимал меньше памяти. Тем не менее, существующие решения часто не решают проблему комплексно. Инструменты, предназначенные для сжатия кэшей при передаче по сети, обеспечивают низкую степень сжатия. Другие методы сжатия требуют ресурсоемких вычислений «на лету» для каждого пользовательского промпта. В то же время популярные техники, такие как квантование или разреживание (sparsification), могут приводить к задержкам и падению точности, либо требуют внесения перманентных изменений в веса модели, что ограничивает их практичность.
В своей научной работе исследователи Nvidia отмечают, что существующие подходы «редко используют сильную низкоранговую структуру тензоров KV». Это означает, что несмотря на огромное число измерений и гигабайты объема, актуальная базовая информация в KV-кэше сильно коррелирует и может быть точно представлена с помощью гораздо меньшего числа переменных. Именно на использовании этой особенности сосредоточен метод KVTC.
Заимствование приемов из медиакодеков
На высоком уровне KVTC решает проблему нехватки памяти в ИИ, заимствуя проверенную концепцию из классических медиатехнологий: преобразованное кодирование (transform coding), методологию, которая лежит в основе знакомых форматов сжатия изображений и видео, таких как JPEG. Фреймворк уменьшает объем кэша с помощью быстрого многоэтапного процесса, выполняемого между фазами инференса, чтобы не замедлять фактическую генерацию токенов. «Такой подход «медиакомпрессии» выгоден для корпоративного развертывания, поскольку он ненавязчив: он не требует изменений в весах модели или коде и работает близко к транспортному уровню», — отметил Ланкуцкий.
Сначала KVTC использует анализ главных компонент (PCA) для выравнивания признаков данных KV-кэша в зависимости от их важности. PCA — это статистический метод, часто применяемый в машинном обучении для повышения эффективности моделей путем выделения наиболее критически важных признаков данных и удаления избыточности. Эта часть процесса выполняется лишь единожды на этапе первоначальной калибровки для каждой модели. Поскольку матрица выравнивания PCA вычисляется офлайн и используется повторно, она не замедляет процесс сжатия во время инференса для индивидуальных запросов пользователей.
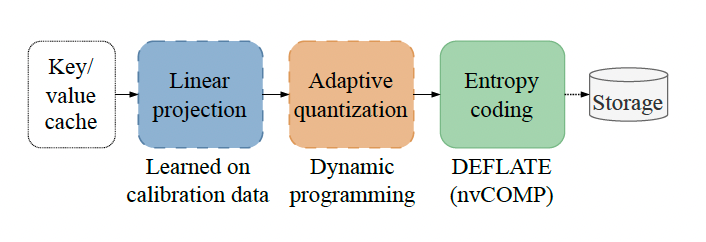
Структура KVTC (источник: arXiv)
Затем система использует алгоритм динамического программирования для автоматического распределения объема памяти, который действительно необходим каждому конкретному измерению данных. Наиболее важным главным компонентам назначается высокая точность, в то время как второстепенным, менее важным компонентам достается меньше бит, либо им присваивается ноль бит, и они полностью отбрасываются.
Наконец, конвейер берет эти оптимизированные, квантованные данные, упаковывает их в байтовый массив и прогоняет через энтропийный кодер под названием DEFLATE. Поскольку этот шаг выполняется параллельно прямо на GPU с использованием библиотеки nvCOMP от Nvidia, он работает на очень высоких скоростях.
Чтобы распаковать данные при возвращении пользователя, KVTC просто выполняет вычисления в обратном порядке. Для ускорения процесса он выполняет основную тяжелую работу по распаковке по частям, слой за слоем. Это позволяет ИИ-модели начать вычисление следующего ответа заблаговременно, используя первый распакованный фрагмент, пока последующие фрагменты распаковываются в фоновом режиме.
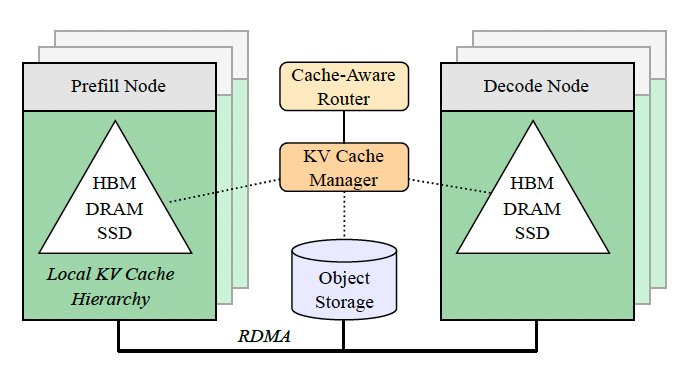
Архитектура развертывания KVTC (источник: arXiv)
Сжатие в 20 раз при падении точности менее чем на 1%
Исследователи Nvidia протестировали KVTC на разнообразном наборе моделей с числом параметров от 1,5 млрд до 70 млрд, включая семейство Llama 3, Mistral NeMo и модели Qwen 2.5 (дистиллированные версии R1, ориентированные на рассуждения). Они оценили эти модели на различных бенчмарках, включая сложные математические задачи и задачи по программированию (например, MATH-500 и LiveCodeBench), а также на интенсивных задачах поиска в длинном контексте, таких как «Иголка в стоге сена» (Needle In A Haystack) и поиск по принципу «ключ-значение».
Они противопоставили KVTC нескольким популярным базовым методам: методам вытеснения токенов (например, H2O и TOVA), методам тяжелого квантования (например, KIVI и GEAR) и xKV (технике сжатия промптов на основе сингулярного разложения).
При эффективном коэффициенте сжатия 20x KVTC стабильно поддерживал производительность с падением точности менее чем на один процентный пункт по сравнению с исходными несжатыми стандартными моделями в большинстве задач. Когда исследователи довели систему до экстремальных пределов сжатия до 32x и 64x, KVTC показал себя на удивление стойко.
В то же время популярные базовые методы, такие как KIVI и GEAR, начинали страдать от масштабной деградации точности уже при пятикратном (5x) сжатии, особенно в задачах с длинным контекстом. Стандартные методы вытеснения кэша, такие как H2O и TOVA, оказались совершенно непригодными в качестве универсальных компрессоров, фактически теряя работоспособность при попытке извлечь информацию из глубокого контекста.
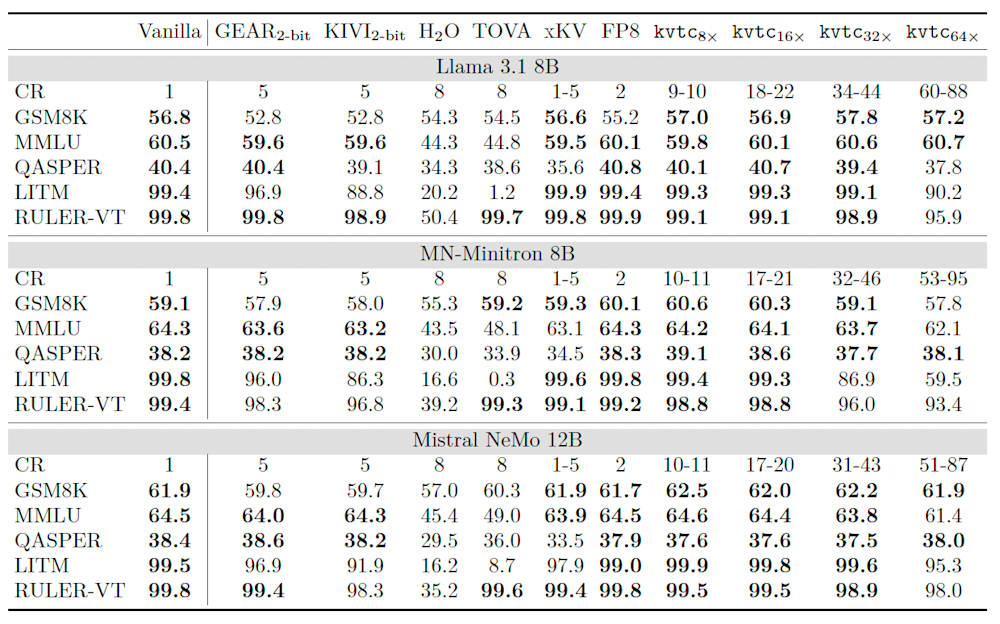
KVTC сохраняет точность на ключевых бенчмарках, значительно сжимая KV-кэш (источник: arXiv)
Рассмотрим развертывание меньшей по размеру рассуждающей модели, такой как Qwen 2.5 1.5B, в качестве ассистента программиста. Обычно этой модели требуется 29 КБ памяти на каждый отдельный токен. При настройке 8-кратного сжатия KVTC сократил этот объем примерно до 3,2 КБ на токен, вызвав при этом ничтожно малое падение точности кодинга на 0,3 процентного пункта.
Для корпоративных архитекторов выбор момента для развертывания этой техники во многом зависит от сценария использования. «KVTC оптимизирован для сценариев с длинным контекстом и многошаговыми диалогами», — пояснил Ланкуцкий. Он выделил в качестве идеальных областей применения ассистенты программиста, итеративные агентные рабочие процессы рассуждения (особенно при ожидании результатов от инструментов с высокой задержкой) и итеративный RAG. «Тем не менее, пользователям стоит пропустить KVTC для коротких диалогов», — добавил он, поскольку в коротких беседах несжатое скользящее окно новейших токенов доминирует в последовательности, препятствуя достижению значимых коэффициентов сжатия.
KVTC отличается высокой переносимостью, и вскоре его оптимизированная реализация будет интегрирована в менеджер блоков KV (KV Block Manager, KVBM) в рамках фреймворка Dynamo, что обеспечит его совместимость с популярными движками инференса с открытым исходным кодом, такими как vLLM.
Что наиболее важно для пользовательского опыта, KVTC существенно сокращает время до первого токена (TTFT) — задержку между отправкой промпта и генерацией моделью первого токена ответа. На промпте из 8 000 токенов стандартной модели размером 12B, работающей на GPU Nvidia H100, требуется примерно 3 секунды на пересчет истории с нуля. Между тем система может распаковать кэш KVTC всего за 380 миллисекунд, обеспечивая сокращение времени генерации первого токена до 8 раз.
Поскольку KVTC не меняет то, как модель обращает внимание на токены (attention), он теоретически совместим с методами вытеснения токенов, такими как динамическое разреживание памяти (Dynamic Memory Sparsification, DMS) — еще одной передовой техникой сжатия. DMS — это авторегрессионный метод вытеснения токенов, который оптимизирует память путем полного выявления и удаления наименее важных токенов из контекстного окна.
«В принципе, KVTC дополняет DMS», — заявил Ланкуцкий. «В то время как DMS вытесняет отдельные токены вдоль временной оси, KVTC сжимает данные в каждой позиции по отдельности». Тем не менее, он предостерег, что, несмотря на нацеленность на разные измерения, «еще предстоит проверить, каких коэффициентов сжатия можно достичь с помощью KVTC на разреженных кэшах».
По мере того как модели продолжают нативно масштабироваться до контекстных окон размером в несколько миллионов токенов, потребность в надежном управлении памятью будет только расти. «Учитывая структурное сходство и повторяющиеся паттерны в KV-кэшах различных архитектур моделей, появление выделенного стандартизированного слоя сжатия весьма вероятно», — считает Ланкуцкий. При поддержке аппаратных достижений инфраструктура ИИ вскоре сможет рассматривать сжатие KV-кэша как невидимый стандартизированный слой, подобно тому, как сжатие видео воспринимается в современных стриминговых сервисах.




