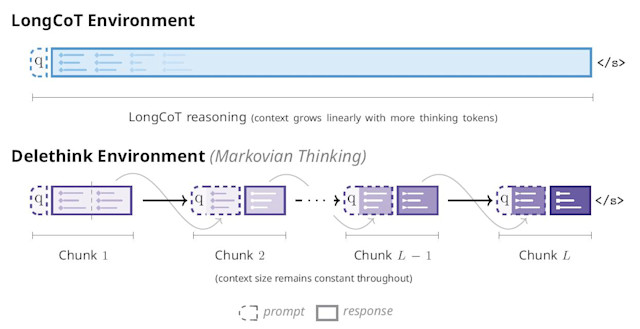
Исследователи из института Mila предложили новую технику, которая делает большие языковые модели (LLM) значительно более эффективными при выполнении сложных задач на рассуждение. Под названием Markovian Thinking («Марковское мышление») этот подход…
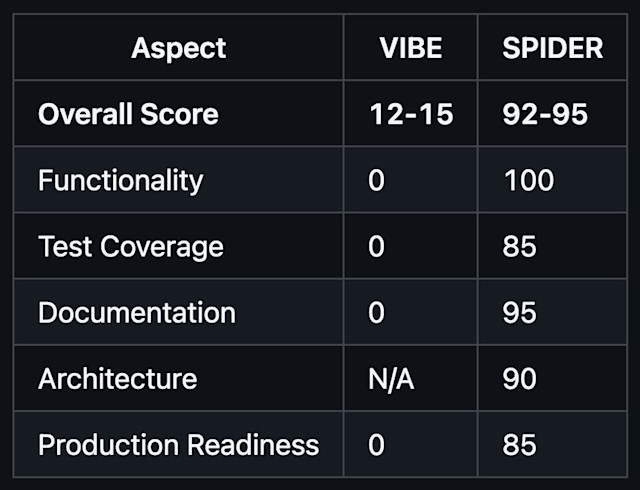
Для многих разработчиков ПО, использующих генеративный ИИ, вайб-кодинг — это палка о двух концах. Этот процесс позволяет быстро создавать прототипы, но часто оставляет после себя хрупкий, недокументированный код, который создает…
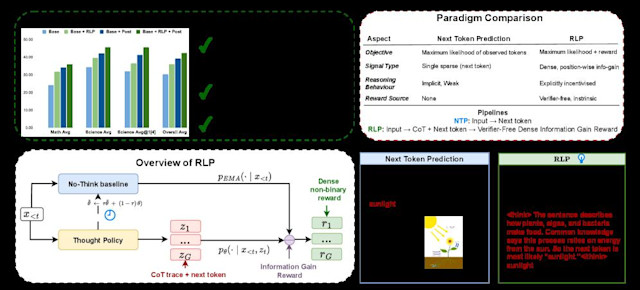
Исследователи из Nvidia разработали новый подход, который кардинально меняет представление о том, как большие языковые модели (LLM) учатся рассуждать. Этот метод, получивший название предварительное обучение с подкреплением (reinforcement learning pre-training,…
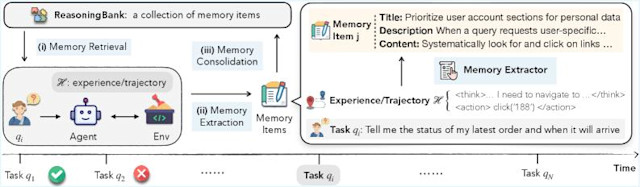
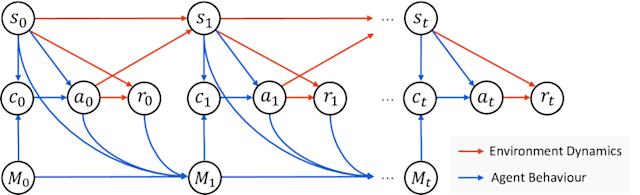
Исследователи из Иллинойсского университета в Урбане-Шампейне и подразделения Google Cloud AI Research разработали фреймворк, который позволяет агентам на базе больших языковых моделей (LLM) организовывать свой опыт в банк памяти, помогая…
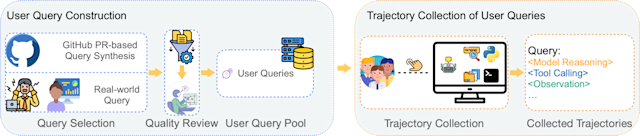
Новое исследование, проведенное Шанхайским университетом Цзяо Тун и Исследовательской лабораторией генеративного ИИ SII (GAIR), показывает, что для обучения больших языковых моделей (LLM) сложным автономным задачам не требуются огромные массивы данных.…
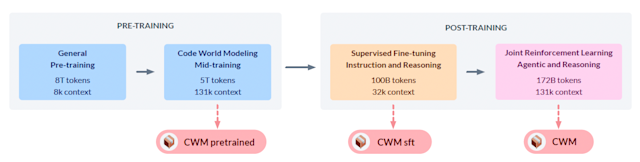
Исследовательская команда по искусственному интеллекту компании Meta выпустила новую большую языковую модель (LLM) для написания кода, которая улучшает понимание программ за счет изучения не только того, как код выглядит, но…
Лаборатория Tongyi компании Alibaba представила новый обучающий фреймворк с открытым исходным кодом, который позволяет обучать открытые большие языковые модели (LLM) для конкуренции с ведущими коммерческими моделями для глубоких исследований. Эта…
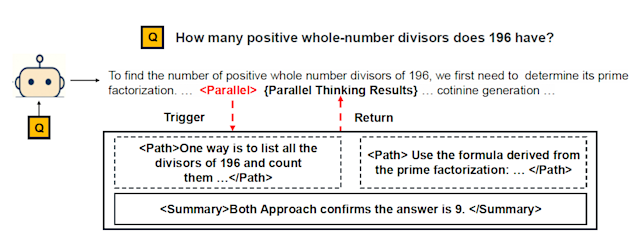
В новой научной работе исследователи из Tencent AI Lab Seattle и Мэрилендского университета в Колледж-Парке представляют метод обучения с подкреплением, который позволяет большим языковым моделям (LLM) эффективнее использовать масштабирование на…
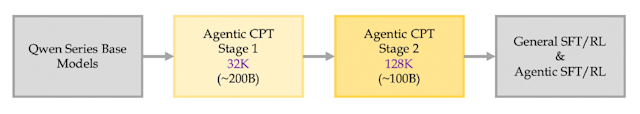
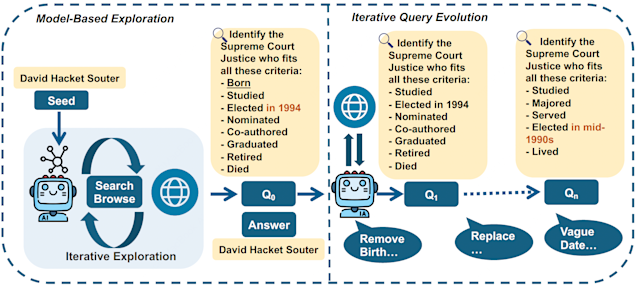
Исследователи из Гонконгского университета науки и технологии, компании MiniMax и Университета Ватерлоо представили новый фреймворк для создания более умных и эффективных агентов для поиска и просмотра веб-страниц. Этот фреймворк, получивший…
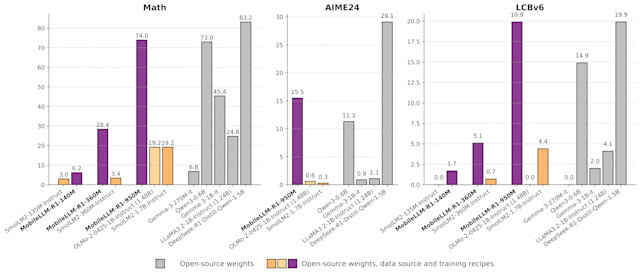
Мощность ИИ-моделей долгое время соотносилась с их размером: модели разрастались до сотен миллиардов и триллионов параметров. Однако столь масштабные модели создают для бизнеса очевидные проблемы, включая отсутствие контроля над базовой…
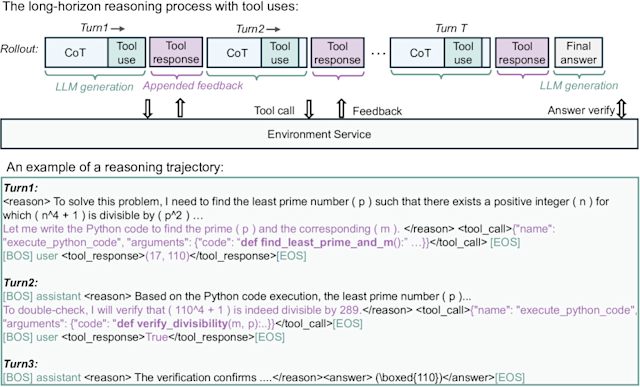
Подразделение Microsoft Research разработало новый фреймворк на основе обучения с подкреплением, который обучает большие языковые модели сложным задачам логического рассуждения со значительным сокращением обычных вычислительных затрат. Фреймворк, получивший название rStar2-Agent,…
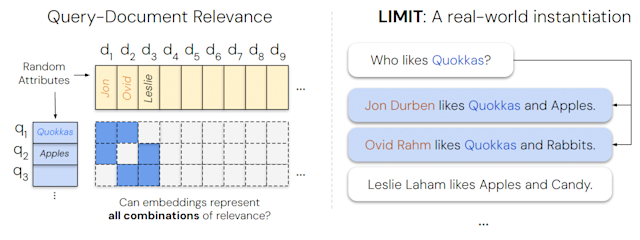
Векторные вложения (эмбеддинги) представляют собой основу современного корпоративного ИИ, обеспечивая работу всего — от генерации с дополненной выборкой (RAG) до семантического поиска. Однако новое исследование Google DeepMind выявляет фундаментальное математическое…
Новая парадигма обучения, разработанная Университетским колледжем Лондона (UCL) и Huawei Noah’s Ark Lab, позволяет агентам на базе больших языковых моделей (LLM) динамически адаптироваться к окружающей среде без тонкой настройки (fine-tuning)…
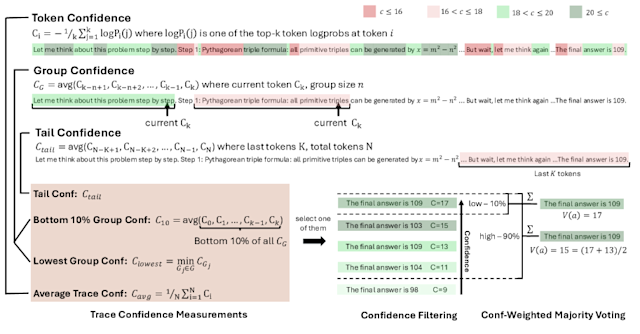
Новый метод масштабирования на этапе тестирования (test-time scaling), разработанный исследователями из Meta AI и Калифорнийского университета в Сан-Диего (UC San Diego), предлагает набор инструментов («регуляторов»), которые помогают компаниям поддерживать точность…
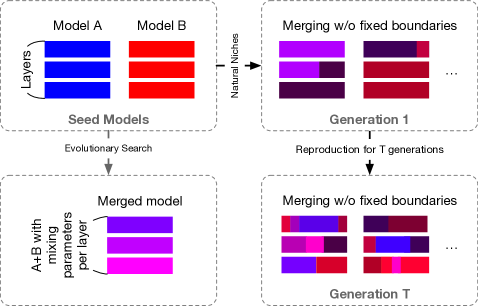
Новый эволюционный метод от японской ИИ-лаборатории Sakana AI позволяет разработчикам расширять возможности моделей искусственного интеллекта без дорогостоящих процессов обучения и дообучения (fine-tuning). Эта техника, получившая название Model Merging of Natural…