


Agent rStar2 от Microsoft повышает эффективность ИИ


Подразделение Microsoft Research разработало новый фреймворк на основе обучения с подкреплением, который обучает большие языковые модели сложным задачам логического рассуждения со значительным сокращением обычных вычислительных затрат. Фреймворк, получивший название rStar2-Agent, использует комбинацию алгоритмических инноваций и программных оптимизаций для повышения эффективности процесса обучения, требуя меньше данных и более рационально задействуя аппаратное обеспечение.
Модель с 14 миллиардами параметров, дообученная с помощью rStar2-Agent, демонстрирует производительность, близкую к современному уровню (state-of-the-art), превосходя гораздо более крупную модель DeepSeek-R1 с 671 млрд параметров на ключевых математических бенчмарках и при этом генерируя более короткие и лаконичные ответы. Для корпоративного сектора эти результаты открывают новый путь к созданию более надежных и экономически эффективных ИИ-агентов, а также позволяют извлекать больше пользы из небольших моделей с открытым исходным кодом.
От «долгих размышлений» к «умным размышлениям»
Современные ИИ-модели часто улучшают свои способности к рассуждению за счет генерации более длинных цепочек мыслей (CoT — Chain of Thought), фактически «дольше думая» над проблемой. Несмотря на эффективность, этот подход имеет свои ограничения, особенно при решении сложных задач, где одна ошибка в длинной цепочке рассуждений может пустить под откос весь процесс. В таких случаях модели полагаются на внутреннюю саморефлексию, которая часто не справляется с обнаружением ошибок или исправлением некорректного подхода. Исследователи из Microsoft предлагают совершить переход от «долгих размышлений» к «умным размышлениям», наделяя модели продвинутыми когнитивными способностями для использования инструментов, проверки своей работы и обучения на основе обратной связи.
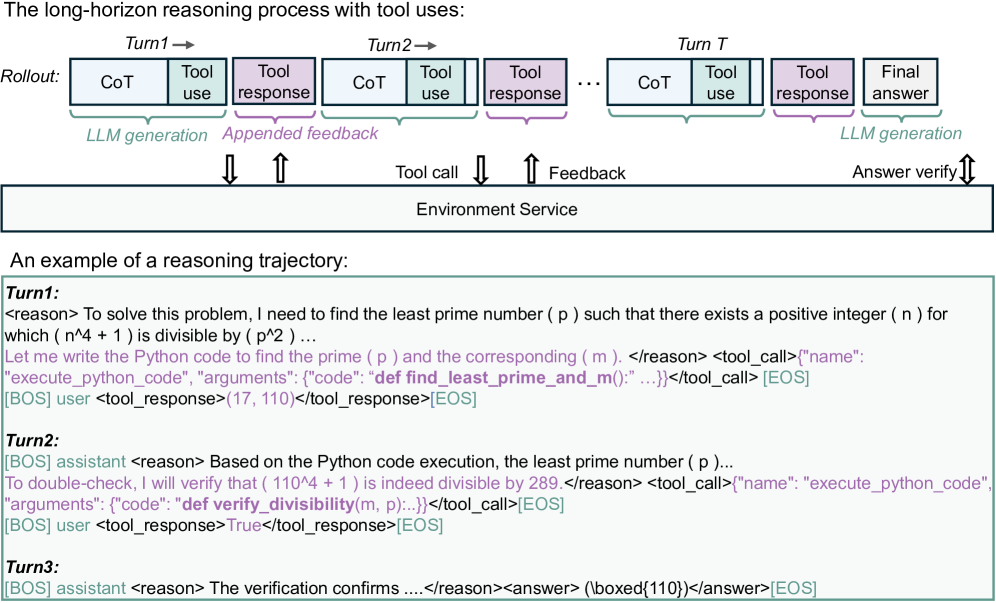
Этот интеллектуальный подход реализуется с помощью метода, называемого «агентным обучением с подкреплением» (agentic reinforcement learning). Модель выступает в роли агента, который взаимодействует с инструментами в специализированной среде, адаптируя свои рассуждения на основе получаемой обратной связи. Исследователи сосредоточились на использовании языка программирования Python и его интерпретатора в качестве среды инструментов. Это позволяет модели изучать альтернативные решения, выполнять вычисления и проверять промежуточные этапы в дополнение к стандартным цепочкам CoT.
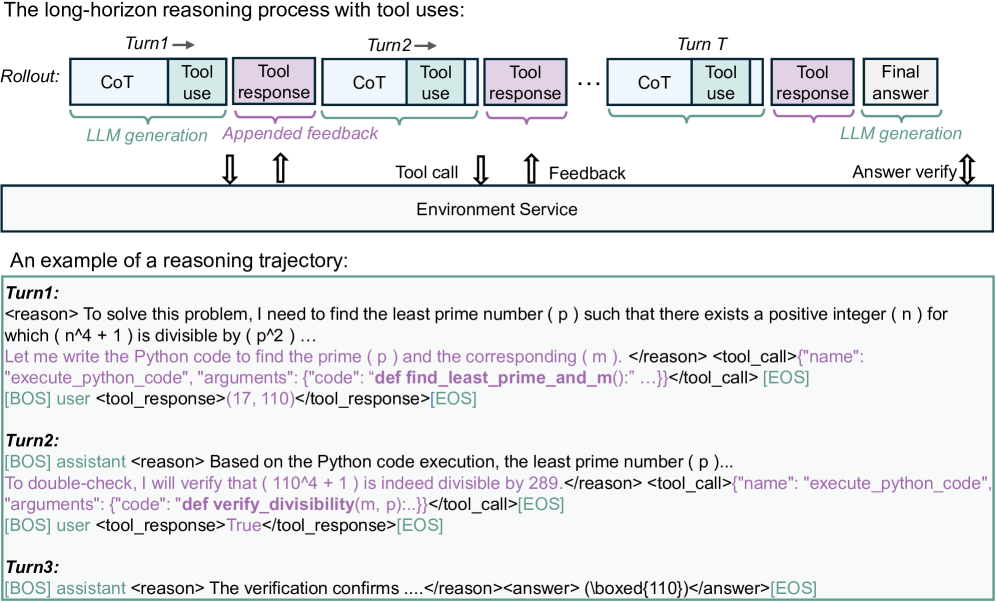
Агентное обучение с подкреплением использует внешние инструменты для проверки цепочек рассуждений (источник: arXiv)
В такой конфигурации модель вступает в многошаговый диалог со средой кода. Она генерирует элемент рассуждения, вызывает инструмент Python для выполнения команды, получает результат и включает эту обратную связь в следующий шаг рассуждений, повторяя процесс до тех пор, пока не будет найден окончательный ответ.
Однако масштабирование этого подхода сопряжено со значительными трудностями. Сложность инструментов программирования может привносить шум в процесс. Например, сообщение об ошибке, вызванное некорректным кодом, может отвлечь модель от основной задачи рассуждения. Кроме того, инфраструктура, необходимая для крупномасштабного агентного обучения, крайне требовательна: один обучающий батч может инициировать десятки тысяч вызовов инструментов, которыми необходимо управлять эффективно и безопасно.
Как работает фреймворк rStar2-Agent
Для преодоления этих присущих методу сложностей в rStar2-Agent реализованы три ключевые инновации:
Эффективная и надежная инфраструктура: Создание масштабируемой среды для агентов, использующих инструменты, было серьезным инженерным препятствием. Ли Лина Чжан (Li Lyna Zhang), главный исследователь Microsoft и соавтор научной работы, рассказала VentureBeat, что первые попытки сталкивались с практическими проблемами. «Каждый шаг обучения мог вызывать десятки тысяч обращений к инструментах, — отметила Чжан. — Сначала простое параллельное выполнение приводило к потере запросов, что дезориентировало модель, а процессоры (CPU) были перегружены, в то время как графические процессоры (GPU) простаивали, замедчая развертывание». Она также подчеркнула риск появления «непредсказуемых и потенциально небезопасных ответов от языковой модели», способных дестабилизировать всю систему.
Для решения этой проблемы в rStar2-Agent предусмотрена высокопроизводительная изолированная среда кода, способная обрабатывать до 45 000 одновременных вызовов инструментов за один шаг со средней задержкой в 0,3 секунды. В нее встроен планировщик с балансировкой нагрузки, который динамически распределяет запросы между графическими процессорами для устранения неэффективности RL-обучения, возникающей из-за разной длины путей рассуждений (также называемых «прогонами» или rollout). Этот планировщик управляет асинхронными вызовами инструментов и балансирует вычислительную нагрузку между GPU, гарантируя, что устройства не будут простаивать после завершения запроса. Такая надежная инфраструктура обеспечивает эффективное RL-обучение даже при ограниченных ресурсах графических процессоров.
Оптимизация групповой относительной политики с перевыборкой на правильных ответах (GRPO-RoC): Эта инновация развивает концепцию групповой относительной оптимизации политики (GRPO — Group Relative Policy Optimization), базового алгоритма обучения с подкреплением, который используется в таких моделях, как DeepSeek-R1 и Phi-4. В стандартном GRPO модель генерирует группы путей рассуждений для конкретной задачи и получает простую бинарную награду (правильно или неправильно) за окончательный ответ. Затем алгоритм оптимизирует политику модели на основе относительного успеха этих прогонов внутри группы. Тем не менее, традиционный GRPO сталкивается с трудностями в агентном обучении с подкреплением, особенно из-за зашумленной обратной связи от среды кода.
Алгоритм GRPO-RoC расширяет этот подход, устраняя экологический шум и повышая качество обучающих сигналов. Это достигается за счет стратегии «Перевыборка на правильных ответах» (RoC — Resample on Correct). Сначала RoC избыточно сэмплирует большую группу прогонов, а затем выбирает подмножество для создания обучающего батча. Алгоритм фильтрует положительные траектории, оставляя только те, которые имеют минимальное количество ошибок, вызванных инструментами, или проблем с форматированием. В то же время он производит понижающую дискретизацию (downsampling) неудачных траекторий, чтобы сохранить разнообразные сценарии ошибок в качестве ценных обучающих сигналов.
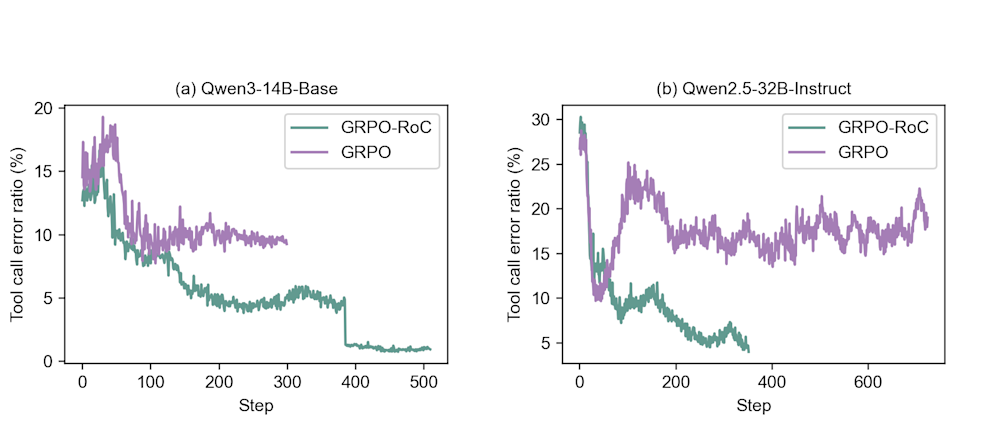
GRPO-RoC превосходит классический GRPO по мере увеличения количества шагов обучения (источник: arXiv)
В корпоративной среде такой фокус на чистых и качественных рассуждениях напрямую трансформируется в более надежные приложения. Чжан приводит наглядный пример: «Автоматизированный агент по написанию кода, создающий скрипт обработки данных, в противном случае мог бы выдать длинный код с ошибками, требующий многократных исправлений. С помощью GRPO-RoC модель учится генерировать лаконичный, корректный код, который успешно выполняется с первой попытки, делая рабочий процесс плавным и предсказуемым. Это повышает надежность и стабильность результатов, что критически важно для корпоративных приложений».
Специализированный рецепт обучения: rStar2-Agent использует уникальный рецепт обучения, который минимизирует вычислительные требования. Вместо того чтобы начинать со сложных задач на рассуждение, начальный этап обучения (контролируемое дообучение без рассуждений, или SFT) фокусируется на обучении модели основам: следованию общим инструкциям, а также правильному форматированию и использованию инструментов программирования. Это позволяет избежать раннего переобучения модели под конкретные паттерны рассуждений. После этого модель проходит многоэтапный процесс RL-обучения, в ходе которого сложность задач и максимальная длина ответов постепенно увеличиваются. В отличие от других методов, требующих очень большой длины ответов (16 000 токенов и более), этот подход начинается с меньшей длины (8 000 токенов) и постепенно масштабируется (до 12 000 токенов) от этапа к этапу, что становится возможным благодаря эффективности алгоритма GRPO-RoC.
Маленькая модель, которая превосходит ожидания
Чтобы протестировать фреймворк, исследователи дообучили 14-миллиардную модель Qwen3-14B-base, используя 64 графических ускорителя AMD MI300X. Весь процесс занял всего одну неделю при задействовании лишь 510 шагов RL-обучения — разительный контраст с другими методами, требующими тысяч шагов. Полученные результаты демонстрируют, что сравнительно небольшая модель способна достичь производительности рассуждений верхнего уровня при минимальных затратах вычислительных ресурсов.
Их выводы показывают, что rStar2-Agent существенно выводит базовую 14-миллиардную модель на уровень современных передовых решений, догоняя и даже превосходя более интенсивно обучавшиеся и гораздо более крупные пограничные LLM. На бенчмарке AIME24 модель rStar2-Agent-14B показала среднюю точность в 80,6%, превзойдя 03-mini от OpenAI, DeepSeek-R1 и Claude Opus 4.0 (с режимом размышлений).
«Эти результаты особенно примечательны, учитывая небольшой масштаб в 14B и высокую экономичность вычислительных ресурсов для обучения», — отмечают исследователи в своей научной работе.
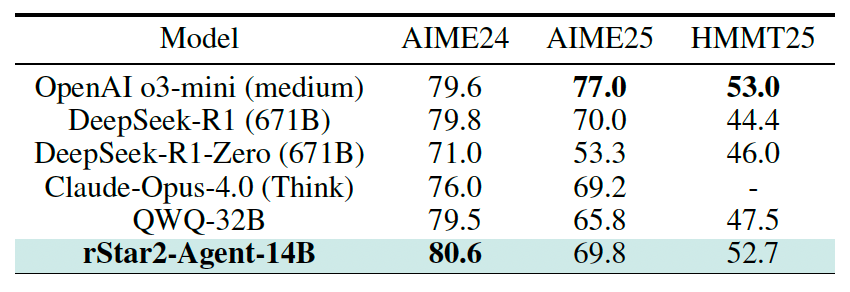
rStar2-Agent-14B превосходит ожидания при меньшем количестве параметров и более коротком цикле обучения (источник: arXiv)
Хотя результаты модели на 14B впечатляют, исследователи подчеркивают, что истинная инновация заключается в самом методе, который не привязан к конкретному размеру модели. «Мы провели эксперименты на модели 14B главным образом для того, чтобы продемонстрировать эффективность и превосходство подхода rStar2-Agent, — пояснила Чжан. — Мы ожидаем, что применение rStar2-Agent к более крупным моделям обеспечит еще более высокие показатели рассуждений». Для бизнеса это означает, что фреймворк предлагает двойное преимущество: его можно использовать для создания высокоэффективных специализированных небольших моделей, а также он прокладывает путь к разработке передовых больших моделей нового поколения на основе тех же принципов надежности и эффективности.
Обученная модель также продемонстрировала «более умные рассуждения», используя меньшее количество токенов. На сложных математических бенчмарках rStar2-Agent-14B достигла более высокой точности, чем ее более крупные аналоги, генерируя при этом существенно более короткие ответы. Исследователи отмечают, что, «подкрепляя более качественные положительные траектории, наша модель эффективно научилась более интеллектуально использовать инструменты программирования для более эффективного рассуждения». Такая эффективность является критическим фактором для корпоративных приложений, поскольку более короткие ответы напрямую означают снижение затрат на инференс и более высокую скорость работы.
Наконец, модель продемонстрировала сильные способности к генерализации. Несмотря на обучение исключительно на математических задачах, она успешно справилась с разнообразным набором задач, включая научные рассуждения и использование агентных инструментов. На научном бенчмарке GPQA-Diamond она превзошла DeepSeek-V3, показав, что навыки рассуждения, приобретенные при решении математических задач, могут быть успешно перенесены в другие домены.
Заглядывая в будущее, исследователи видят потенциал этого агентного подхода, ориентированного на инструменты, далеко за пределами математики — в других сложных и ценных областях. «В разработке лекарств он может получить доступ к химическим и биологическим базам данных и запускать симуляции», — предположила Чжан, также указав на сферы правового анализа и финансового моделирования.
Тем не менее, она отметила, что переход от структурированного мира интерпретатора Python к более неоднозначным корпоративным инструментам из реального мира представляет собой следующий круг задач. Эти инструменты привносят больше «шума среды» и требуют специализированных, надежных сред для взаимодействия языковой модели. Успешное преодоление этой сложности станет ключом к открытию новой волны агентного ИИ в корпоративном сегменте.




