DeepConf от Meta AI снижает затраты на языковые модели на 84,7%


Новый метод масштабирования на этапе тестирования (test-time scaling), разработанный исследователями из Meta AI и Калифорнийского университета в Сан-Диего (UC San Diego), предлагает набор инструментов («регуляторов»), которые помогают компаниям поддерживать точность рассуждений больших языковых моделей (LLM) при одновременном существенном сокращении затрат на инференс. Метод, получивший название DeepConf, использует сигналы внутренней уверенности моделей для динамической фильтрации некачественных цепочек рассуждений.
В ходе тестирования на сложных бенчмарках для проверки логического мышления DeepConf продемонстрировал точность до 99,9% и сократил количество генерируемых токенов на величину до 84,7% по сравнению со стандартными методами. Поскольку метод применим к открытым моделям, не требует дополнительного обучения и может быть интегрирован в существующие инфраструктуры обслуживающего ПО, DeepConf представляет собой полезный инструмент для реальных приложений на базе открытых LLM.
Высокая цена процесса мышления
Для улучшения способностей LLM к логическому выводу при решении сложных задач разработчики часто используют методы масштабирования на этапе тестирования. Одним из популярных подходов является «самосогласованность с мажоритарным голосованием» (self-consistency with majority voting), когда модель получает один и тот же промпт несколько раз, а в качестве финального ответа выбирается наиболее часто встречающийся вариант. Несмотря на свою эффективность, эта техника влечет за собой значительные вычислительные затраты. Генерация сотен трасс рассуждений для одного промпта существенно увеличивает стоимость инференса, что делает такой подход непрактичным для многих сценариев применения.
Кроме того, данный подход может давать убывающую отдачу по мере увеличения количества трасс. Суть проблемы заключается в том, что стандартное мажоритарное голосование рассматривает каждую цепочку рассуждений как равноправную, независимо от ее качества. Это может привести к неоптимальным результатам, если несколько низкокачественных, но похожих ответов доминируют в процессе голосования и перевешивают правильный ответ.
В предыдущих исследованиях изучался расчет оценки «глобальной уверенности» (global confidence) для всей цепочки рассуждений на основе уровней уверенности внутренних активаций модели. Это помогает отсеять часть некачественных путей, но имеет свои ограничения. Глобальная оценка может скрывать критические сбои, происходящие на определенных этапах процесса рассуждения. Что еще важнее, она требует от модели генерации полной трассы перед ее оценкой, что исключает любую возможность ранней остановки и экономии средств.
Осмысление с уверенностью
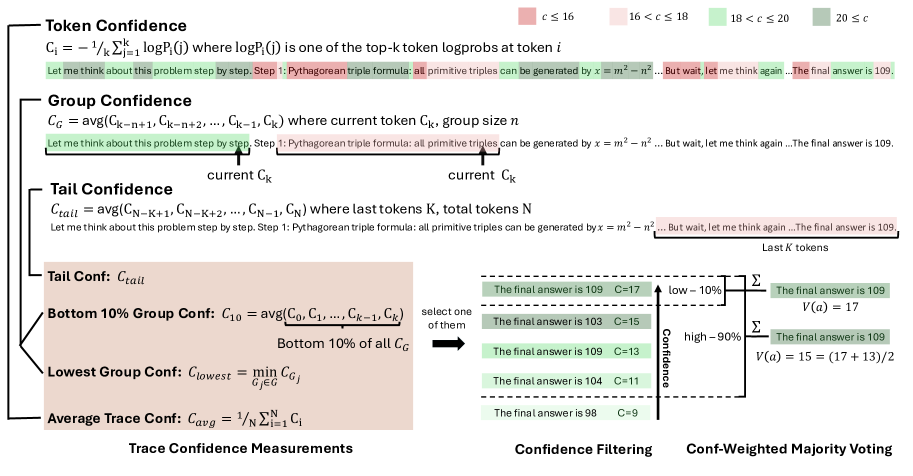
Deep Think with Confidence (DeepConf) — новая методика от Meta AI и UCSD — использует более тонкую систему фильтрации с учетом уверенности, основанную на локальных измерениях этого параметра. Вместо единой глобальной оценки исследователи внедрили несколько альтернативных метрик для более детальной оценки качества ответа на основе уверенности модели в различных частях ее ответа.
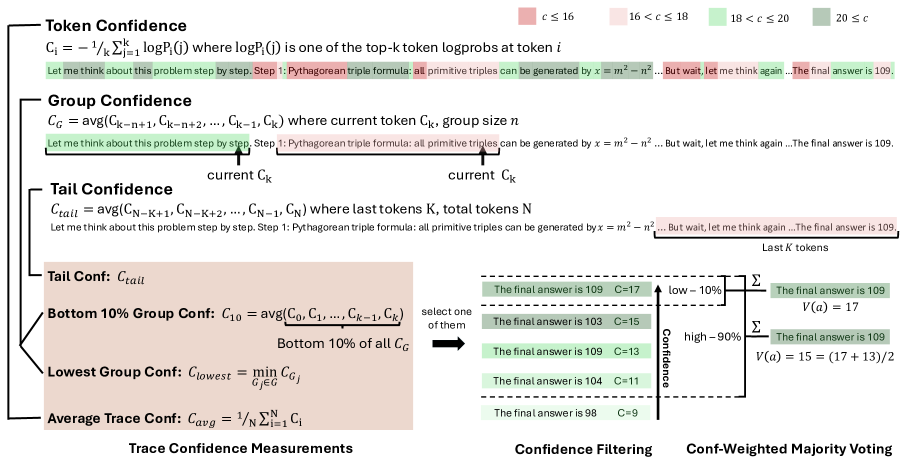
DeepConf использует различные метрики для измерения уверенности в цепочках рассуждений (источник: arXiv)
Эти метрики включают «групповую уверенность» (group confidence), которая рассчитывает уверенность по различным сегментам токенов, сгенерированных моделью, и «хвостовую уверенность» (tail confidence), фокусирующуюся на заключительной части рассуждения. Еще одна метрика — «минимальная групповая уверенность» (lowest group confidence), которая определяет единственный наименее уверенный сегмент в цепочке рассуждений. Идея заключается в том, что логическая цепочка сильна ровно настолько, насколько силно ее самое слабое звено; резкое падение уверенности часто сигнализирует о критической ошибке, даже если остальная часть трассы выглядит уверенной.
DeepConf работает в двух основных режимах. В режиме «автономного мышления» (offline thinking) сначала генерируются все трассы рассуждений. Затем DeepConf использует свои метрики уверенности, чтобы либо присвоить ответам весовые коэффициенты (усиливая влияние трасс с высокой степенью уверенности), либо полностью отфильтровать наименее уверенные трассы перед проведением финального голосования. Это позволяет нивелировать недостатки классического мажоритарного голосования.
В режиме «интерактивного мышления» (online thinking) система оценивает качество трассы в режиме реального времени по мере генерации токенов. Если групповая уверенность падает ниже заранее определенного порога, модель немедленно прекращает генерацию этой трассы и переходит к следующей. Такое динамическое прерывание особенно ценно в условиях ограниченных ресурсов или в приложениях, где критически важна скорость ответов. Исследователи предлагают два варианта для этого режима: DeepConf-low (агрессивная фильтрация трасс для максимизации производительности и экономии) и DeepConf-high (более консервативный вариант, в приоритете которого стоит сохранение базовой точности).
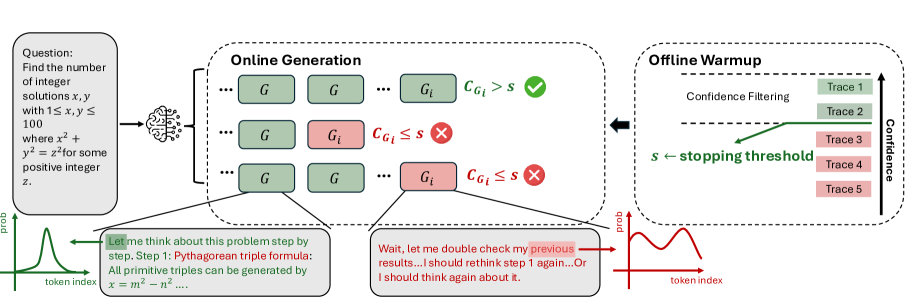
Режим «интерактивного мышления» DeepConf останавливает рассуждения прямо посреди ответа, если уровень уверенности модели падает (источник: arXiv)
DeepConf в действии
Исследователи оценили эффективность DeepConf на нескольких недавних открытых моделях, включая DeepSeek-8B, Qwen3-32B и серию GPT-OSS, используя сложные бенчмарки для проверки математических и STEM-способностей, такие как AIME и HMMT. Они сравнили производительность метода со стандартной генерацией одной трассы и самосогласованностью с мажоритарным голосованием.
В автономных тестах DeepConf стабильно превосходил стандартное мажоритарное голосование. Стратегия агрессивной фильтрации (при которой сохраняются только 10% трасс с наибольшей уверенностью) принесла наибольший прирост. Например, она повысила точность модели DeepSeek-8B на бенчмарке AIME25 с 82,3% до 87,4%. Примечательно, что с моделью GPT-OSS-120B на том же бенчмарке была достигнута точность 99,9%, фактически насытив его.
Интерактивная оценка продемонстрировала значительный рост эффективности за счет сокращения количества токенов, генерируемых моделями. По сравнению с базовым уровнем, агрессивная настройка DeepConf-low сократила генерацию токенов на 43–79% на различных бенчмарках, при этом в большинстве случаев сохраняя или улучшая точность. Например, на датасете AIME24 настройка DeepConf-low повысила точность DeepSeek-8B на 5,8 процентных пункта, расходуя при этом на 77,9% меньше токенов.
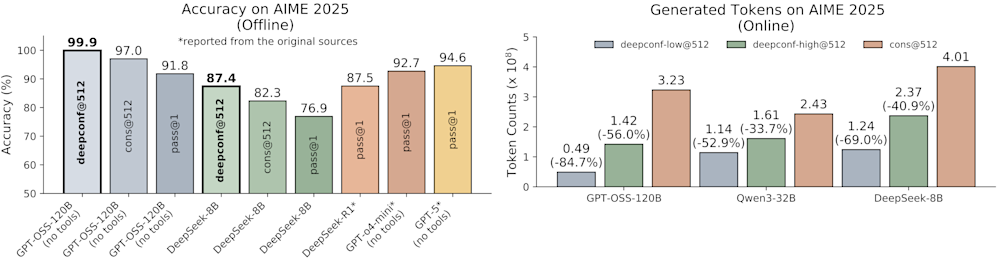
DeepConf повышает точность методов масштабирования на этапе тестирования, одновременно снижая потребление токенов LLM (источник: arXiv)
В скором времени исследователи опубликуют код DeepConf на GitHub.
Отвечая на вопросы корпоративных лидеров о трудоемкости внедрения, соавтор научной работы и научный сотрудник Meta AI Цзявэй Чжао (Jiawei Zhao) пояснил, что DeepConf разработан с расчетом на простоту интеграции. «Это скорее плагин-слой поверх существующего стека обслуживания», — отметил он. Для команд, которые уже используют методы параллельной генерации, такие как мажоритарное голосование, внедрение автономного режима является «изменением по принципу plug-and-play». Более эффективный интерактивный режим требует добавления «небольшого перехватчика в процессе генерации, который отслеживает вероятности токенов в реальном времени», что, по его словам, представляет собой незначительную правку, а не масштабную переработку кода. Команда активно работает над интеграцией с популярными фреймворками инференса, такими как vLLM; поддержку также изучают разработчики SGLang и TensorRT-LLM.
Тем не менее, важно применять DeepConf там, где он наиболее эффективен. «DeepConf лучше всего подходит для задач структурного логического вывода, таких как математика, естественные науки или программирование, где внутренняя уверенность модели отражает качество ее рассуждений», — отмечает Чжао. Для более субъективных открытых задач, таких как суммаризация документов или генерация маркетингового контента, сигнал уверенности, по его словам, «транслируется не столь однозначно», поскольку там нет длинной цепочки рассуждений для измерения.
Такой фокус на структурных рассуждениях подразумевает четкий компромисс, которым корпоративные руководители могут управлять. Чжао уточняет, что выбор между агрессивным и консервативным режимами сводится к допустимому уровню риска для конкретного сценария использования. Для критически важных приложений вроде финансового анализа или юридической экспертизы, где надежность превыше всего, он рекомендует использовать DeepConf-high. Этот более безопасный режим «все же сокращает затраты на генерацию примерно наполовину, оставаясь при этом очень близким к базовой точности модели».
В то же время более агрессивный режим DeepConf-low, способный обеспечить экономию токенов на уровне 70-85%, лучше подходит для менее критичных задач — например, запросов к внутренней базе знаний или генерации первых черновиков, «где скорость и стоимость важнее абсолютной правильности». Это дает компаниям четкий рычаг для настройки баланса между стоимостью и надежностью под их конкретные нужды.
Поскольку компании все чаще полагаются на LLM для решения сложных задач, управление затратами на инференс в масштабе становится критически важной задачей. Делая рассуждения более эффективными без необходимости дорогостоящего повторного обучения, DeepConf предлагает практичный путь вперед. Исследователи заключают: «Мы надеемся, что этот метод подчеркнет потенциал компрессии на этапе тестирования как практичного и масштабируемого решения для эффективного логического вывода LLM».
Заглядывая в будущее, Чжао считает, что потенциал этой концепции выходит далеко за рамки простой экономии токенов. Он рассматривает ее как фундаментальный шаг на пути к более автономным системам ИИ, способным «делать паузу при неуверенности, менять стратегию или даже запрашивать уточнения», когда их уровень уверенности падает. Подобное внутреннее самосознание может стать ключом к созданию следующего поколения более надежных и адаптивных систем искусственного интеллекта для корпоративного сектора.