Модель CWM LLM от Meta улучшает понимание кода


Исследовательская команда по искусственному интеллекту компании Meta выпустила новую большую языковую модель (LLM) для написания кода, которая улучшает понимание программ за счет изучения не только того, как код выглядит, но и того, что он делает при выполнении. Модель под названием Code World Model (CWM) обучена на огромных объемах данных, демонстрирующих взаимодействие кода с его окружением, что позволяет ей создавать внутреннюю «модель мира» принципов работы вычислительных систем.
Помимо изучения динамики своего окружения, CWM демонстрирует высокие результаты на стандартных тестах по программированию и математике, открывая потенциальное новое направление для обучения ИИ-агентов, способных решать более сложные и динамичные задачи разработки программного обеспечения в корпоративной среде. CWM является частью более широких усилий по выходу LLM за рамки простого прогнозирования следующего токена в сторону разработки моделей мира.
Ограничения стандартной генерации кода
Несмотря на недавние достижения в области генерации кода с помощью ИИ, создание высококачественного и надежного кода остается сложной задачей даже для самых продвинутых LLM. Исследователи из Meta предполагают, что причина кроется в недостаточности типичной парадигмы обучения для освоения всей сложности программирования.
Обычно модель учится программировать, прогнозируя следующую инструкцию в программе, подобно тому, как она предсказывает следующее слово в предложении. Однако исследователи утверждают, что для истинного освоения программирования модель должна понимать «не только то, как выглядит код, но и то, что он делает при выполнении». Этот навык является фундаментальным для инженеров-программистов, которые имеют общее представление о том, как изменения в коде повлияют на локальные переменные или общее поведение их приложения. Программисты мыслят кодом не как последовательностью токенов, а как набором связанных компонентов (переменных, объектов, функций, модулей и т. д.), которые они затем переводят в последовательность инструкций. Иными словами, они строят «модель мира» своего приложения по мере его создания или внесения в него изменений.
Эту способность «моделирования мира» в LLM часто упускают из виду до завершения основного обучения, и команда Meta бросает вызов такому подходу.
Как работает Code World Model
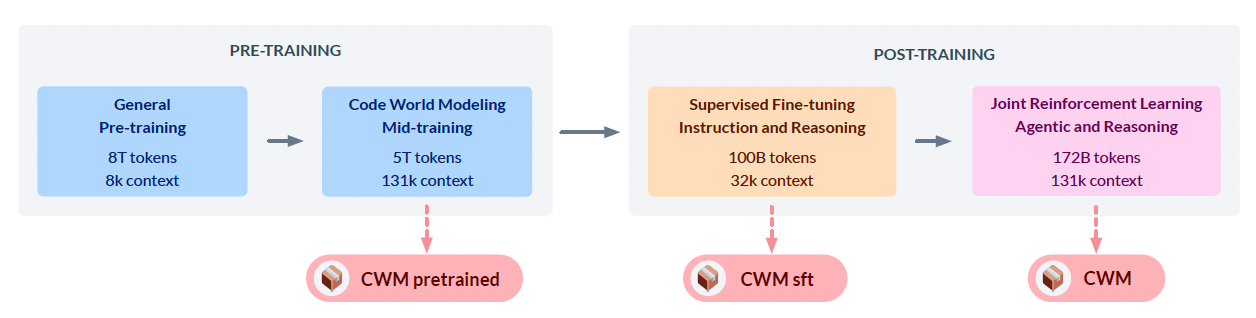
CWM — это новая LLM, призванная решить эти проблемы путем обучения на обширных «данных моделирования мира кода». Вместо того чтобы ждать этапа финальной донастройки (fine-tuning), CWM обучают поведению кода на этапе «промежуточного обучения» (mid-training). Предполагается, что привязка прогнозов модели к динамике вычислительных сред на раннем этапе обеспечивает гораздо более прочную основу для последующего обучения и этапов обучения с подкреплением.
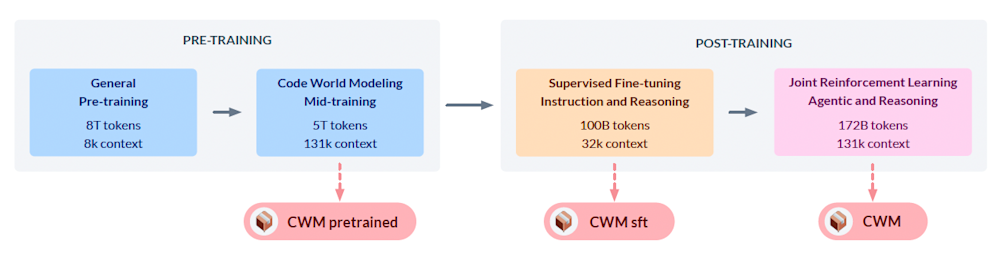
Этапы промежуточного обучения CWM (источник: arXiv)
Исследователи сосредоточились на двух ключевых типах данных. Первый — это трассировки выполнения кода на Python, представляющие собой пошаговые записи изменений внутреннего состояния программы (например, переменных) при выполнении каждой строки кода (это контрастирует с классической схемой обучения, где модели обучаются на коде и финальных результатах). Обучаясь на таких траекториях «наблюдение-действие», CWM получает более глубокое понимание того, как инструкции влияют на общее поведение программы. «Наша предпосылка заключается в том, что обучение CWM семантике, а не только синтаксису программ, должно помочь как в написании кода, так и в задачах рассуждения, таких как верификация, тестирование и отладка», — пишут исследователи.
Второй тип данных состоит из агентных взаимодействий в средах Docker. Команда создала генератор синтетических данных под названием ForagerAgent, который имитирует агента-программиста, выполняющего такие задачи, как исправление ошибок или реализация новых функций. Наблюдая за этими многошаговыми взаимодействиями в больших масштабах на ранней стадии обучения, CWM изучает динамику этих сред еще до того, как пройдет донастройку для конкретных задач в аналогичных условиях.
На практике это позволяет CWM рассуждать о коде способом, имитирующим действия человека-разработчика. Например, при решении задачи по спортивному программированию CWM может создать исходное решение, затем разработать собственные тесты ввода-вывода для проверки правильности и, наконец, сравнить предсказанный вывод с фактическими результатами выполнения кода. Этот цикл самопроверки является прямым результатом обучения на основе модели мира.
CWM в действии
Исследователи из Meta использовали эти данные и рецепт обучения для создания модели с 32 миллиардами параметров и окном контекста до 131 000 токенов. Модель демонстрирует многообещающие результаты на ключевых отраслевых бенчмарках. На SWE-bench Verified — бенчмарке, предполагающем решение реальных проблем из репозиториев GitHub, — CWM достигла показателя успешного прохождения в 65,8%, превзогнув другие модели с открытыми весами аналогичного размера. Она также показала высокие результаты в LiveCodeBench (бенчмарке по спортивному программированию), Math-500 и AIME 2024 (математические рассуждения), а также в CruxEval (прогнозирование вывода кода на Python).
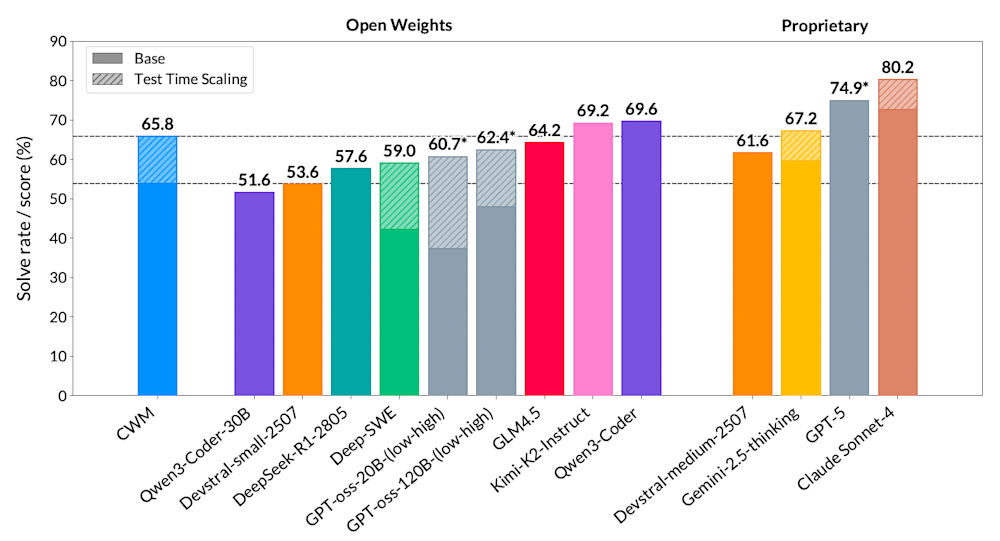
Производительность CWM на SWE-Bench (источник: arXiv)
Основываясь на этих результатах, исследователи считают, что модели мира «могут принести пользу агентному кодированию, обеспечить пошаговую симуляцию выполнения кода на Python и продемонстрировать первые результаты того, как рассуждения могут извлечь выгоду из последней возможности». Тем не менее они также подчеркивают ограничения модели. CWM выпускается как исследовательская модель по некоммерческой лицензии и не предназначена для использования в качестве универсального помощника или чат-бота. Несмотря на то что она получила некоторые данные для следования инструкциям, она не прошла обширную оптимизацию, необходимую для разговорного использования.
Выражая оптимизм по поводу будущего этого подхода, команда Meta отмечает, что «это лишь первые шаги в данном направлении». Они видят значительные перспективы для будущей работы, заявляя, что «надежные способы использования знаний модели мира для улучшения производительности в различных задачах с помощью промптинга или донастройки являются благодатной почвой для исследований».
Модели мира — залог интеллекта
Появление CWM происходит на фоне растущего интереса к наделению LLM чем-то большим, чем просто способностью предсказывать следующий токен. Рассуждения в стиле «цепочки мыслей» (Chain-of-Thought, CoT), являющиеся самым популярным подобным методом, заставляют модели записывать свои «мысли» перед выдачей окончательного ответа. Модели рассуждений, такие как DeepSeek-R1, используют обучение с подкреплением, чтобы заставить LLM генерировать более длинные цепочки CoT, в рамках которых они обдумывают свой ответ и корректируют его перед генерацией. Но CoT по-прежнему остается процессом генерации токенов, и существуют свидетельства и исследования, показывающие, что CoT представляет собой лишь иллюзию мышления и на него нельзя полагаться как на реальное доказательство рассуждений.
Модели мира — это более недавняя и продвинутая попытка решить эту проблему. Вместо того чтобы формулировать задачу как прогнозирование следующего токена, они стремятся заставить LLM разработать модель мира в своем латентном пространстве, которая необязательно представлена в выходных токенах. В другой недавней научной работе объединяются сильные стороны LLM и JEPA — архитектуры глубокого обучения, специально разработанной для моделирования мира. Первые результаты показывают, что LLM-JEPA более устойчива к изменениям окружающей среды и способна изучать новые задачи эффективнее, чем модели, обученные исключительно на прогнозировании следующего токена.
Пока еще рано говорить о том, насколько успешно исследователи смогут согласовать эти различные архитектуры ИИ. Но очевидным кажется то, что наличие надежной модели мира делает системы ИИ более устойчивыми и надежными в постоянно меняющейся среде реальных приложений.