Memento от UCL и Huawei повышает эффективность обучения больших языковых моделей (LLM)
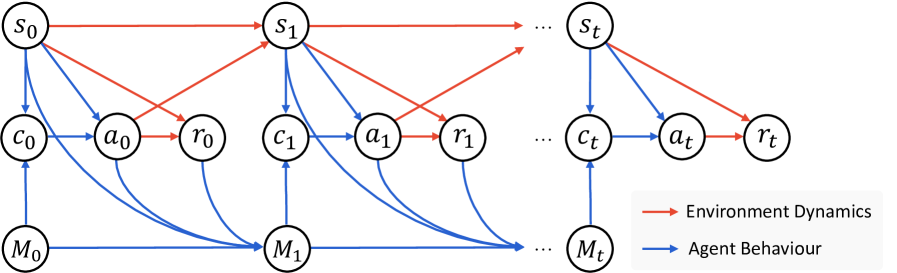


Новая парадигма обучения, разработанная Университетским колледжем Лондона (UCL) и Huawei Noah’s Ark Lab, позволяет агентам на базе больших языковых моделей (LLM) динамически адаптироваться к окружающей среде без тонкой настройки (fine-tuning) базовой языковой модели. Этот метод позволяет агентам непрерывно улучшать свою производительность с помощью структурированной системы памяти, которая обновляется по мере накопления агентом опыта.
Реализация этой парадигмы, которую исследователи называют Memento, заняла первые места в ключевых бенчмарках для глубоких исследований и комплексных задач многошагового рассуждения. Для предприятий это открывает масштабируемый и эффективный путь разработки универсальных агентов LLM, способных к непрерывному обучению в реальном времени без высоких затрат и простоев, связанных с традиционными методами обучения.
Ограничения современных агентов LLM
Современные агенты LLM обычно следуют одной из двух парадигм разработки, каждая из которых имеет существенные ограничения для корпоративных приложений. Первый подход предполагает создание специализированных фреймворков с фиксированными, жестко закодированными рабочими процессами. Хотя такие агенты эффективны для узких задач, они негибки и не могут адаптироваться к новым ситуациям или включать новую информацию после развертывания.
Вторая парадигма предполагает обновление самой LLM с помощью контролируемой тонкой настройки (supervised fine-tuning) или обучения с подкреплением. Это обеспечивает более гибкое поведение, но требует больших вычислительных затрат и обширных данных. По словам авторов статьи, «эти подходы неэффективны для непрерывной адаптации и онлайн-обучения, а также непрактичны для агентов, развертываемых в сценариях с открытым концом».
Цзюнь Ван (Jun Wang), профессор компьютерных наук в UCL и соавтор работы, утверждает, что проблема тонкой настройки выходит за рамки стоимости. Он отмечает, что изменение параметров модели может «поставить под угрозу знания, приобретенные во время предварительного обучения». Этот риск ухудшения ключевых возможностей модели является основным мотивом их работы.
Идеальный агент LLM должен уметь обновлять свое поведение при взаимодействии с окружающей средой, но без затрат на переобучение базовой модели.
Новая парадигма: обучение на основе памяти
Вдохновленные человеческой памятью, исследователи предлагают структуру обучения на основе памяти, которая обеспечивает непрерывную адаптацию без изменения LLM. Вместо того чтобы выполнять тонкую настройку базовой модели, агенты используют внешнюю память для хранения прошлого опыта. Сталкиваясь с новой задачей, агент опирается на аналогичные ситуации из прошлого, чтобы принимать решения.
Этот процесс основан на марковском процессе принятия решений (MDP) — классической структуре в ИИ для обучения агента принятию оптимальных решений. В стандартном MDP агент наблюдает текущее состояние окружающей среды, выбирает действие и получает вознаграждение или штраф. Его цель — изучить стратегию, которая максимизирует общую сумму вознаграждений с течением времени.
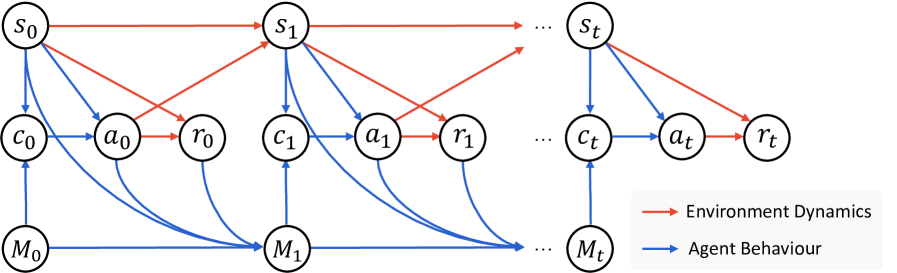
Марковский процесс принятия решений на основе памяти (M-MDP) (источник: arXiv)
Исследователи формализируют свой новый подход как марковский процесс принятия решений с дополненной памятью (M-MDP), который расширяет эту структуру, позволяя агенту учитывать не только свое текущее состояние и потенциальные действия, но и богатую память о прошлых событиях.
Агент использует метод, называемый прецедентным рассуждением (case-based reasoning, CBR), который извлекает и адаптирует решения на основе опыта решения предыдущих проблем. Например, исследовательский агент, успешно выполнивший задачу в Интернете, может использовать этот опыт для решения новой, структурно похожей задачи, с которой он никогда раньше не сталкивался. «Наш метод предлагает новый путь к непрерывному обучению для агентов глубоких исследований — эффективный, обобщаемый и вдохновленный тем, как учатся люди», — пишут исследователи.
Как работает Memento
Исследователи внедрили эту парадигму в агента под названием Memento, предназначенного для глубоких исследовательских задач, которые требуют от агентов взаимодействия с окружающей средой, использования внешних инструментов, извлечения информации и обработки разнообразных данных для динамического рассуждения.
«Мы призываем к новому подходу, который обеспечивает адаптируемость агентов без изменения параметров LLM, — рассказал Ван изданию VentureBeat. — Memento призван положить начало этой революции».
Система состоит из трех основных компонентов: планировщика и исполнителя с поддержкой инструментов, которые работают в циклическом режиме для выполнения задач, а также растущего «банка прецедентов», в котором хранится прошлый опыт.
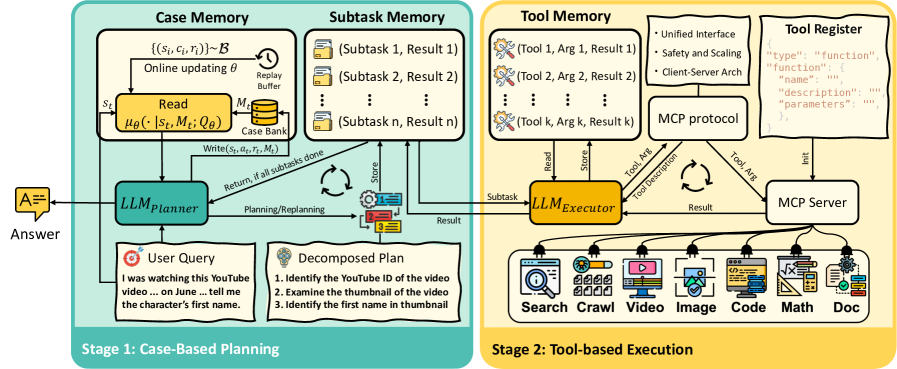
Архитектура Memento (источник: arXiv)
На этапе планирования планировщик (работающий на базе CBR-агента под управлением LLM) получает задачу и запрашивает в банке прецедентов соответствующий прошлый опыт. Извлеченные прецеденты объединяются с текущей инструкцией задачи для формирования промпта, который направляет базовую LLM на разбиение задачи на подзадачи и создание пошагового плана. Этот план передается исполнителю, которым управляет универсальная LLM.
По мере того как исполнитель прорабатывает каждую подзадачу, модуль «памяти подзадач» отслеживает прогресс и результаты. После каждого шага планировщик просматривает историю выполнения, чтобы оценить, завершена ли задача. Если нет, он переформулирует план на основе обновленного контекста. Как только задача выполнена, опыт сохраняется в банк прецедентов.
Исполнитель использует протокол контекста модели (Model Context Protocol, MCP) — стандартизированный интерфейс, который позволяет ему гибко подключаться к самым разнообразным внешним инструментам. Сюда входят поисковые системы, веб-краулеры и компоненты для обработки мультимедийной информации, такой как видео, изображения и различные форматы файлов.
Банк прецедентов динамичен и представлен в двух вариантах. Непараметрическая версия извлекает прецеденты на основе семантического сходства — метод, который Ван сравнивает с «коллективной фильтрацией или обучением на основе сходства, когда успешные примеры из прошлого подсказывают решения для текущих ситуаций».
Более продвинутая параметрическая версия использует обучение с подкреплением с легкой нейронной сетью для решения распространенной проблемы реального мира — разреженной обратной связи. Для задач, где сигналы об успехе или неудаче поступают редко, этот метод помогает обратной связи «распространяться по различным этапам», обеспечивая надежное обучение агента с течением времени. Ван называет это «непараметрическим подходом в более широком смысле», поскольку он предоставляет «дополнительное пространство для обучения агентов LLM без изменения базовых параметров LLM».
Memento в действии
В ходе экспериментов исследователи использовали GPT-4.1 в качестве основного планировщика, а другие модели, такие как o3 и o4-mini, задействовали для работы исполнителя. Memento продемонстрировала высокую производительность в нескольких сложных бенчмарках.
-
На датасете DeepResearcher, проверяющем веб-исследования в реальном времени и многошаговые рассуждения, Memento почти вдвое превзошла базовый показатель цепочки мыслей (CoT) с генерацией, дополненной поиском (RAG), достигнув оценки F1 в 66,6%.
-
В бенчмарке GAIA, оценивающем долгосрочное планирование и использование инструментов, Memento заняла первое место на валидационном наборе и четвертое — на тестовом, опередив большинство существующих открытых фреймворков для агентов.
-
В тесте Humanity’s Last Exam (HLE), проверяющем комплексные рассуждения в специализированных областях, Memento заняла второе место в общем зачете, показав результаты, близкие к GPT-5, и превзойдя такие модели, как Gemini 2.5 Pro.
-
В SimpleQA, созданном для измерения фактической точности и устойчивости к галлюцинациям, Memento достигла наивысшей точности среди всех базовых показателей.
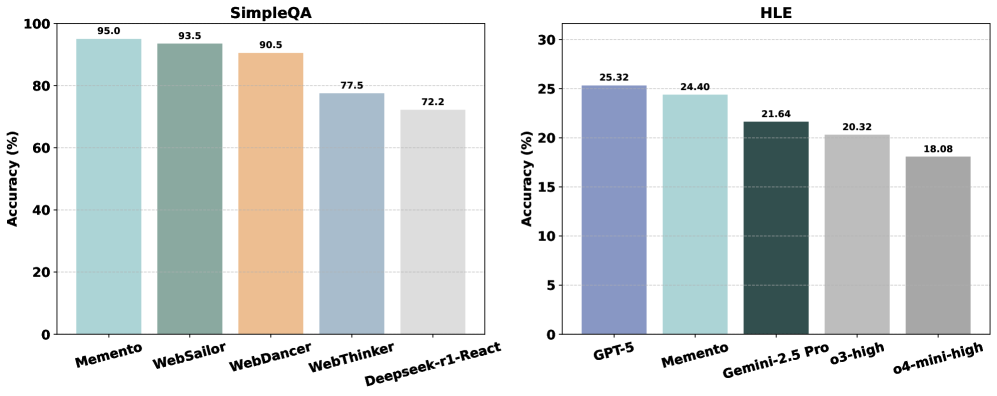
Производительность фреймворка Memento на ключевых бенчмарках (источник: arXiv)
Новая основа для обучения агентов
Хотя Memento использует форму поиска, Ван подчеркивает, что ее ключевая структура — M-MDP — представляет собой значительный шаг вперед по сравнению со стандартным RAG.
«В то время как подходы на основе поиска или RAG ограничивают обучение и обобщение, внедрение обучения с подкреплением позволяет параметризировать память, обеспечивая обобщение непосредственно из памяти», — поясняет он.
Это делает способность Memento к обучению «ортогональной исследованиям самой LLM». Другими словами, фреймворк не конкурирует с достижениями в области базовых моделей, а создан для их использования. По мере того как LLM становятся мощнее, агенты, построенные на базе M-MDP, станут еще более эффективными обучающимися системами. Этот подход также переопределяет то, как команды могут создавать и развертывать агентов, формируя то, что Ван называет «новой парадигмой промпт-инжиниринга и контекстного обучения», которая «сближает специалистов по машинному обучению и инженеров-программистов».
Для предприятий подход Memento имеет большое значение. Он устраняет необходимость в дорогостоящем и трудоемком переобучении LLM, позволяя агентам учиться на ходу. Эту парадигму можно интегрировать с существующими проприетарными или локальными открытыми моделями, а также подключать к заказным корпоративным инструментам и внутренним источникам данных с помощью гибкого протокола. Это позволяет создавать постоянно совершенствующиеся системы ИИ, которые одновременно экономичны и высоко адаптируемы к конкретным бизнес-потребностям.
Заглядывая в будущее, Ван определяет «сбор данных» как главное узкое место на пути создания по-настоящему автономных работников на базе ИИ. Агенты должны иметь возможность взаимодействовать с окружающей средой, чтобы получать обратную связь, необходимую для корректировки своего поведения. Следующим рубежом, по его мнению, является обеспечение «активного исследования» — способности агента самостоятельно исследовать окружающую среду, движимого необходимостью или даже любопытством. С появлением таких базовых фреймворков, как Memento, путь к подобным автономным системам становится более ясным.