Фреймворк LIMI обучает большие языковые модели всего на 78 примерах


Новое исследование, проведенное Шанхайским университетом Цзяо Тун и Исследовательской лабораторией генеративного ИИ SII (GAIR), показывает, что для обучения больших языковых моделей (LLM) сложным автономным задачам не требуются огромные массивы данных.
Их фреймворк LIMI (Less Is More for Intelligent Agency) опирается на аналогичные работы в других областях исследований LLM и приходит к выводу, что «автономия машин возникает не из обилия данных, а из стратегического отбора высококачественных демонстраций агентного поведения».
Иными словами, значение имеет качество данных, а не их количество.
В ходе экспериментов исследователи обнаружили, что, используя небольшой, но тщательно отобранный набор данных, состоящий всего из 78 примеров, они смогли обучить LLM превзойти модели, обученные на тысячах примеров, с существенным отрывом по ключевым отраслевым бенчмаркам.
Это открытие может иметь важное значение для корпоративных приложений, где данные в дефиците или их сбор обходится дорого.
Проблема создания работающих агентов
Исследователи определяют агентность как «эмерджентную способность систем ИИ функционировать в качестве автономных агентов — активно обнаруживать проблемы, формулировать гипотезы и выполнять решения посредством целенаправленного взаимодействия со средой и инструментами». Другими словами, это системы ИИ, которые «не просто думают, а работают».
Проблема заключается в том, что существующие структуры обучения предполагают, что более высокий уровень агентного интеллекта требует больших объемов данных, как это было показано в классических законах масштабирования для языкового моделирования. Исследователи утверждают, что такой подход приводит к усложнению пайплайнов обучения и значительным ресурсным затратам. Кроме того, во многих областях данные не отличаются обилием, их трудно получить, а их отбор стоит очень дорого.
Тем не менее, исследования в других областях показывают, что для достижения целей при обучении LLM вовсе не обязательно требуется больше данных.
Например, в работе LIMA 2023 года было показано, что модель можно эффективно настроить всего с помощью 1000 отобранных примеров. Совсем недавно в исследовании LIMO было продемонстрировано, что сложные математические рассуждения могут возникать на основе всего 817 обучающих примеров.
Создавая LIMI, исследователи стремились применить тот же принцип «меньше значит больше» к сложному миру агентов ИИ.
Как работает LIMI
Фреймворк LIMI демонстрирует, что сложный агентный интеллект может возникать на основе минимальных, но стратегически отобранных демонстраций автономного поведения. Ключевым элементом фреймворка является пайплайн для сбора высококачественных демонстраций агентных задач.
Каждая демонстрация состоит из двух частей: запроса и траектории. Запрос — это запрос пользователя на естественном языке, например требование по разработке программного обеспечения или цель научных исследований.
Траектория — это последовательность шагов, которые предпринимает ИИ для выполнения запроса, включая его внутренние рассуждения, вызовы внешних инструментов (таких как интерпретатор кода) и наблюдения, получаемые из окружающей среды. Например, запросом может быть «создать простое приложение для чата», а траектория будет включать внутренние рассуждения агента и план действий, код, который он пишет и выполняет, а также полученный результат или ошибки.
Траектория может включать в себя множество итераций планирования, выполнения и осмысления до тех пор, пока не будет достигнута желаемая цель.
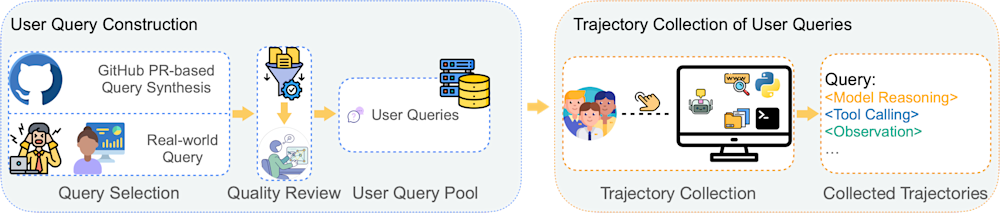
Пайплайн генерации данных LIMI (источник: arXiv)
Чтобы сформировать свой набор данных, исследователи начали с 60 запросов из реальных сценариев, с которыми сталкиваются профессиональные разработчики и исследователи. Затем они расширили этот пул, используя GPT-5 для синтеза дополнительных запросов на основе пулл-реквестов GitHub.
Они задействовали команду из четырех аспирантов в области компьютерных наук для проверки качества этих запросов и отбора 18 примеров, чтобы создать качественный набор из 78 запросов, ориентированных на разработку программного обеспечения и исследовательские рабочие процессы.
Для генерации траекторий те же аспиранты сотрудничали с CLI-агентом кодирования на базе GPT-5 для выполнения этих 78 задач.
Они следовали итеративному процессу, собирая всю последовательность взаимодействий до тех пор, пока каждая задача не была успешно завершена, и фиксируя всю полноту реалистичного сотрудничества человека и ИИ, включая двустороннюю коммуникацию и итеративную доработку. Для более сложных запросов собранные траектории могли превышать 152 000 токенов.
«Этот подход гарантирует, что наши модели учатся не только на успешных результатах, но и на всем процессе решения проблем, включая то, как адаптировать стратегии и справляться с неудачами во время совместного выполнения», — пишут исследователи.
LIMI в действии
Чтобы протестировать свой фреймворк, команда оценила модели на AgencyBench — бенчмарке, предназначенном для измерения агентных навыков, а также на других устоявшихся бенчмарках для использования инструментов и кодирования.
Они дообучили GLM-4.5, мощную модель с открытым исходным кодом, используя свой набор данных из 78 примеров, и сравнили ее производительность с несколькими передовыми моделями, включая базовую GLM-4.5, Kimi-K2-Instruct и DeepSeek-V3.1. Модель, обученная с помощью LIMI, показала средний результат 73,5% на AgencyBench, значительно опередив все базовые модели, лучшая из которых (GLM-4.5) набрала 45,1%.
Это превосходство распространилось и на другие бенчмарки, охватывающие использование инструментов, написание кода и научные вычисления, где LIMI также превзошла все базовые показатели.
Что еще важнее, исследование показало, что модель, обученная всего на 78 примерах, превзошла модели, обученные на 10 000 примеров из другого набора данных, обеспечив превосходящую производительность при использовании в 128 раз меньшего объема данных.
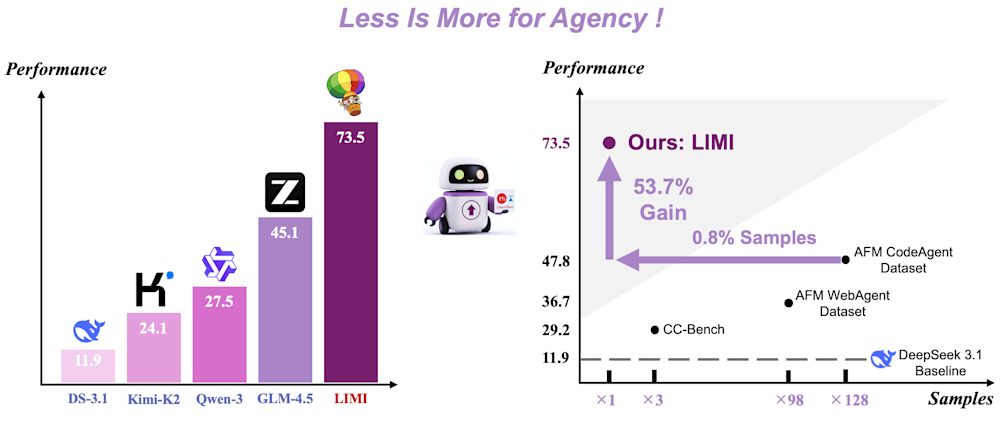
Модели LIMI достигают высокой агентной производительности при использовании лишь небольшой части примеров обучения, требуемых для других фреймворков (источник: arXiv)
«Это открытие в корне меняет подход к разработке автономных систем ИИ, предполагая, что овладение агентностью требует понимания ее сущности, а не масштабирования обучающих данных», — пишут исследователи. «По мере того как отрасли переходят от думающего ИИ к работающему ИИ, LIMI предоставляет парадигму для устойчивого выращивания по-настоящему агентного интеллекта».
Исследователи опубликовали код для синтеза данных и обучения, а также веса модели. Для корпоративного сектора этот подход предлагает практический путь к разработке высокоспециализированных агентов ИИ.
Вместо реализации масштабных проектов по сбору данных организации могут задействовать свои собственные кадры и профильных экспертов для создания небольших высококачественных наборов данных под конкретные агентские задачи. Это снижает порог входа и позволяет компаниям создавать кастомные ИИ-агенты, которые могут обеспечить конкурентное преимущество в наиболее важных для них рабочих процессах.