WebExplorer устанавливает новый стандарт для веб-агентов


Исследователи из Гонконгского университета науки и технологии, компании MiniMax и Университета Ватерлоо представили новый фреймворк для создания более умных и эффективных агентов для поиска и просмотра веб-страниц. Этот фреймворк, получивший название WebExplorer, использует систематический подход для автоматической генерации обучающих данных, исключая необходимость в дорогостоящей ручной разметке и делая примеры достаточно сложными для обучения высокопроизводительных ИИ-агентов, способных решать долгосрочные задачи.
WebExplorer-8B, модель, обученная с использованием этого метода, демонстрирует лучшие в своем классе результаты для своего размера на ключевых отраслевых бенчмарках. Она демонстрирует сложные навыки использования инструментов, что делает ее отлично подходящей для задач рассуждения и исследования, требующих сбора и обработки информации из нескольких онлайн-источников. Такой подход открывает предприятиям практический путь для разработки мощных веб-агентов долгосрочного действия под заказные приложения.
Узкое место качества данных для веб-агентов
Большие языковые модели (LLM) все чаще используются в качестве агентов, способных автономно бороздить просторы интернета в поисках информации. Однако разработка таких агентов сталкивается со значительным препятствием. Существующие модели с открытым исходным кодом зачастую с трудом справляются со сложными многоэтапными поисковыми задачами, в то время как методы обучения более мощных коммерческих моделей от таких компаний, как OpenAI и Google, остаются закрытыми.
Исследователи, создавшие WebExplorer, выдвинули гипотезу, что основная сложность заключается в качестве обучающих данных. Современные бенчмарки включают в себя настолько сложные вопросы, что даже люди-асессоры с трудом на них отвечают. В научной работе утверждается, что «создание высококачественных и сложных пар «запрос-ответ» имеет решающее значение для разработки агентов, способных достигать сверхчеловеческой производительности в задачах поиска информации».
Создание таких высококачественных данных — серьезная проблема. Большинство сложных бенчмарков опираются на ручную кураторскую обработку, что происходит медленно, стоит дорого и приводит к наборам данных, которые слишком малы для обучения крупномасштабных моделей. Это создало острую необходимость в методах, способных автономно синтезировать большие объемы сложных пар «запрос-ответ». Однако существующие автоматизированные подходы имеют собственные ограничения. Графовые методы, которые картируют веб-сайты и их связи, сложны в проектировании и обслуживании. В то же время эволюционные методы, которые итеративно усложняют простые вопросы, могут приводить к неестественным или запутанным запросам.
Как WebExplorer генерирует сложные данные
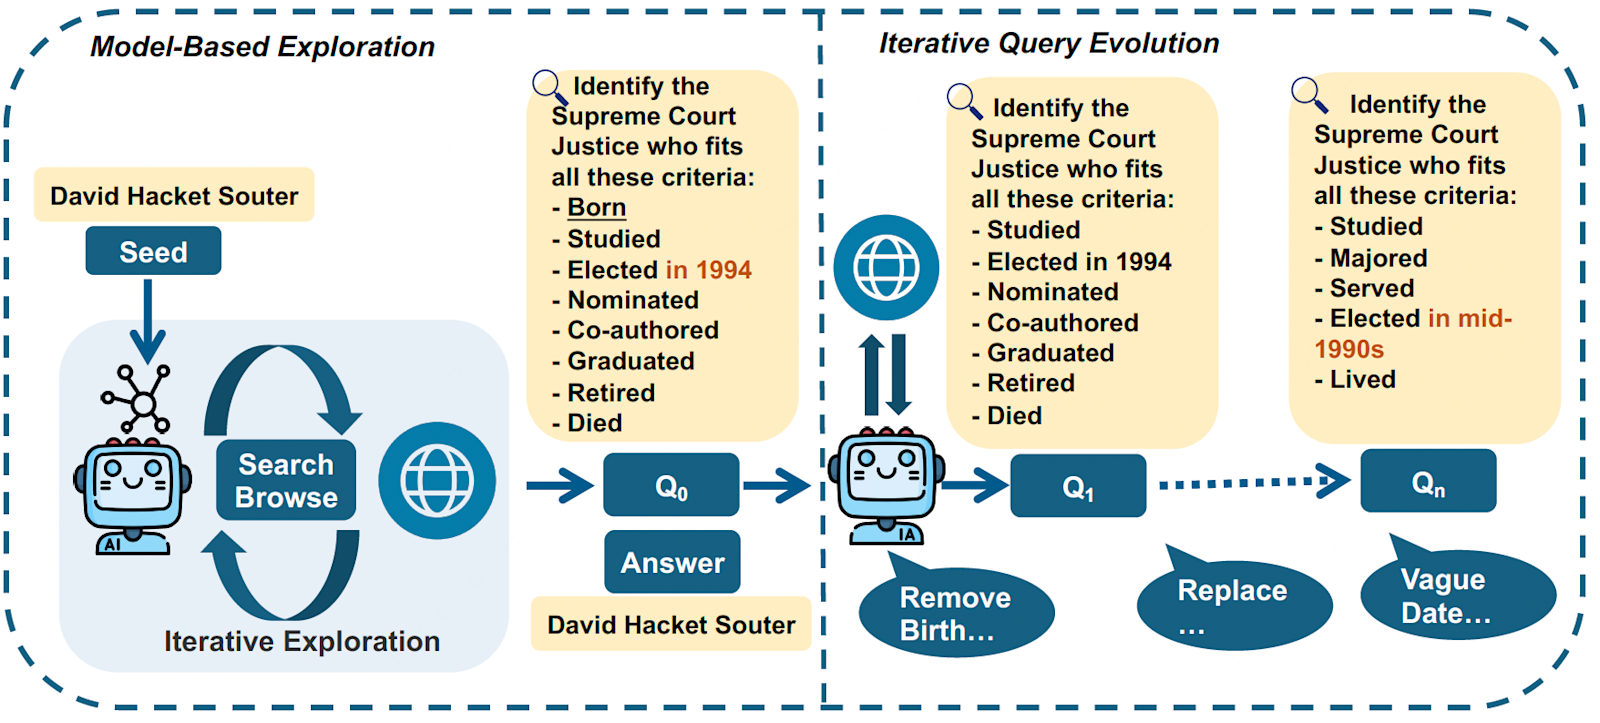
Фреймворк WebExplorer предлагает более простой и эффективный способ создания обучающих данных с помощью двухэтапного процесса: модель-ориентированное исследование и итеративная эволюция запросов.
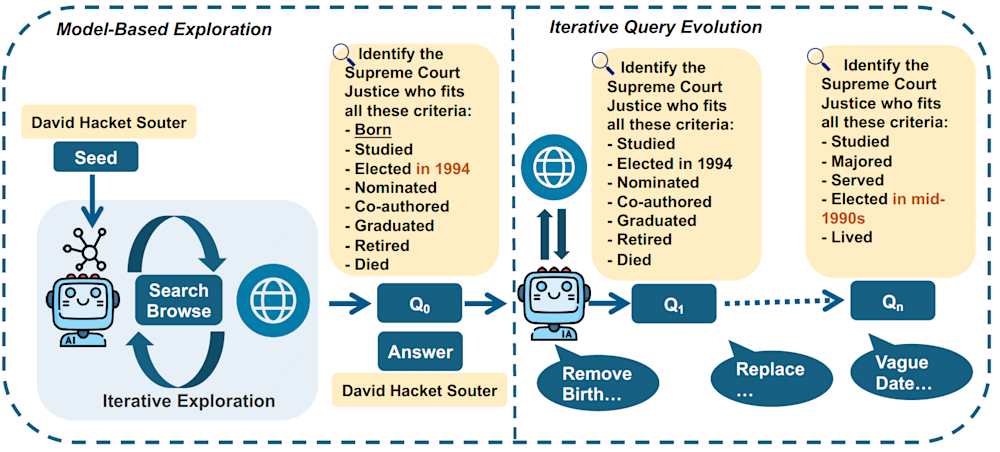
Фреймворк WebExplorer (источник: GitHub)
Во-первых, вместо построения жесткой и явной карты интернета фреймворк использует более гибкий подход. Он дает мощной языковой модели «исходную» тему (например, «Сборная Бразилии по футболу») и поручает ей выполнить серию поисковых и просмотровых действий. Модель исследует пространство свободно, обнаруживая взаимосвязанные факты на разных веб-сайтах. Этот процесс внутренне имитирует создание графа знаний без сложной избыточности в виде предопределенных правил. Сформировав богатый контекст, модель создает первоначальную пару «вопрос-ответ» на основе найденной информации.
На втором этапе фреймворк усложняет эти первоначальные вопросы. Исследователи заметили, что вопросы первого прохода, хотя и требуют информации с нескольких сайтов, все еще оставались слишком простыми, поскольку содержали очевидные подсказки вроде конкретных дат, имен или мест. Вдохновленный дизайном сложных бенчмарков, таких как BrowseComp, фреймворк запускает процесс «эволюции», который систематически удаляет эти заметные подсказки и заменяет явные детали туманными описаниями. Эта эволюция по принципу «от длинного к короткому», которая сокращает объем информации, а не добавляет ее, заставляет агента вырабатывать более глубокие навыки логического мышления и поисковых исследований.
Исследователи использовали этот метод для создания набора данных WebExplorer-QA, который содержит около 40 000 сложных пар «вопрос-ответ». Эти данные предназначены для обучения агентов, способных справляться с двусмысленностью и выполнять многоэтапные рассуждения, необходимые для решения сложных реальных задач.
Затем фреймворк использует эти данные в рамках двухфазного рецепта обучения. Сначала обучение с учителем (SFT) обеспечивает «холодный старт», обучая модель фундаментальным навыкам использования инструментов поиска и просмотра, а также декомпозиции сложных вопросов на более мелкие шаги. За этим следует этап обучения с подкреплением (RL), на котором модели предоставляется больше свободы для самостоятельного изучения различных путей решения. Фаза RL дополнительно совершенствует ее способности к рассуждению и обработке долгих многоэтапных задач, в конечном итоге формируя более продвинутые навыки решения проблем с поддержкой контекстов объемом до 128 000 токенов.
WebExplorer в действии
Чтобы протестировать свой фреймворк, исследователи использовали данные WebExplorer-QA и рецепт обучения для донастройки модели с открытым исходным кодом Qwen3-8B. Затем они оценили полученную модель, WebExplorer-8B, в сравнении с набором проприетарных и открытых моделей на нескольких бенчмарках по поиску информации, включая BrowseComp, GAIA и WebWalkerQA.
Результаты показывают, что WebExplorer-8B демонстрирует поразительную эффективность. Модель установила новый стандарт производительности для своего размера и стабильно превосходила гораздо более крупные модели с открытым исходным кодом. На сложных бенчмарках BrowseComp она обошла WebSailor-72B — модель почти в десять раз больше ее по размеру. Модель также продемонстрировала высокую степень генерализации, успешно справившись со сложным бенчмарком Humanity’s Last Exam (HLE), несмотря на то, что ее обучающие данные не были сосредоточены на вопросах из области STEM.
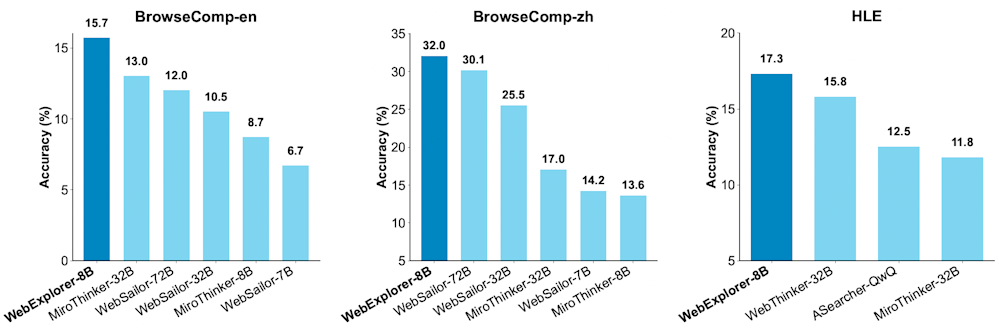
Производительность WebExplorer-8B на ключевых бенчмарках веб-поиска и просмотров (источник: GitHub)
Полученные результаты могут иметь практическое значение для реальных приложений. Фреймворк WebExplorer предоставляет рецепт создания специализированных высокопроизводительных веб-агентов без непомерных затрат на ручную разметку данных. Возможность обучать более мелкие и эффективные модели, способные превосходить более крупные, является главным преимуществом для практического развертывания, поскольку снижает как вычислительные затраты, так и задержку инференса. Такие модели могут быть кастомизированы для взаимодействия с внутренними базами знаний, проведения сложного анализа рынка или автоматизации глубоких исследовательских задач.
Как заключают авторы в научной статье: «Успех WebExplorer демонстрирует потенциал автономного синтеза сложных пар «вопрос-ответ» для поиска информации и применения обучения с учителем и с подкреплением для создания передовых веб-агентов долгосрочного действия».