Agentic CPT от Alibaba повышает эффективность обучения LLM
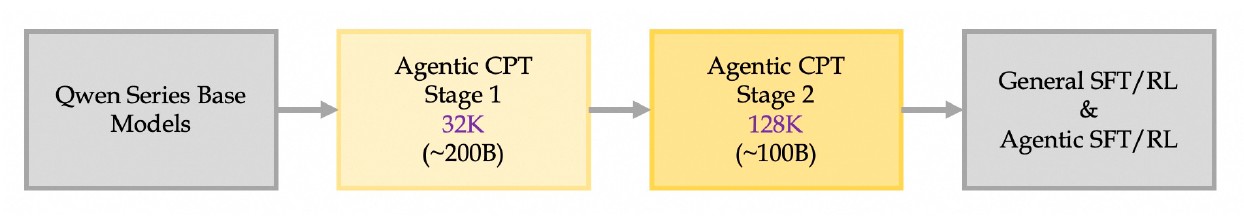


Лаборатория Tongyi компании Alibaba представила новый обучающий фреймворк с открытым исходным кодом, который позволяет обучать открытые большие языковые модели (LLM) для конкуренции с ведущими коммерческими моделями для глубоких исследований. Эта методика, получившая название Agentic Continual Pre-training (агентное непрерывное предварительное обучение, или Agentic CPT), использует инновационный фреймворк синтеза данных и конвейер обучения для расширения возможностей LLM по освоению сложного многошагового поведения.
AgentFounder, глубокий исследовательский агент, обученный с помощью этого фреймворка, устанавливает новый рекорд производительности в ключевых отраслевых бенчмарках, демонстрируя мощный и рентабельный путь для предприятий по разработке собственных агентов на базе LLM для решения сложных исследовательских задач.
Проблема агентного выравнивания
По мере того как языковые модели эволюционируют от простых чат-ботов до автономных агентов, определение выравнивания ИИ требует фундаментального расширения. Согласования вывода модели с предпочтениями человека за один шаг уже недостаточно. Авторы статьи утверждают, что для того чтобы агент был надежным, он должен достичь «агентного выравнивания» (agentic alignment). Это требует от него поддержания поведения, согласующегося с действиями экспертов-людей при решении сложных проблем в динамических средах — например, при вызове нужных инструментов и адаптации к непредсказуемым изменениям вроде сбоев инструментов или вводящей в заблуждение информации.
По словам авторов статьи, «языковые модели, достигающие такого выравнивания для веб-поиска и задач, требующих больших объемов знаний, могут считаться глубокими исследовательскими агентами», способными автономно организовывать рабочие процессы посредством поиска, просмотра веб-страниц и выполнения кода для предоставления достоверных ответов.
Однако существующие методы пост-обучения LLM, такие как контролируемая доводка (SFT) и обучение с подкреплением (RL), оказались недостаточными для этой задачи, особенно для моделей с открытым исходным кодом. Эти модели часто демонстрируют большие пробелы в производительности по сравнению с проприетарными системами, такими как Deep Research от OpenAI, поскольку они построены на базе универсальных базовых моделей.
Исследователи подчеркивают, что ни SFT, ни RL не предоставляют сигналов обучения, необходимых для того, чтобы исследовательские агенты могли ориентироваться в огромных и сложных пространствах принятия решений. Вместо этого они запирают модели в рамках воспроизведения конкретного поведения, а не развития гибких навыков принятия решений. «В основе своей универсальные базовые модели лишены агентных индуктивных смещений, что заставляет этап пост-обучения одновременно изучать возможности и выравнивание, порождая внутренние оптимизационные конфликты, — говорится в статье. — Крайне важно, что пути создания самих агентных базовых моделей до сих пор остаются во многом неизученными».
Агентное непрерывное предварительное обучение (Agentic CPT)
Чтобы решить эту проблему, команда Alibaba переопределила конвейер обучения, представив Agentic CPT в качестве промежуточного этапа для выравнивания. Основная цель заключается в создании «предварительно выровненной» базовой модели, которая уже обладает сильным агентным поведением до прохождения финальной доводки.
В основе этого подхода лежат два принципа:
-
Исходные источники данных должны быть широкими и не ограничиваться одним доменом.
-
Данные для обучения должны включать всестороннее разнообразие агентного поведения, предотвращая простое запоминание паттернов моделью и вместо этого стимулируя ее к изучению различных стратегий решения проблем.
Этот подход принципиально отличается от других фреймворков с открытым исходным кодом. «Другие глубокие исследовательские агенты, такие как WebSailor, лишь осуществляют пост-обучение модели на небольшом объеме траекторий, — рассказал в интервью VentureBeat Синьюй Ван, исследователь из Alibaba и соавтор статьи. — Agentic CPT добавляет перед ними новый этап, который вводит масштабный массив агентных данных для повышения эффективности решения агентных задач». Результатом становится мощная «агентная базовая модель», которую можно адаптировать под различные методы пост-обучения.
В корпоративной среде такая надежность имеет решающее значение, поскольку непредсказуемое поведение ИИ представляет собой серьезный риск. На вопрос о том, как Agentic CPT приводит к созданию более предсказуемых агентов, Ван пояснил, что этот метод улучшает способности агента к планированию и самокоррекции. Вместо того чтобы устранять неопределенность, фреймворк обучает агента управлять ею.
«Чтобы сбалансировать исследование с надежностью, мы усиливаем перекрестную проверку и выбор путей у агента, чтобы он мог самостоятельно корректировать свои действия в условиях неопределенности, — отметил Ван. — Например, если целевая страница недоступна, агент перенаправляет запросы на альтернативные каналы… Когда источник вызывает сомнения, он проактивно ищет независимого подтверждения. Если доказательств недостаточно, он откладывает выводы или помечает их соответствующим образом, вместо того чтобы делать преждевременные суждения». Такая встроенная устойчивость означает, что агент с меньшей вероятностью будет «галлюцинировать» ошибочный план или застревать, когда внутренняя база данных временно отключается.
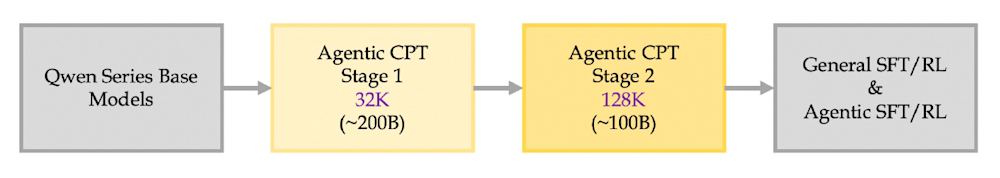
Обучающий фреймворк для Agentic CPT (источник: arXiv)
Используя этот фреймворк, исследователи обучили AgentFounder — глубокого исследовательского агента на базе открытой базовой модели Qwen3-30B. Его конвейер обучения добавляет дополнительный набор шагов между стандартными фазами предварительного обучения и пост-обучения, которые обычно проходят LLM. Этот новый этап делится на две части. На этапе 1 модель обрабатывает примерно 200 миллиардов токенов агентных данных и текста для рассуждений о знаниях, используя окно контекста на 32 тыс. токенов. На этапе 2 эти возможности уточняются с использованием дополнительных 100 миллиардов токенов высококачественных агентных данных, а также расширенного до 128 тыс. токенов контекстного окна, чтобы научить модель понимать сложные пространства действий и осваивать стратегии долгосрочного планирования.
Генерация данных без вызовов API
Краеугольным камнем фреймворка Agentic CPT является масштабируемый подход к синтезу данных, который обучает мощные модели без избыточных затрат, связанных с коммерческими вызовами API или данными, аннотированными вручную. Процесс состоит из двух основных компонентов: синтеза действий первого порядка (First-order Action Synthesis, FAS) и синтеза действий высшего порядка (Higher-order Action Synthesis, HAS).
FAS разработан для создания разнообразного набора обучающих данных, охватывающего широкий спектр сценариев — от поиска фактов до многошаговых рассуждений. Он преобразует необработанные данные из различных источников в структурированную «память открытого мира», а затем генерирует сложные пары вопросов и ответов.
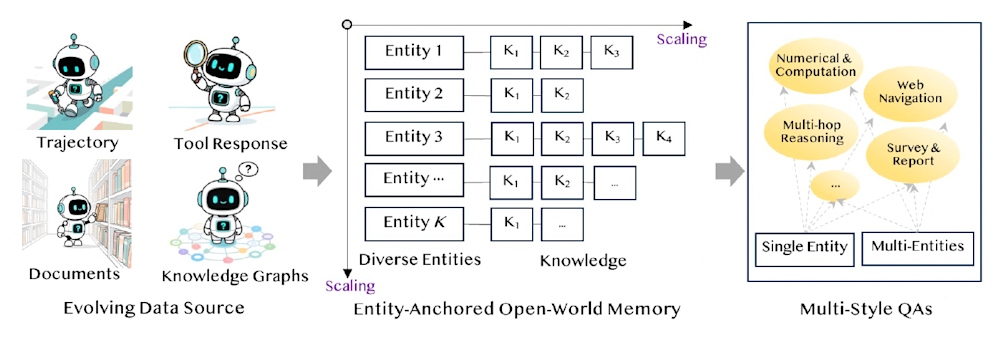
Конвейер генерации данных для Agentic CPT (источник: arXiv)
HAS дополняет этот процесс, позволяя системе более эффективно использовать сгенерированные данные. Вместо обучения модели на одной «правильной» траектории, HAS генерирует несколько альтернативных путей рассуждения для каждой проблемы. Этот процесс учит модель гибкому принятию решений, а не простому копированию, позволяя ей исследовать более широкий спектр потенциальных решений.
Важно отметить, что оба этих метода синтеза работают полностью автономно (офлайн), обеспечивая крупномасштабную генерацию данных без затрат на API.
AgentFounder в действии
При тестировании в сравнении с множеством общих LLM, коммерческих агентов и других глубоких исследовательских агентов с открытым исходным кодом AgentFounder-30B продемонстрировал результаты современного уровня (state-of-the-art). В целом он превзошел всех существующих конкурентов с открытым исходным кодом по четырем основным бенчмаркам веб-поиска. На английском бенчмарке BrowseComp AgentFounder-30B опередил предыдущую лучшую модель с открытым исходным кодом, DeepSeek-V3.1, на 10 процентных пунктов, приблизившись по производительности к закрытым моделям от OpenAI. В статье отмечается: «Это значительное улучшение демонстрирует, что AgentFounder-30B эффективно освоил сложные стратегии поиска и возможности рассуждения».
AgentFounder-30B также продемонстрировал впечатляющую производительность в специализированных задачах. На крайне сложном бенчмарке Humanity’s Last Exam (HLE) она стала первой моделью с открытым исходным кодом, преодолевшей порог в 30 баллов. Она также набрала 75,3% в Academic Browse, существенно опередив все остальные модели и доказав свою ценность в качестве академического ассистента.
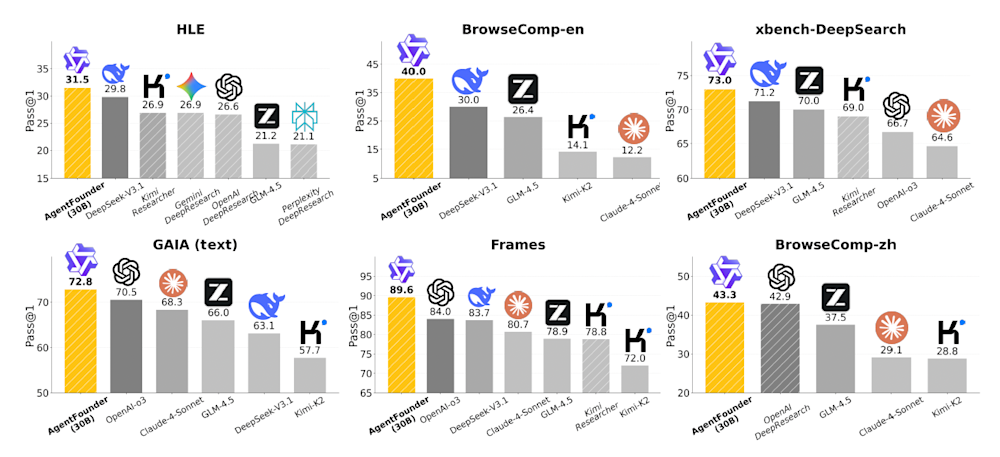
AgentFounder-30B превосходит глубоких исследовательских агентов с открытым исходным кодом в ключевых отраслевых бенчмарках (источник: arXiv)
Для бизнес-лидера превосходная производительность означает осязаемую пользу. Ван отмечает, что высокие баллы в этих бенчмарках указывают на то, что агент работает «более стабильно, точно и эффективно в реальных, долгосрочных задачах, требующих интенсивного использования инструментов и знаний». На практике это означает более быстрый доступ к надежным исследовательским отчетам для таких задач, как конкурентный анализ рынка или мониторинг цепочек поставок, которые зависят от «агрегации данных из нескольких источников, перекрестной проверки сигналов и быстрого обновления знаний», пояснил Ван. Тем не менее, для критически важных приложений он рекомендует использовать схему с участием человека в контуре управления рисками — «с проверкой и одобрением человеком в ключевых точках принятия решений».
Для предприятий AgentFounder-30B демонстрирует практический путь к созданию передовых глубоких исследовательских агентов, которые можно развертывать локально (on-premise), обеспечивая повышенный уровень контроля и безопасности. Более того, фреймворк Agentic CPT меняет подход к разработке кастомного ИИ. Конвейер обучения может быть адаптирован под внутренние инструменты организации и проприетарные источники данных, позволяя создавать высокоспециализированные агенты ИИ.
По словам Вана, такой подход делает создание специализированных агентов гораздо более быстрым и доступным процессом. «Имея сильную предварительно выровненную агентную базовую модель, предприятия могут проводить легкую адаптацию, используя свои внутренние корпусы документов и проприетарные инструменты, чтобы быстро создавать доменные агенты — например, для финансового анализа или фармацевтических исследований, — заявил он. — Такой подход приемлем как по стоимости, так и по срокам для большинства компаний». В перспективе это может означать, что по мере того, как агентные возможности станут нативными для базовых моделей, многие сложные задачи можно будет решать с помощью одного лишь простого промпт-инжиниринга.