Google DeepMind раскрывает ограничения векторных вложений


Векторные вложения (эмбеддинги) представляют собой основу современного корпоративного ИИ, обеспечивая работу всего — от генерации с дополненной выборкой (RAG) до семантического поиска. Однако новое исследование Google DeepMind выявляет фундаментальное математическое ограничение этой технологии, из-за которого сложные системы ИИ могут давать сбои самым неожиданным образом.
Эту проблему невозможно решить с помощью увеличения моделей или расширения обучающих данных. Исследование показывает, что по мере усложнения задач поиска и извлечения данных стандартный подход с использованием одного векторного эмбеддинга упрётся в непреодолимый потолок и окажется неспособен отразить все возможные способы релевантности документов запросу.
Главный вывод для лидеров в сфере ИИ-продуктов заключается в том, что «поиск на основе эмбеддингов — это не панацея», как заявили авторы в интервью VentureBeat. Понимание этого ограничения имеет решающее значение для создания нового поколения надежных и отказоустойчивых систем ИИ.
Растущая нагрузка на векторные эмбеддинги
По своей сути векторные эмбеддинги — это способ преобразования неструктурированных данных, таких как текст, изображения или аудио, в числовые представления (векторы) в пространстве высокой размерности. Это позволяет моделям ИИ понимать семантические связи между различными фрагментами данных. При «плотном извлечении» (dense retrieval), используемом в большинстве систем RAG, запрос также преобразуется в вектор, а система находит наиболее релевантные документы, определяя векторные представления документов, которые находятся ближе всего к вектору запроса в этом пространстве.
В последнее время распространение поиска, следующего инструкциям (instruction-following retrieval), вывело эту технологию за рамки простого сопоставления ключевых слов. Ключевым критерием сложности, по словам авторов, является «степень, в которой запросам может потребоваться извлекать произвольные подмножества документов». Этот сбой может происходить даже с невероятно простыми документами и запросами (например, документы вроде «Алиса любит яблоки, бананы, …», «Боб любит футбол, виноград, …» и запросы вроде «Кто любит яблоки?»). Такие задачи заставляют модель связывать документы на основе абстрактных отношений, резко увеличивая количество возможных «релевантных» наборов документов, которые модель должна уметь представлять.
В предыдущих исследованиях уже указывались ограничения векторных эмбеддингов, однако преобладало мнение, что эти проблемы вызваны нереалистичными или некорректно составленными запросами. В новой работе утверждается, что это ограничение заложено в самой архитектуре. Исследователи пишут: «Вместо того чтобы предлагать эмпирические бенчмарки для оценки возможностей моделей эмбеддингов, мы стремимся понять на более фундаментальном уровне, в чем заключаются их ограничения».
Поиск точки излома в идеальном мире
Чтобы доказать этот теоретический предел, исследователи разработали идеальный эксперимент, представляющий собой наилучшую производительность, которую теоретически может показать любая модель эмбеддингов. Они полностью обошлись без языковых моделей и напрямую оптимизировали числовые векторы для решения задачи поиска. Такая установка, названная ими «свободной оптимизацией эмбеддингов» (free embedding optimization), устраняет любые ограничения, налагаемые естественным языком, и изолирует геометрическую емкость векторного пространства.
Даже в этом идеальном сценарии они обнаружили четкую точку излома. Для любой заданной размерности эмбеддинга (количества значений в каждом векторе) существует «критическая точка», в которой количество документов в системе становится слишком большим, чтобы представить все возможные комбинации релевантных результатов. Размерность эмбеддинга оказывается просто слишком мала для кодирования такой сложности.
Авторы статьи экстраполируют это открытие на масштабы Интернета, делая вывод о том, что «для поиска масштаба веб-сайтов даже самые большие размерности эмбеддингов при идеальной оптимизации на тестовом наборе недостаточны для моделирования всех комбинаций». Это означает, что даже в идеальных условиях лежащая в основе подхода с одним вектором математика имеет встроенный потолок.
Простой тест ломает ведущие современные модели
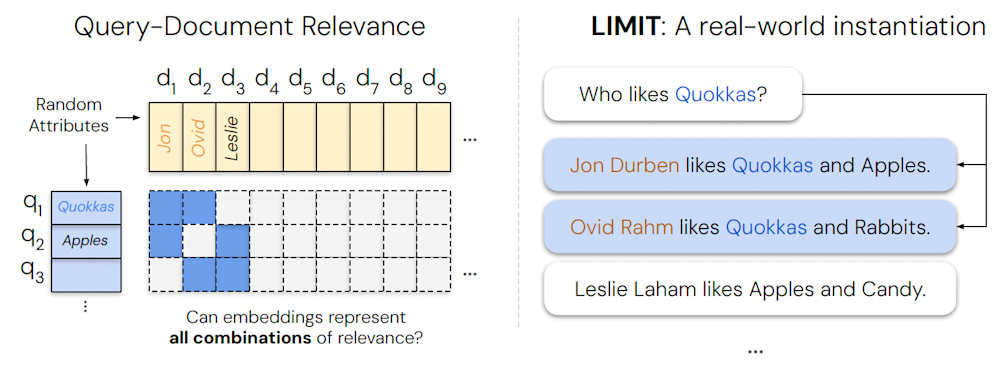
Структура датасета LIMIT (источник: arXiv)
Существующие отраслевые бенчмарки часто не выявляют эту уязвимость. В статье отмечается, что датасет вроде QUEST, содержащий 325 000 документов, имеет более чем 7.1e+91 (71 с 90 нулями) возможных комбинаций из 20 релевантных документов. Тем не менее, его 3 000 запросов тестируют лишь бесконечно малую часть этого пространства.
Чтобы продемонстрировать проблему в реальных условиях, исследователи создали новый датасет под названием LIMIT. Задача обманчиво проста. Запросы понятны («Кто любит яблоки?»), а документы содержат четкие ответы. Однако датасет специально сконструирован так, чтобы подвергнуть стресс-тестированию способность модели справляться с большим количеством пересекающихся комбинаций релевантности, когда один документ может быть релевантен множеству разных запросов.
Результаты оказались суровыми. Передовые модели эмбеддингов от Google, Snowflake и других испытывают серьезные трудности на датасете LIMIT, причем некоторые из них показывают полноту (recall — доля найденных моделью правильных документов) менее 20% при выполнении всей задачи. К всеобщему удивлению, BM25, алгоритм лексического поиска десятилетней давности, демонстрирует исключительно высокие результаты на той же задаче.
Что особенно важно, когда исследователи провели тонкую настройку (fine-tuning) модели на тренировочной версии LIMIT, ее производительность практически не улучшилась. Это указывает на то, что проблема заключается не в «сдвиге домена» (когда модель терпит неудачу, потому что ранее не сталкивалась с похожими данными), а в фундаментальном архитектурном ограничении. Модели принципиально не обладают емкостью для решения этой задачи.
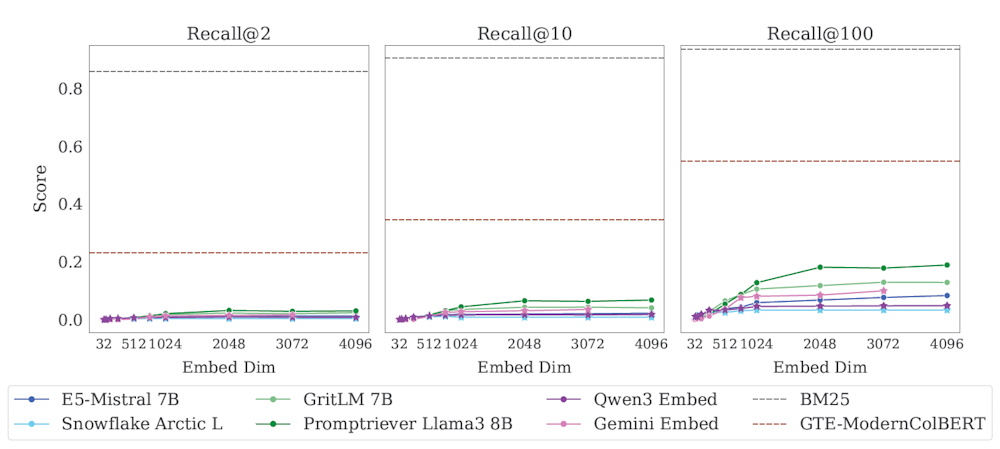
Модели эмбеддингов показывают низкие результаты на LIMIT, в то время как классический алгоритм BM25 (пунктирная серая линия) демонстрирует высокую производительность (источник: arXiv)
Что это значит для корпоративного ИИ
Главный вывод заключается в том, что по мере того, как приложения искусственного интеллекта требуют все более сложных рассуждений, опора исключительно на одновекторные эмбеддинги может привести к плато производительности. Модели могут оказаться просто неспособными извлечь правильный набор документов, независимо от того, насколько хорошо они обучены. Вот как руководители и разработчики могут на это отреагировать.
1. Выявите тревожные признаки в собственных приложениях
По словам исследователей, проблема становится очевидной, когда определение «релевантности» приобретает комбинаторный характер. «Ранним предупреждающим знаком в ваших собственных приложениях является ситуация, когда запросы, логически требующие для полноценного ответа нескольких документов (например, с использованием терминов вроде „сравнить“, „и“ или „оба“), начинают давать сбой», — пояснили они. «Если ваша система стабильно извлекает только один из релевантных документов вместо требуемого набора, это явный показатель того, что вы упираетесь в выявленные нами геометрические ограничения». Вы также можете сделать вывод об этих лимитах на основе самих данных. Например, если ваши «документы» — это пулл-реквесты, а ваши «запросы» — это диффы (diffs), весьма вероятно, что для любых двух пулл-реквестов найдется дифф, по отношению к которому они оба релевантны. В таком сценарии одновекторные эмбеддинги будут испытывать трудности.
2. Создайте более устойчивую систему: гибридный подход
Для практикующих разработчиков самое практичное руководство — создание гибридных поисковых архитектур. Авторы рекомендуют объединять сильные стороны различных методов:
-
Используйте плотные эмбеддинги (dense embeddings) из-за их мощного семантического понимания и способности находить концептуально связанные документы даже при отсутствии пересечений по ключевым словам.
-
Полагайтесь на разреженные методы (sparse methods), такие как BM25, из-за их точности и комбинаторной надежности, гарантирующих выполнение всех заданных в запросе ограничений.
«Их сочетание обеспечивает гораздо более отказоустойчивую и надежную систему», — отметили авторы в своих комментариях, добавив при этом, что для более простых приложений, где обычно существует единственный лучший документ, чистая модель эмбеддингов может подойти идеально.
3. Переосмыслите стратегию оценки
Убедительный тезис исследования заключается в том, что академические таблицы лидеров (leaderboards) могут вводить в заблуждение, поскольку они тестируют лишь малую часть возможных запросов. «Опора исключительно на показатели в таблицах лидеров может заставить компании внедрять инструменты, которые отлично выглядят на бенчмарках, но оказываются хрупкими на практике», — предупреждают авторы.
Их совет — выйти за рамки стандартных тестов и создать внутренние оценки, отражающие комбинаторную природу реальных запросов. Вместо проверки релевантности только одного документа они предлагают командам «проактивно проектировать тестовые сценарии, требующие извлечения определенных наборов документов». Например, команда может синтетически генерировать запросы, требующие извлечения из своего массива конкретных пар или триплетов документов, что даст гораздо более точное представление о реальных возможностях модели.
Будущее информационного поиска
В статье предполагается, что предприятиям следует изучить более выразительные архитектуры, такие как кросс-энкодеры (модели, которые совместно обрабатывают запрос и документы), многовекторные модели (модели, изучающие несколько различных эмбеддингов для улавливания дополнительных нюансов), а также вернуться к разреженным моделям вроде BM25.
Хотя эти методы могут помочь решить проблемы, представленные в датасете LIMIT, исследователи считают, что это не обязательно конец парадигмы единого вектора. «Один из тонких, но важных выводов нашей работы заключается в том, что одиночные векторы теоретически невероятно мощны — гораздо сильнее, чем демонстрируют текущие модели», — рассказали исследователи VentureBeat. «Геометрическая емкость присутствует, но на практике мы еще не смогли обучить модели, которые используют ее полностью. В конечном счете наша работа — это призыв к действию для исследовательского сообщества. Она подчеркивает, что мы были излишне предвзяты к популярным бенчмаркам вроде MTEB, и указывает на острую необходимость более строгой оценки и постоянных инноваций в базовых принципах поиска на основе эмбеддингов».