Parallel-R1 от Tencent AI Lab повышает возможности рассуждения языковых моделей (LLM)
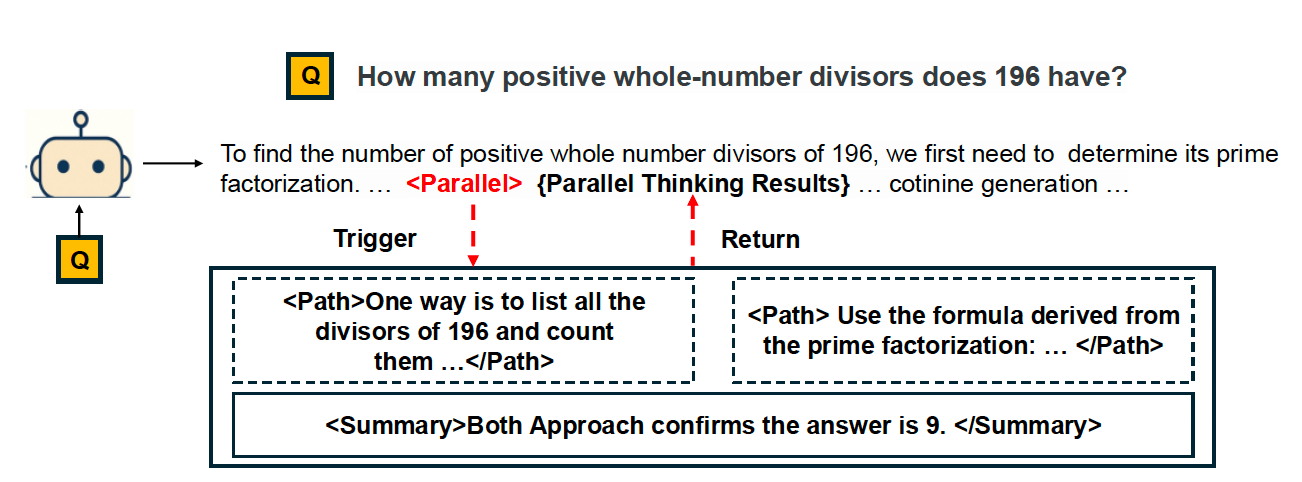


В новой научной работе исследователи из Tencent AI Lab Seattle и Мэрилендского университета в Колледж-Парке представляют метод обучения с подкреплением, который позволяет большим языковым моделям (LLM) эффективнее использовать масштабирование на этапе инференса для решения сложных задач на логику.
Этот метод, получивший название Parallel-R1, использует специальный конвейер генерации данных и многоэтапный процесс обучения для внедрения «параллельного мышления» в LLM. Это позволяет им разветвляться на несколько различных путей рассуждения при генерации ответов, что в конечном итоге приводит к более надежным и точным выводам.
Параллельное мышление, которое в настоящее время используется в некоторых закрытых передовых моделях, обещает раскрыть больший потенциал рассуждений существующих моделей за счет эффективного масштабирования во время использования, без необходимости в дорогостоящих данных обучения с ручной разметкой.
Проблемы параллельного мышления
Идея одновременного изучения нескольких линий рассуждения доказала свою высокую ценность: недавно Google объяснила успех своей модели Gemini Deep Think на Международной математической олимпиаде отчасти именно этой способностью.
Ранние стратегии искусственного интеллекта по имитации такого поведения предполагали методы грубой силы, когда модель с самого начала генерирует несколько независимых ответов и выбирает наиболее согласованный из них, что часто называют «лучшим из N». Более изощренные методы, такие как поиск по дереву Монте-Карло и Tree of Thoughts, обеспечивают более детальный контроль над процессом рассуждения и голосования, но они часто зависят от созданных вручную правил и внешних систем, направляющих ход мысли.
Более поздние усилия были направлены на то, чтобы обучать модели этому навыку напрямую в процессе тренировки. Однако эти методы сталкиваются со значительными препятствиями. Обучение модели с помощью контролируемой доводки (SFT), когда она учится на предварительно написанных примерах, полностью зависит от качества этих данных. Высококачественные данные, демонстрирующие процессы параллельного мышления для сложных реальных задач, чрезвычайно редки и их трудно создать. Это часто заставляет модель просто имитировать паттерны в обучающих данных, а не приобретать глубокий, универсальный навык параллельного мышления.
Обучение с подкреплением (RL), при котором модель учится методом проб и ошибок, предлагает более масштабируемый путь. Но оно сопряжено со своими собственными трудностями. LLM не предварительно обучены мыслить параллельно, поэтому они не создают естественным образом те исследовательские пути рассуждений, на которых им нужно учиться (классическая «проблема холодного старта»). Кроме того, разработка правильной системы вознаграждения — сложная задача. Если модель получает вознаграждение только за правильный финальный ответ, она может научиться срезать углы и отказаться от более сложной стратегии параллельного мышления. И наоборот, если ее заставлять мыслить параллельно, она может делать это в ситуациях, когда это не нужно, ухудшая эффективность и производительность.
Как работает Parallel-R1
Фреймворк Parallel-R1 создан для преодоления этих трудностей. Исследователи называют его «первым фреймворком обучения с подкреплением (RL), который обеспечивает поведение параллельного мышления для сложных реальных задач на рассуждение».
«Ключевое понимание нашего подхода заключается в том, чтобы обойти необходимость в сложных конвейерах данных, которые часто считаются необходимыми для генерации обучающих данных по конечным сложным задачам», — пишут исследователи.
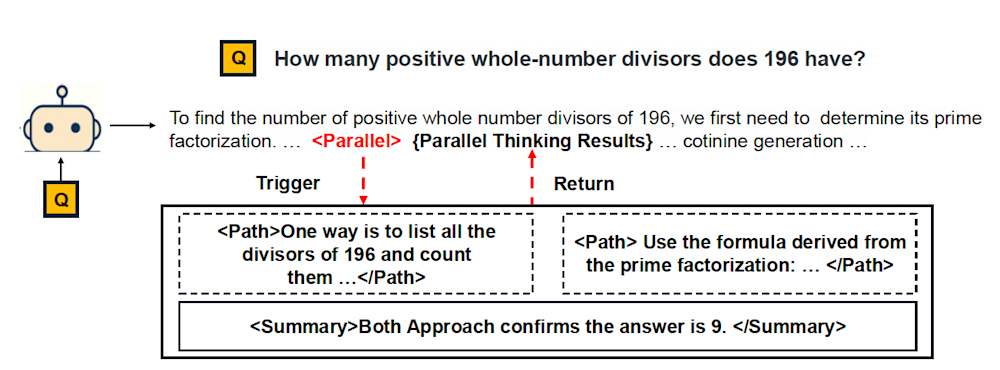
Parallel-R1 (источник: arXiv)
По своей сути этот подход разделяет параллельное мышление на два этапа: «Исследование» (Exploration), на котором модель запускает несколько независимых потоков рассуждений при обнаружении критического шага, и «Сводка» (Summary), на которой она объединяет результаты этих потоков для формирования выводов перед возобновлением основной линии мысли. На этапе инференса модель генерирует текст до тех пор, пока не появится специальный тег
Чтобы привить эту способность, исследователи разработали трехэтапный рецепт обучения. Первый — это «Этап холодного старта» (Cold-Start Stage), на котором модель дорабатывается на пользовательском наборе данных из созданных ИИ примеров параллельного мышления. Этот начальный шаг обучает модель базовому формату параллельных рассуждений. Затем на этапе «RL на простых математических задачах» (RL on Easy Math) фреймворк применяет обучение с подкреплением к тому же набору данных для стабилизации этого нового поведения, используя систему двойного вознаграждения, которая стимулирует как правильность, так и правильное использование параллельной структуры. Наконец, на этапе «RL на общих математических задачах» (RL on General Math) модель обучается на новых и более сложных математических задачах, чтобы распространить навык параллельного мышления на более сложные сценарии.
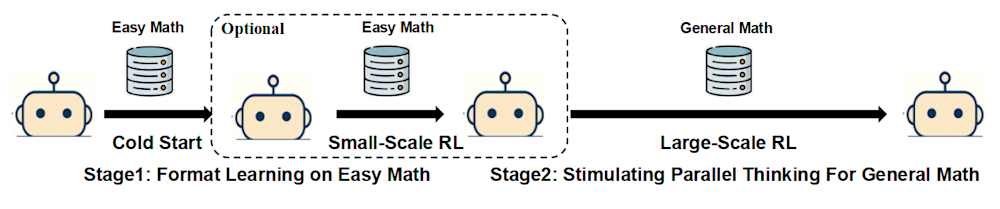
Конвейер обучения Parallel-R1 (источник: arXiv)
Ключевая инновация заключается в том, как создаются исходные данные для «холодного старта». Вместо использования сложных конвейеров данных команда обнаружила, что мощная LLM может генерировать высококачественные примеры параллельных рассуждений для простых задач с помощью простых промптов. В своих экспериментах исследователи использовали дистиллированную версию DeepSeek-R1 для генерации около 7 000 примеров параллельного мышления на основе набора данных по математическим задачам GSM8K. Что важно, они сделали «стратегический выбор использовать эти данные «холодного старта» не для того, чтобы научить модель решать конечные целевые задачи, а конкретно для того, чтобы обучить ее формату параллельного мышления».
Другой важной частью фреймворка является функция вознаграждения. Чтобы решить проблему разработки вознаграждений, команда разработала альтернативную стратегию вознаграждения, которая переключается между поощрением модели за точность окончательного ответа и за правильное использование структуры параллельного мышления. Согласно статье, «этот подход обеспечивает превосходный баланс между высокой производительностью и последовательным использованием параллельного мышления по сравнению с использованием только одного типа вознаграждения».
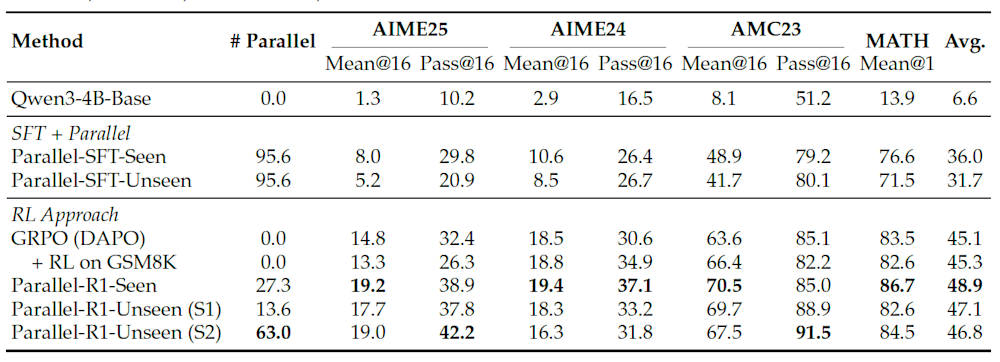
Parallel-R1 демонстрирует значительное улучшение на ключевых бенчмарках рассуждений (источник: arXiv)
Исследователи протестировали свой фреймворк, обучив модель с открытым исходным кодом Qwen-3-4B-Base на базе Parallel-R1 и оценив ее на четырех стандартных бенчмарках математических рассуждений, включая AIME, AMC и MATH. Результаты показывают, что модель, обученная с помощью Parallel-R1, стабильно превосходила базовые показатели, в том числе модель, обученную с использованием стандартного подхода RL.
Для реальных приложений Parallel-R1 предоставляет решение для извлечения большей мощности рассуждений из существующих систем искусственного интеллекта. Этот метод масштабирования возможностей во время инференса, а не просто увеличения размера модели, обеспечивает более эффективный и практичный подход к развертыванию продвинутого ИИ для логических задач в реальных корпоративных приложениях.