Delethink от Mila снижает расходы на языковые модели на две трети
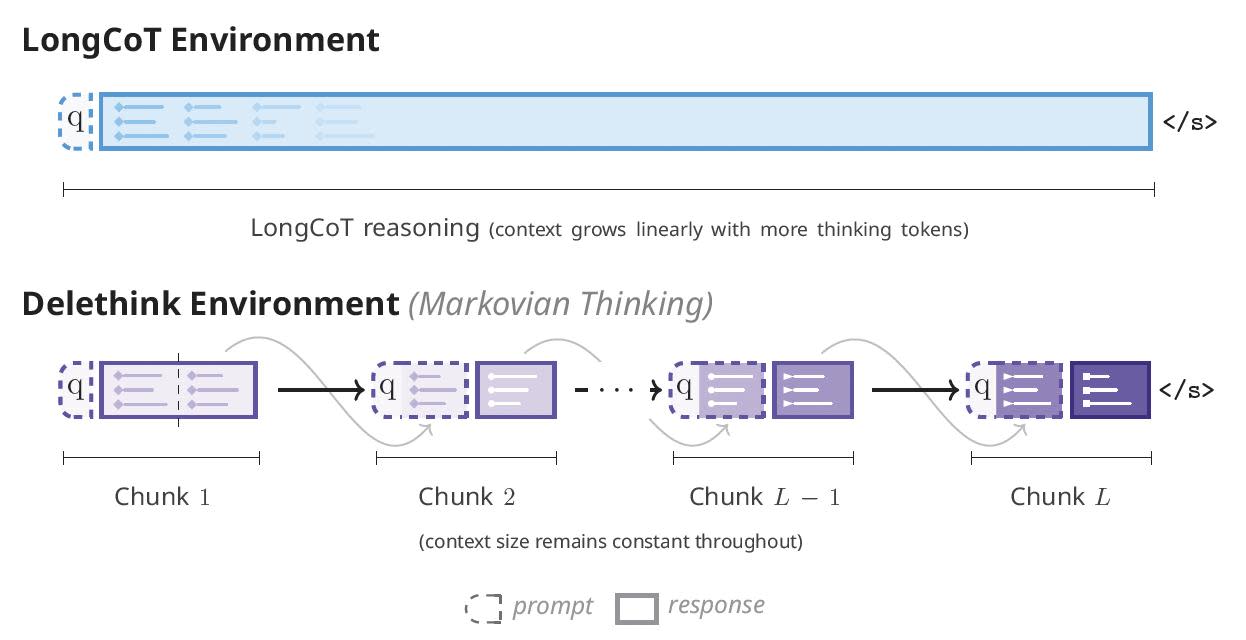


Исследователи из института Mila предложили новую технику, которая делает большие языковые модели (LLM) значительно более эффективными при выполнении сложных задач на рассуждение. Под названием Markovian Thinking («Марковское мышление») этот подход позволяет LLM вести длительные рассуждения без непомерных вычислительных затрат, которые в настоящее время ограничивают подобные задачи.
Реализация исследователей, получившая название Delethink, структурирует цепочку рассуждений на блоки фиксированного размера, решая проблему масштабирования, которая мешает очень длинным ответам LLM. Первоначальные оценки показывают, что для модели с 1,5 млрд параметров этот метод может сократить затраты на обучение более чем на две трети по сравнению со стандартными подходами.
Квадратичное проклятие длинных цепочек рассуждений
Чтобы LLM решила сложную проблему, ей часто требуется генерировать длинную серию промежуточных «мыслительных» токенов, часто называемую цепочкой рассуждений (Chain-of-Thought, CoT). В последние годы исследователи выяснили, что использование обучения с подкреплением (RL) для тренировки моделей на создание более длинных CoT (иногда называемых LongCoT) значительно улучшило их способность к логическим выводам.
Тем не менее, стандартный метод имеет критический недостаток: «состояние» ИИ (промпт плюс все токены рассуждений, сгенерированные к данному моменту обработки) увеличивается с каждым новым токеном рассуждения. Для современных моделей на базе трансформеров это означает, что вычислительные затраты растут по квадратичному закону по мере удлинения цепочки рассуждений, что делает обучение моделей для очень сложных задач непомерно дорогим.
Большинство текущих попыток справиться с этими затратами сводятся к ограничению объема мыслительного процесса модели, неявно отдавая предпочтение более коротким решениям или досрочному завершению процесса. Хотя эти методы приносят некоторое облегчение, исследователи из Mila по-прежнему работают в рамках концепции LongCoT и, следовательно, принципиально ограничены ее квадратичной природой.
Вместо того чтобы пытаться контролировать рост вычислительных затрат, специалисты Mila создали среду обучения с подкреплением, которая полностью обходит квадратичную проблему. Как пояснил соавтор работы Амирхоссейн Каземнежад (Amirhossein Kazemnejad), цель состоит в том, чтобы сделать возможными такие сценарии, как многонедельные рассуждения и научные открытия. «Этот режим (и обучение с подкреплением, необходимое для реализации таких возможностей) не поддерживается текущей парадигмой LongCoT из-за квадратичной стоимости вычислений», — отметил он.
Мышление блоками с помощью Delethink
Решением исследователей стала парадигма под названием «Марковская мыслящая модель» (Markovian Thinker), в которой модель рассуждает, сохраняя постоянным размер своего контекстного окна для размышлений. Основная идея заключается в изменении настройки обучения с подкреплением так, чтобы отделить «продолжительность размышлений модели» от «объема контекста, который ей необходимо обработать». Если все сделать правильно, марковская модель превращает проблему квадратичного роста в линейные вычисления и фиксированные требования к памяти для рассуждений LLM.
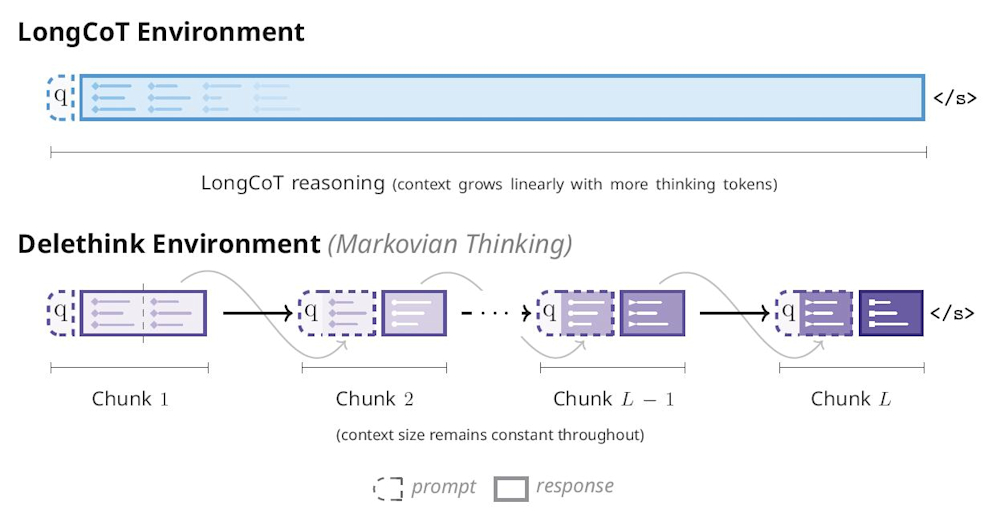
Как работает Delethink по сравнению с LongCoT (источник: arXiv)
Исследователи воплотили эту парадигму на практике с помощью Delethink, заставляя модель рассуждать последовательностью блоков фиксированного размера, например по 8000 токенов за раз. Внутри каждого блока модель рассуждает привычным образом, используя классический механизм внимания. Но при достижении лимита блока среда сбрасывает контекст, создавая новый промпт, который включает исходный запрос и короткий «перенос» (carryover) из предыдущего блока. Например, перенос может состоять из последних нескольких токенов предыдущего блока CoT или резюме наиболее важных результатов.
Такая перегруппировка задачи заставляет модель научиться внедрять резюме своего прогресса или «текстовое марковское состояние» в этот перенос, чтобы продолжить рассуждения в следующем блоке. Это решает распространенное опасение по поводу того, сможет ли модель запомнить важные детали с предыдущих этапов.
По словам Каземнежада, модель учится тому, что именно следует запоминать. «Благодаря обучению… модель вынуждена учиться переносить критически важное для задачи состояние», — пояснил он. Он также добавил важное уточнение для практического использования: исходный входной промпт не изменяется, включая добавленные к нему документы или контекстные данные. «Наш подход нацелен на фазу рассуждений и не модифицирует промпт», — сказал он.
Delethink в действии
Чтобы протестировать свой подход, исследователи обучили R1-Distill-1.5B с помощью Delethink на датасете математических задач конкурсного уровня, а затем оценили ее по нескольким бенчмаркам. Модель была натренирована рассуждать в течение до 24 000 токенов, но с фиксированными блоками по 8000 токенов.
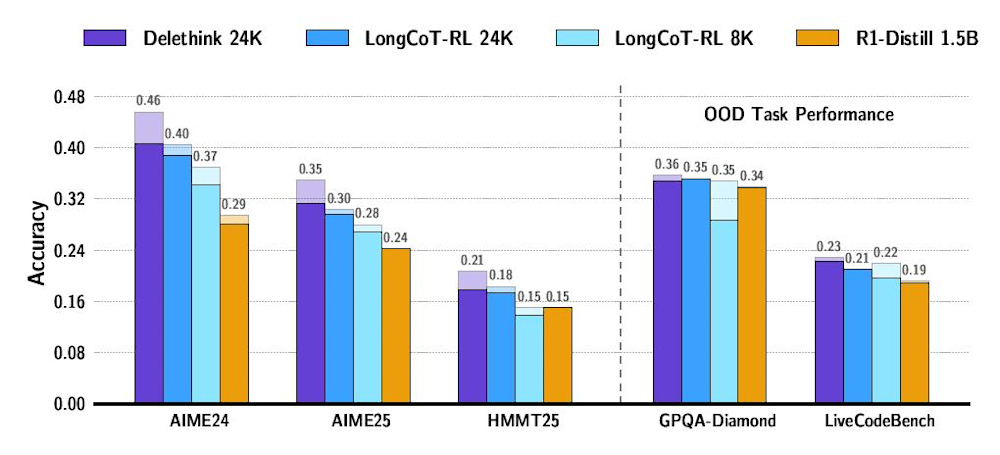
Производительность Delethink на различных отраслевых бенчмарках (затененные области представляют собой расширенный бюджет на размышления) (источник: arXiv)
Исследователи сравнили этот результат с моделями, обученными стандартным методом LongCoT-RL. Полученные ими данные показывают, что модель, обученная с помощью Delethink, могла рассуждать в объеме до 24 000 токенов и не уступала или превосходила модель LongCoT, обученную с тем же бюджетом в 24 000 токенов на математических тестах. В других задачах, таких как программирование и вопросы уровня PhD, Delethink также продемонстрировала результаты на уровне аналога LongCoT или слегка превзошла его. «В целом эти результаты показывают, что Delethink использует свои токены мышления так же эффективно, как LongCoT-RL, но с меньшими вычислительными затратами», — пишут исследователи.
Преимущества становятся еще более очевидными при масштабировании за пределы бюджета обучения. В то время как модели, обученные с использованием LongCoT, быстро достигали плато на своих тренировочных лимитах, модель, обученная по методу Delethink, продолжала улучшать производительность. Например, некоторые математические задачи удавалось решить только после того, как модель рассуждала в течение 140 000 токенов — далеко за пределами своего бюджета обучения в 24 000 токенов. Это преимущество в линейных вычислениях имеет колоссальное значение для корпоративных приложений. По оценкам исследователей, обучение модели со средней длиной размышлений 96 000 токенов потребовало бы 27 месяцев работы графических процессоров H100 при использовании LongCoT против всего 7 месяцев с Delethink.
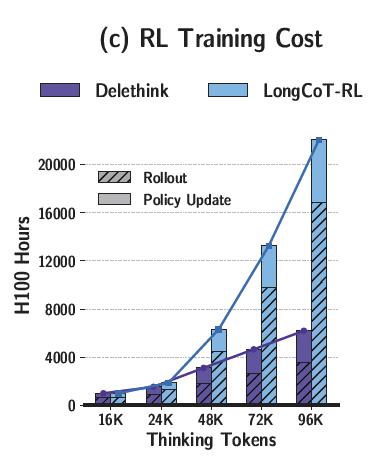
Затраты на обучение Delethink в сравнении с LongCoT (источник: arXiv)
Эта эффективность напрямую распространяется и на инференс, который является основной статьей операционных расходов для большинства предприятий. «Модели, обученные с применением марковского мышления, используют тот же стиль инференса (трассировку delethink) во время тестирования, что обеспечивает те же преимущества линейных вычислений и постоянного объема памяти после обучения», — отметил Каземнежад. Он привел практический пример: ИИ-агент может «отлаживать большую кодовую базу и долго думать… что, конечно, значительно снижает затраты по сравнению с традиционным подходом LongCoT».
Интересно, что исследователи обнаружили: готовые модели рассуждений даже без специального обучения уже демонстрируют некоторую способность мыслить марковским способом. Это открытие имеет немедленные практические последствия для разработчиков. «На практике это означает, что — даже без Delethink-RL — эти модели уже могут запускать оболочку трассировки delethink и конкурировать с LongCoT в задачах из наших бенчмарков», — заявил Каземнежад.
Эксперименты с более крупными моделями, такими как GPT-OSS 120B, продемонстрировали высокую производительность при использовании Delethink в самых разных сложных задачах. Эта скрытая способность служит отличной отправной точкой для обучения с подкреплением, помогая объяснить, почему метод столь эффективен. «В совокупности эти результаты свидетельствуют о том, что Delethink совместима с передовыми моделями и хорошо масштабируется вместе с ними», — заключают исследователи.
Успех «марковского мышления» показывает, что для «моделей рассуждений нового поколения может стать возможным думать на протяжении миллионов токенов», отмечают ученые. Это открывает дверь к принципиально новым возможностям искусственного интеллекта, выходящим за рамки текущих ограничений.
«Марковское мышление… прокладывает путь к моделям, способным «мыслить» на очень больших горизонтах, что мы рассматриваем как необходимый шаг к будущим научным открытиям», — подчеркнул Каземнежад. «Наш подход устраняет ключевое узкое место и позволяет проводить обучение для задач с гораздо более длительным горизонтом планирования, открывая возможности нового поколения».