


MobileLLM-R1 от Meta переосмысливает размер моделей ИИ


Мощность ИИ-моделей долгое время соотносилась с их размером: модели разрастались до сотен миллиардов и триллионов параметров. Однако столь масштабные модели создают для бизнеса очевидные проблемы, включая отсутствие контроля над базовой системой, зависимость от сторонних облачных сервисов и непредсказуемость затрат.
Сегодня набирает обороты противоположная тенденция — миниатюрные языковые модели (SLM), предназначенные для локальной работы на ПК и смартфонах. Последним и самым ярким примером стала модель MobileLLM-R1 от Meta — семейство моделей с числом параметров менее миллиарда, обеспечивающих специализированные возможности логического вывода (рассуждений). Ее выпуск стал частью масштабной тенденции в индустрии по разработке компактных и мощных моделей, бросающих вызов концепции «больше — значит лучше».
MobileLLM-R1 от Meta: специалист по рассуждениям для работы на устройствах
Модель Meta MobileLLM-R1 представляет собой семейство моделей для логических рассуждений с количеством параметров 140M, 360M и 950M. Они созданы специально для решения математических, программных и научных задач (эти модели не подходят для общего общения в чате).
Эффективность моделей достигается за счет конструктивных решений, которые Meta описала в оригинальных моделях MobileLLM, оптимизированных специально под архитектуры с числом параметров менее одного миллиарда. Например, в них используется «глубокая и тонкая» архитектура (предпочтение отдается большему количеству слоев, а не увеличенной размерности эмбеддингов), а также проверенные методы, такие как механизм внимания с группировкой запросов (grouped-query attention — метод совместного использования весов внимания для сокращения числа параметров модели). Такой подход в сочетании с исключительно эффективным процессом обучения позволяет моделям справляться со сложными задачами на устройствах с ограниченными ресурсами.
Модели прошли обучение на массиве данных общим объемом около 5 триллионов токенов (для сравнения, другие модели сопоставимого размера обучаются на десятках триллионов токенов), включая дистиллированные данные от Llama-3.1-8B-Instruct, что позволило эффективно перенести ее продвинутые возможности рассуждения без колоссальных затрат на обучение.
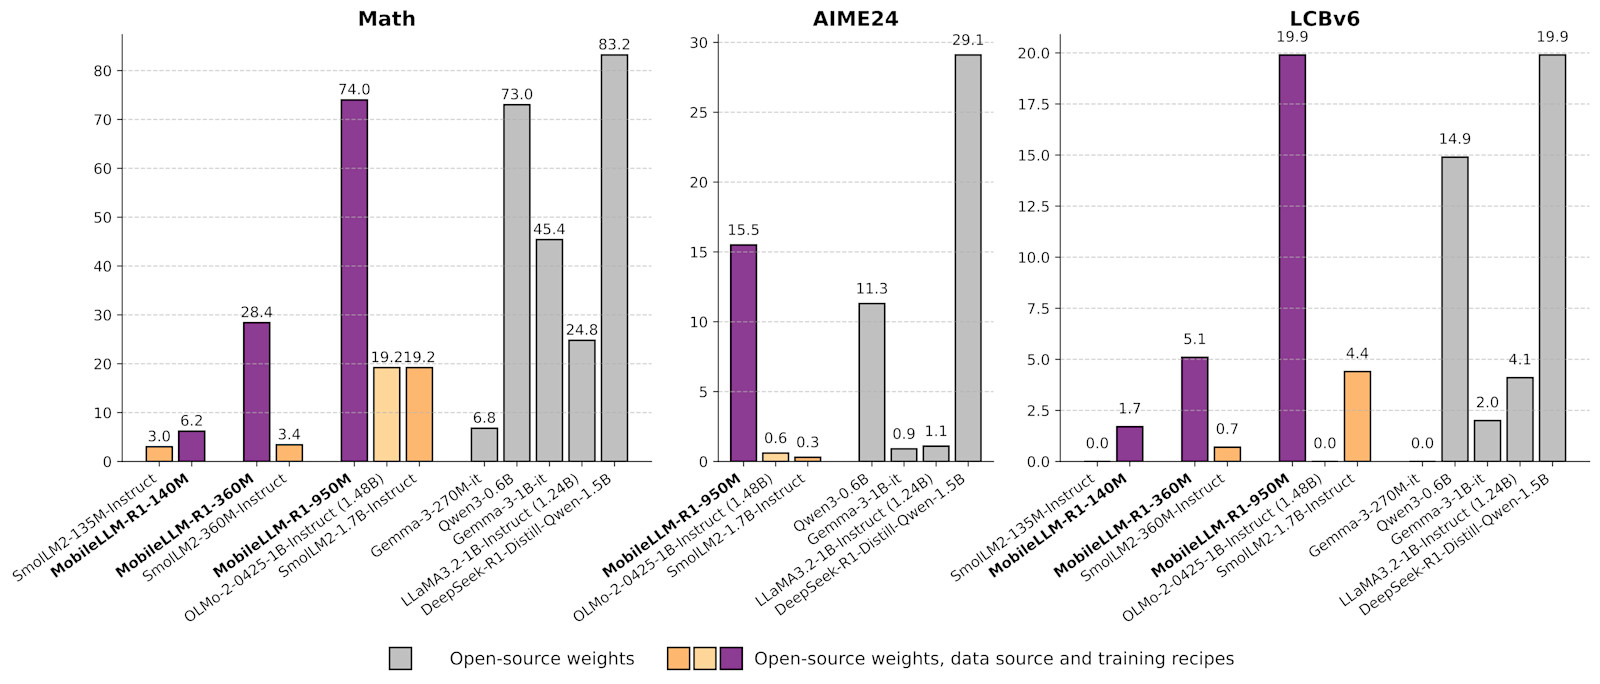
MobileLLM-R1 не уступает другим моделям аналогичного размера на ключевых бенчмарках рассуждений или превосходит их (источник: Hugging Face)
Модель с 950M параметров немного превосходит Qwen3-0.6B от Alibaba в бенчмарке MATH (74.0 против 73.0) и уверенно лидирует в тесте на написание кода LiveCodeBench (19.9 против 14.9). Это делает ее идеальным выбором для приложений, требующих надежной автономной логики, таких как встроенный в инструменты разработчика помощник по коду.
Тем не менее, здесь есть существенный нюанс: модель выпускается под некоммерческой лицензией FAIR от Meta, которая строго запрещает любое коммерческое использование самой модели или результатов ее работы. Для бизнеса это превращает MobileLLM-R1 скорее в мощную исследовательскую базу или внутренний инструмент, чем в готовый к производственному использованию актив, который можно монетизировать. (На странице Meta на Hugging Face указано, что «MobileLLM-R1 на данный момент распространяется по лицензии FAIR NC», что подразумевает возможность изменений в будущем).
Конкурентная среда миниатюрных языковых моделей
В то время как MobileLLM-R1 раздвигает границы производительности, более широкий рынок SLM предлагает коммерчески жизнеспособные альтернативы, адаптированные под различные корпоративные задачи. Например, модель Gemma 3 270M от Google — это сверхэффективная рабочая лошадка. При размере всего в 270 миллионов параметров она создана для максимальной экономии энергии. Внутренние тесты показали, что 25 диалогов расходуют менее 1% заряда батареи смартфона. Благодаря мягким условиям лицензирования она становится отличным выбором для компаний, желающих дообучить парк крошечных специализированных моделей для таких задач, как модерация контента или проверка на соответствие требованиям.
Для бизнеса, которому требуются мощные возможности рассуждения «из коробки» без лицензионных ограничений, ведущим претендентом является Qwen3-0.6B от Alibaba. Благодаря лицензии Apache-2.0 и производительности, не уступающей MobileLLM-R1, она служит практичной и готовой к коммерческому применению альтернативой. Тем временем другие игроки сосредоточились на корпоративном контроле и новых функциях. Модель Nemotron-Nano от Nvidia предлагает уникальные «рычаги управления», позволяющие разработчикам включать или отключать рассуждения простыми командами, а также устанавливать «бюджет на размышления» для баланса между скоростью и точностью. Компания Liquid AI активно развивает онлайн-мультимодальность на устройствах с помощью моделей, способных обрабатывать как текст, так и визуальные данные, в комплекте с набором для разработчиков, предназначенным для быстрого развертывания. Liquid AI экспериментирует с «жидкими нейронными сетями» — новой архитектурой, которая обещает снизить затраты на вычисления и память при работе высокопроизводительных систем ИИ.
От «богоподобной модели» к «парку специалистов»
Этот общеотраслевой переход к SLM стал прямой реакцией на болевые точки бизнеса. Зависимость от крупных облачных моделей сторонних разработчиков приводит к непредсказуемым расходам и дает компаниям минимальный контроль над обновлениями или отказом от старых версий моделей. Как заявил в недавнем интервью VentureBeat генеральный директор Liquid AI Рамин Хасани (Ramin Hasani), «предприятия осознают, что небольшие модели обеспечивают предсказуемость. Вместо того чтобы платить за каждый вызов API, вы можете лицензировать модель один раз и использовать ее бесконечно на самом устройстве». Такой подход также решает вопросы конфиденциальности и надежности, поскольку локальная обработка конфиденциальных данных повышает уровень соответствия нормативам и гарантирует работоспособность приложений без постоянного подключения к интернету. Потенциальный эффект весьма велик: Хасани видит в «сегменте малых моделей триллионные возможности к 2035 году».
Появление способных SLM открывает новые архитектурные возможности. Вместо того чтобы полагаться на одну массивную модель общего назначения, организации могут развернуть целый парк специализированных моделей. Эта стратегия, напоминающая переход индустрии программного обеспечения от монолитных приложений к микросервисам, заключается в разбиении сложных проблем на ряд более мелких, повторяющихся подзадач, каждую из которых решает дообученная SLM.
Такой подход лучше согласуется с постепенным переходом к агентским приложениям, где задачи распределяются между специализированными агентами. По данным исследователей из Nvidia, нынешнее доминирование крупных языковых моделей (LLM) часто оказывается «избыточным и не соответствует функциональным требованиям большинства сценариев использования агентов». С другой стороны, подход с использованием парка моделей лучше отражает принципы работы агентов ИИ и ведет к снижению затрат, увеличению скорости и большей прозрачности при возникновении сбоев.
Это не делает крупные модели устаревшими. Напротив, они обретут новую роль. Как объясняет исследователь ИИ Андрей Карпатый (Andrej Karpathy), сегодняшние крупнейшие модели достаточно мощны, чтобы «рефакторить и преобразовывать обучающие данные в идеальные синтетические форматы», которые можно использовать для дистилляции чистых навыков рассуждения в более мелкие и эффективные преемники. Это создает симбиотические отношения, в которых каждое поколение массивных моделей помогает создавать идеальные наборы для обучения следующего поколения гибких SLM, делая разработку ИИ более экологичной и устойчивой.
Одновременные шаги со стороны Meta, Google, Nvidia и других компаний подтверждают, что индустрия выбирает более прагматичное будущее для искусственного интеллекта. Эпоха «больше — значит лучше» не подошла к концу, но она больше не является единственной игрой в городе. Ценность малых моделей теперь неоспорима. Не каждая проблема требует молотка с 175 миллиардами параметров. Для все большего числа корпоративных задач более точным инструментом оказывается меньший по размеру.




