


LFM2-VL от Liquid AI увеличивает скорость GPU вдвое


Компания Liquid AI выпустила LFM2-VL — новое поколение базовых визуально-языковых моделей, созданных для эффективного развертывания на самых разных аппаратных средствах: от смартфонов и ноутбуков до носимых гаджетов и встроенных систем.
Эти модели обеспечивают высокую производительность с малой задержкой, отличную точность и гибкость для реальных сценариев применения.
LFM2-VL создана на базе существующей архитектуры LFM2, представленной чуть больше месяца назад. По заявлению компании, она предлагает «самые быстрые базовые модели на устройстве на рынке» благодаря подходу динамической генерации «весов» или настроек модели «на лету» для каждого входного данных (известному как линейная система с переменными находами (LIV)), расширяя ее возможности до мультимодальной обработки, которая поддерживает ввод как текста, так и изображений с переменным разрешением.
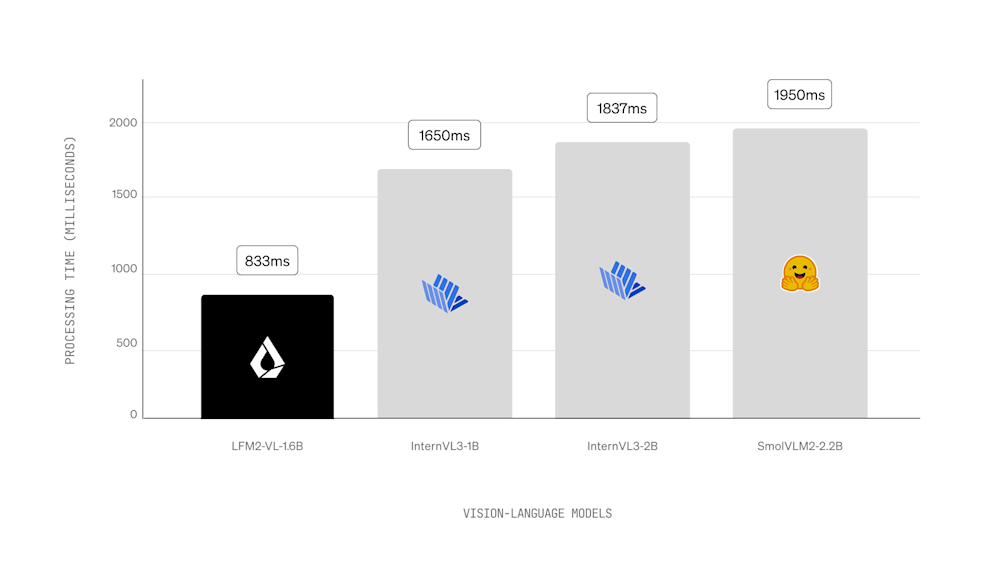
По данным Liquid AI, модели обеспечивают скорость вывода на GPU, вдвое превышающую показатели сопоставимых визуально-языковых моделей, сохраняя при этом конкурентоспособные результаты на стандартных бенчмарках.
«Эффективность — это наш продукт», — отметил соучредитель и генеральный директор Liquid AI Рамин Хасани (Ramin Hasani) в публикации на X, посвященной анонсу нового семейству моделей:
Два варианта под разные задачи
Релиз включает в себя модели двух размеров:
-
LFM2-VL-450M — гиперэффективная модель с менее чем полумиллиардом параметров (внутренних настроек), предназначенная для среды с крайне ограниченными ресурсами.
-
LFM2-VL-1.6B — более мощная модель, которая остается достаточно легковесной для развертывания на одном графическом процессоре и непосредственно на устройствах.
Оба варианта обрабатывают изображения в исходном разрешении до 512×512 пикселей, избегая искажений или избыточного апскейлинга.
Для более крупных изображений система применяет разбиение на непересекающиеся фрагменты и добавляет миниатюру для создания глобального контекста, позволяя модели улавливать как мелкие детали, так и общую сцену.
О компании Liquid AI
Компания Liquid AI была основана бывшими исследователями из Лаборатории искусственного интеллекта и компьютерных наук Массачусетского технологического института (CSAIL) с целью создания архитектур искусственного интеллекта, выходящих за рамки повсеместно используемой модели трансформера.
Флагманская разработка компании — базовые модели Liquid (LFM) — основана на принципах динамических систем, цифровой обработки сигналов и численной линейной алгебры, что позволяет создавать универсальные ИИ-модели, способные работать с текстом, видео, аудио, временными рядами и другими последовательными данными.
В отличие от традиционных архитектур, подход Liquid нацелен на обеспечение конкурентоспособной или превосходящей производительности при значительно меньших вычислительных ресурсах, что позволяет осуществлять адаптацию в реальном времени во время инференса при сохранении низких требований к памяти. Это делает LFM отлично пригодными как для крупномасштабных корпоративных задач, так и для периферийных развертываний с ограниченными ресурсами.
В июле компания расширила стратегию своей платформы, запустив Liquid Edge AI Platform (LEAP) — кроссплатформенный SDK, призванный упростить разработчикам запуск малых языковых моделей напрямую на мобильных и встроенных устройствах.
LEAP предлагает независимую от ОС поддержку iOS и Android, интеграцию как с собственными моделями Liquid, так и с другими открытыми SLM, а также встроенную библиотеку с моделями размером от 300 МБ — достаточно компактными для современных телефонов с минимальным объемом оперативной памяти.
Сопутствующее приложение Apollo позволяет разработчикам тестировать модели полностью в автономном режиме, что соответствует акценту Liquid AI на конфиденциальный ИИ с малой задержкой. В совокупности LEAP и Apollo отражают приверженность компании делу децентрализации выполнения ИИ, снижения зависимости от облачной инфраструктуры и предоставления разработчикам возможностей создавать оптимизированные модели под конкретные задачи для реальных условий.
Компромиссы скорости и качества и технический дизайн
LFM2-VL использует модульную архитектуру, объединяющую основу языковой модели, визуальный энкодер SigLIP2 NaFlex и мультимодальный проектор.
Проектор включает в себя двухслойный MLP-коннектор с операцией pixel unshuffle, что сокращает количество токенов изображения и повышает пропускную способность.
Пользователи могут настраивать такие параметры, как максимальное количество токенов или патчей изображения, что позволяет находить баланс между скоростью и качеством в зависимости от сценария развертывания. Процесс обучения включал примерно 100 миллиардов мультимодальных токенов, полученных из открытых наборов данных и собственных синтетических данных.
Производительность и бенчмарки
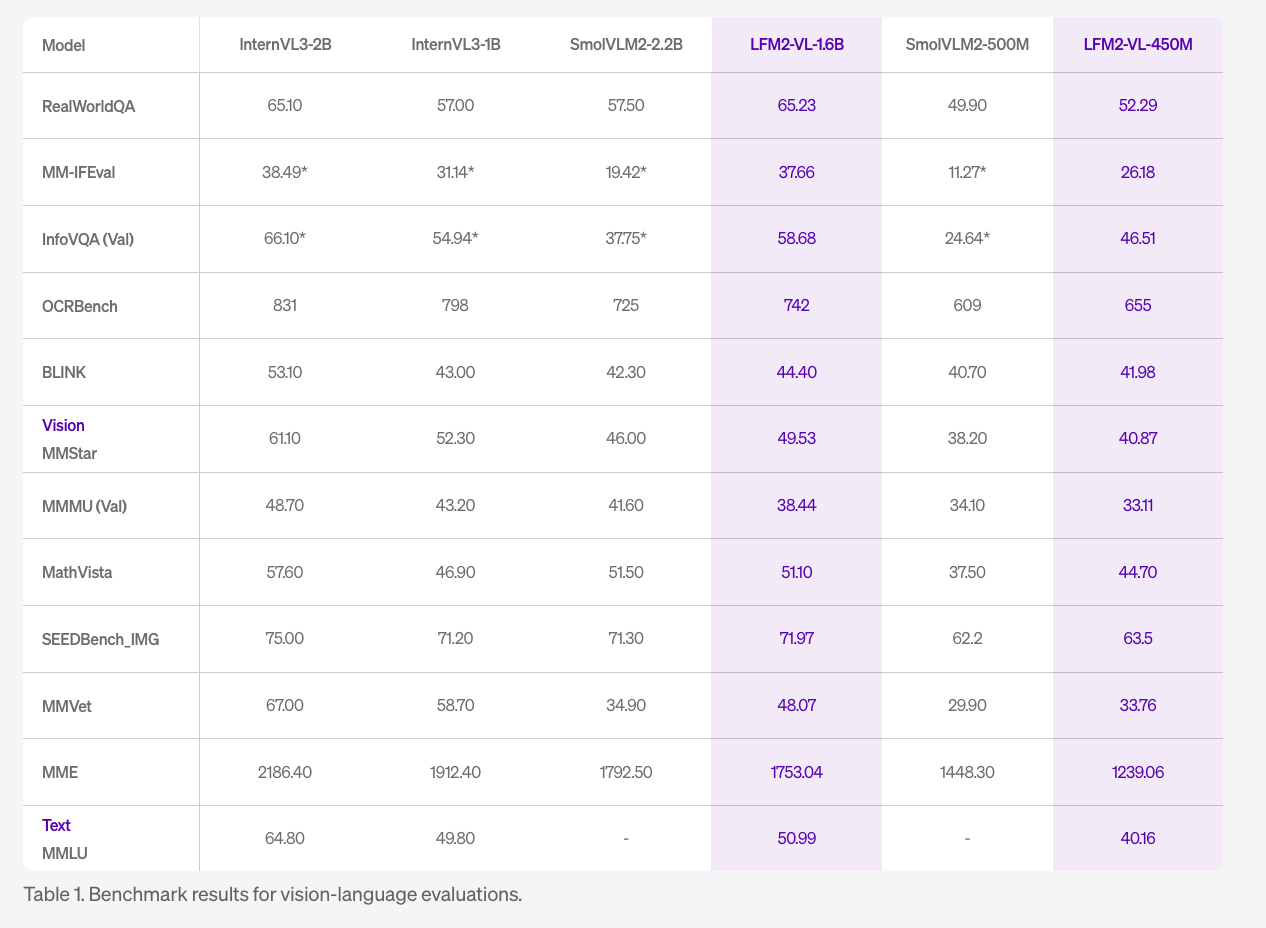
Модели демонстрируют конкурентоспособные результаты в различных тестах визуально-языковых возможностей. LFM2-VL-1.6B показывает хорошие результаты в тестах RealWorldQA (65.23), InfoVQA (58.68) и OCRBench (742), а также сохраняет солидные показатели в задачах мультимодального рассуждения.
В ходе тестов производительности инференса LFM2-VL показала самое быстрое время обработки на графическом процессоре в своем классе при тестировании на стандартной рабочей нагрузке, включающей изображение с разрешением 1024х1024 и короткий промпт.
Лицензирование и доступность
Модели LFM2-VL уже доступны на Hugging Face вместе с примером кода для файнтюнинга в Colab. Они совместимы с библиотеками transformers и TRL от Hugging Face.
Модели выпускаются под пользовательской «лицензией LFM1.0». В Liquid AI охарактеризовали ее как основанную на принципах Apache 2.0, однако полный текст пока не опубликован.
Компания отметила, что коммерческое использование будет разрешено при определенных условиях с разными правилами для компаний с годовой выручкой выше и ниже 10 миллионов долларов.
С помощью LFM2-VL компания Liquid AI стремится сделать высокопроизводительный мультимодальный ИИ более доступным для локального запуска на устройствах и в условиях ограниченных ресурсов без ущерба для функциональности.




