RLP от Nvidia повышает эффективность рассуждений языковых моделей на 17%
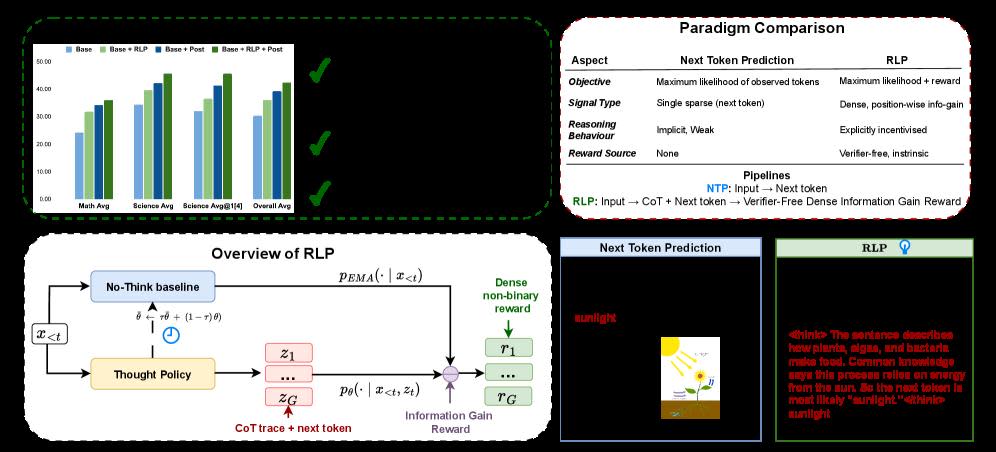


Исследователи из Nvidia разработали новый подход, который кардинально меняет представление о том, как большие языковые модели (LLM) учатся рассуждать.
Этот метод, получивший название предварительное обучение с подкреплением (reinforcement learning pre-training, RLP), интегрирует обучение с подкреплением на начальный этап обучения, а не откладывает его на финальную стадию.
Такой подход «побуждает модель «думать самостоятельно», прежде чем предсказывать следующий токен, тем самым прививая модель навыки независимого мышления на более ранних этапах предварительного обучения», — отмечают исследователи в своей научной работе.
Научившись рассуждать на обычном тексте без использования внешних верификаторов, модели, обученные с помощью RLP, демонстрируют значительные улучшения в решении сложных задач на логику и рассуждение в ходе последующей доработки. Это намекает на появление в будущем более способных и адаптируемых систем ИИ для решения реальных задач.
Типичный цикл обучения LLM
Как правило, большие языковые модели сначала проходят предварительное обучение на огромных массивах текста с использованием метода «прогнозирования следующего токена» (next-token prediction). В рамках этого метода модели предоставляется последовательность текста, и ей предлагается непрерывно угадывать следующее слово (или токен). На этом этапе они усваивают грамматику, факты и базовые ассоциации.
На последующей стадии донастройки (post-training) модели обычно осваивают сложные навыки рассуждения, такие как цепочка рассуждений (chain-of-thought, CoT), когда модель выстраивает свои умозаключения по шагам. Этот этап часто включает в себя контролируемое дообучение (supervised fine-tuning, SFT) или обучение с подкреплением на основе отзывов человека (RLHF), для которых требуются специализированные отборные наборы данных.
Авторы статьи утверждают, что этот последовательный процесс не соответствует человеческому восприятию, которое «не является линейным процессом токен за токеном, а представляет собой параллельную интеграцию входных данных с предварительными знаниями». Существующие методы предварительного обучения лишены этого механизма, что мешает моделям развивать глубокие навыки рассуждения с самого начала.
Как работает предварительное обучение с подкреплением
RLP переосмысливает этот процесс, рассматривая генерацию цепочки рассуждений (CoT) как действие, которое модель выполняет перед прогнозированием следующего токена. На каждом шаге модель сначала генерирует внутреннюю «мысль» или цепочку рассуждений. Затем она прогнозирует следующее слово в тексте, используя исходный контекст, дополненный ее новой мыслью.
Модель получает вознаграждение в зависимости от того, насколько ее мысль повысила точность прогноза по сравнению с базовым вариантом, где мысль не генерировалась (чистое прогнозирование следующего токена). Этот сигнал вознаграждения вычисляется автоматически на основе изменения вероятности, что исключает необходимость в использовании внешних верификаторов или данных с ручной разметкой.
Вознаграждение является положительным только тогда, когда сгенерированная мысль помогает модели точнее предсказать следующий токен. Награждая мысли за их предсказательную пользу, RLP эффективно обучает модель тому, как продуктивно рассуждать, используя те же самые масштабные неструктурированные наборы данных, которые применяются для стандартного предварительного обучения.
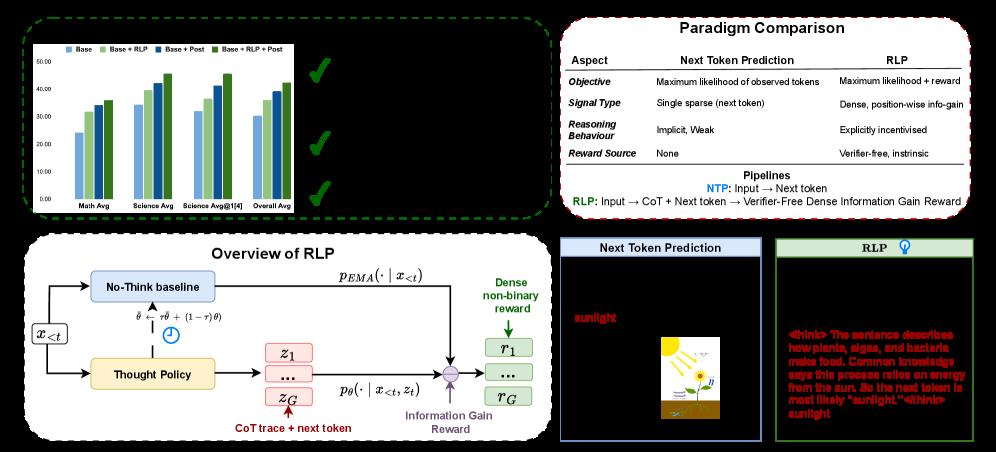
Фреймворк предварительного обучения с подкреплением (RLP) (источник: arXiv)
Этот непрерывный цикл обратной связи позволяет модели определять, когда достаточно простого предположения, а когда необходимо задействовать более глубокие рассуждения. Как отмечают исследователи, «метод RLP разработан для формирования мышления в базовых моделях путем вознаграждения исключительно тех мыслей, которые измеримо помогают прогнозировать следующий токен».
Тем не менее этот фундаментальный подход не делает последующие этапы донастройки устаревшими. По словам Брайана Катанзаро (Bryan Catanzaro), вице-президента по прикладным исследованиям в области глубокого обучения в Nvidia и соавтора научной работы, RLP призван дополнять, а не заменять эти важнейшие шаги. «RLP не предназначен для замены последующих этапов донастройки, таких как контролируемое дообучение или обучение с подкреплением на основе отзывов человека, — рассказал Катанзаро изданию VentureBeat. — Эти стадии по-прежнему критически важны для шлифовки поведения модели… На самом деле он создан для того, чтобы усиливать эффективность этих последующих фаз, давая модели фору с самого начала».
RLP в действии
В ходе экспериментов с моделями Qwen3-1.7B и Nemotron-Nano-12B команда Nvidia протестировала RLP наборе бенчмарков для проверки математических и научных рассуждений. Результаты показали, что модели, усовершенствованные с помощью RLP, стабильно превосходили свои традиционно обученные аналоги, причем наиболее сильный прирост наблюдался в задачах, требующих сложных рассуждений.
Для бизнеса такое улучшение навыков логического мышления может обернуться более надежными результатами в многоэтапных рабочих процессах, таких как финансовый анализ или суммирование юридических документов.
«RLP побуждает модель в процессе предварительного обучения думать перед тем, как делать прогнозы, помогая ей усвоить более когерентный стиль рассуждений, — отметил Катанзаро. — Это может помочь снизить количество мелких логических ошибок, особенно в затяжных рабочих процессах».
Подчеркивая, что моделям, обученным с помощью RLP, по-прежнему будут нужны привычные предохранители (такие как уровни верификации, надзор со стороны человека и проверки на согласованность), Катанзаро заявил, что «RLP обеспечивает более прочную отправную точку».
Важно отметить, что преимущества RLP не исчезают, а суммируются во время последующих этапов донастройки (катастрофическое забывание — распространенная проблема при обучении LLM, из-за которой на поздних этапах модель «забывает» ранее усвоенные навыки и знания). Модель, обученная с использованием RLP, после прохождения идентичного курса донастройки показала общий результат, который оказался на 7–8% выше по сравнению с базовыми моделями. Исследователи делают вывод, что RLP «закладывает прочный фундамент для логических рассуждений, который не стирается при последующей настройке согласованности (alignment), а усиливается в сочетании с пострежимом обучения».
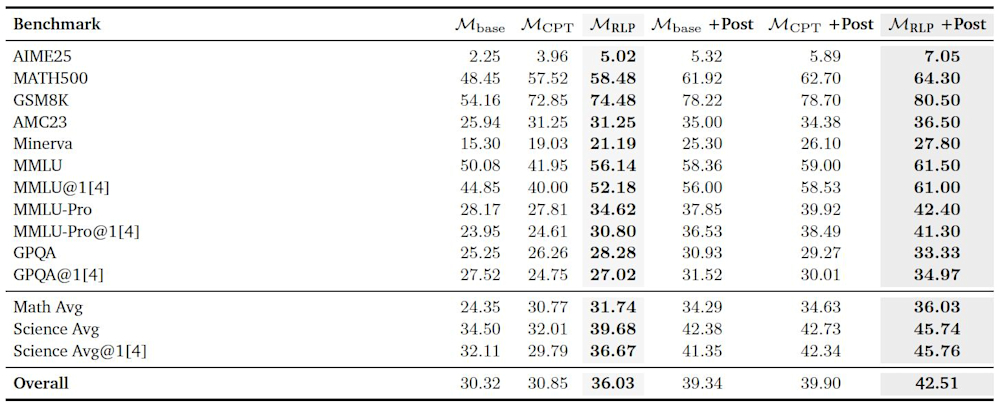
RLP повышает производительность LLM на различных бенчмарках рассуждений (источник: arXiv)
Эффективность метода является ключевым открытием. На модели Qwen3-1.7B методика RLP повысила производительность на 17% по сравнению со стандартным непрерывным предварительным обучением, а также превзошла аналогичный подход под названием «Предварительное обучение с подкреплением на основе сопоставления префиксов» (RPT). Это преимущество сохранялось даже тогда, когда базовая модель обучалась на объеме данных, в 35 раз превышающем прежний, ради сопоставимых вычислительных затрат. Это подтверждает, что прирост производительности достигается именно благодаря самому методу, а не просто за счет увеличения объема обработки.
Кроме того, RLP демонстрирует впечатляющую масштабируемость и универсальность, успешно извлекая сигналы для рассуждений из общедоступных веб-данных, а не только из отборных наборов. При применении к гибридной модели Mamba-Transformer Nemotron-Nano-12B, RLP обеспечила относительное улучшение на 35% по сравнению с интенсивно обученной базовой моделью, задействовав при этом лишь малую часть данных.
Хотя эти результаты указывают на более эффективный путь создания мощных моделей, Катанзаро рассматривает это нововведение скорее как фундаментальный сдвиг в самом процессе обучения, а не как немедленное решение проблемы высоких затрат на тренировку.
«Это исследование вызывает энтузиазм, поскольку оно меняет подход к усвоению информации моделями на этапе предварительного обучения, что приводит к более интеллектуальному процессу получения знаний, — пояснил он. — Метод не заменит крупномасштабное предварительное обучение, но предложит еще один креативный способ создания наилучших возможных моделей».
Новая основа для обучения ИИ
В конечном счете RLP указывает на будущее, в котором предварительное обучение перестанет быть монолитным процессом прогнозирования следующего токена. Вместо этого новое поколение моделей может строиться на гибриде различных целей, создавая ИИ, который учится рассуждать более надежно с первого же дня. Катанзаро приводит яркую аналогию для описания этого сдвига:
«Прогнозирование следующего токена учит модель тому, как устроен мир; цели в стиле обучения с подкреплением, такие как RLP, могут научить ее тому, как осмысливать увиденное, — говорит он. — Сочетание этих двух задач может помочь моделям развивать более глубокое и структурированное мышление гораздо раньше в процессе обучения… Такие инструменты, как RLP, могут надстраиваться над этим фундаментом, делая обучение более активным, любознательным и даже более эффективным».
Нам еще многое предстоит узнать о динамике обучения с подкреплением на фазе предварительного обучения, но очевидно одно: «внедрение элементов исследования на более ранних этапах обучения открывает новую ось для масштабирования — не только в плане размера, но и в том, как модели учатся рассуждать», подытожил Катанзаро.