AMI Labs привлекает $1,03 млрд на развитие мировых моделей


Большие языковые модели сталкиваются с ограничениями в областях, требующих понимания физического мира — от робототехники и автономного вождения до производства. Это ограничение подталкивает инвесторов к моделям мира (world models): компания AMI Labs привлекла посевной раунд в размере 1,03 млрд долларов вскоре после того, как World Labs обеспечила финансирование на 1 млрд долларов.
Большие языковые модели (ЯМ) превосходно обрабатывают абстрактные знания посредством прогнозирования следующего токена, но им принципиально не хватает привязки к физической причинности. Они не способны надежно предсказывать физические последствия действий в реальном мире.
Исследователи ИИ и лидеры мнений все чаще открыто говорят об этих ограничениях, поскольку индустрия пытается вывести ИИ из веб-браузеров в физическое пространство. В интервью подкастеру Дваркешу Пателю лауреат премии Тьюринга Ричард Саттон предупредил, что ЯМ лишь имитируют человеческую речь, вместо того чтобы моделировать мир, что ограничивает их способность учиться на собственном опыте и адаптироваться к изменениям в мире.
Именно поэтому модели на базе ЯМ, включая видеоязыковые модели (ВЯМ), могут демонстрировать хрупкое поведение и давать сбой при минимальных изменениях входных данных.
Генеральный директор Google DeepMind Демис Хассабис поддержал эту мысль в другом интервью, отметив, что современным моделям ИИ свойственен «рваный интеллект». Они могут решать сложные олимпиадные задачи по математике, но терпят неудачу в элементарной физике, поскольку им не хватает критически важных возможностей, касающихся динамики реального мира.
Чтобы решить эту проблему, исследователи смещают фокус на создание моделей мира, которые действуют как внутренние симуляторы, позволяя системам ИИ безопасно тестировать гипотезовые сценарии перед совершением физических действий. Тем не менее, «модели мира» — это зонтичный термин, охватывающий несколько различных архитектурных подходов.
Это привело к появлению трех различных архитектурных подходов, каждый из которых имеет свои плюсы и минусы.
JEPA: создана для реального времени
Первый основной подход фокусируется на изучении скрытых представлений (латентных представлений), вместо того чтобы пытаться предсказать динамику мира на уровне пикселей. Этот метод, поддерживаемый AMI Labs, во многом основан на совместной эмбеддинговой предсказательной архитектуре (Joint Embedding Predictive Architecture, JEPA).
Модели JEPA пытаются имитировать то, как люди понимают мир. Когда мы наблюдаем за окружающим миром, мы не запоминаем каждый отдельный пиксель или незначительную деталь сцены. Например, если вы видите едущий по улице автомобиль, вы отслеживаете его траекторию и скорость, а не вычисляете точное отражение света на каждом отдельном листе деревьев на заднем плане.
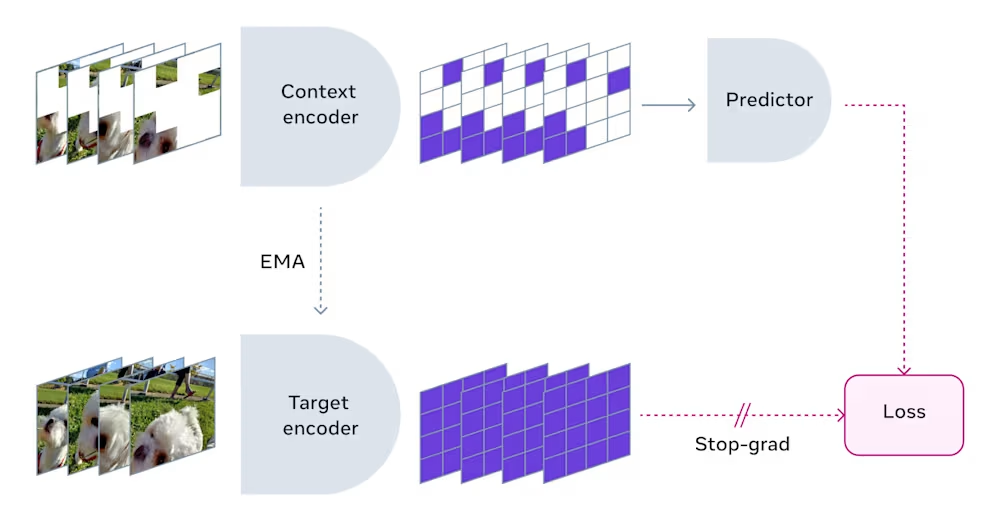
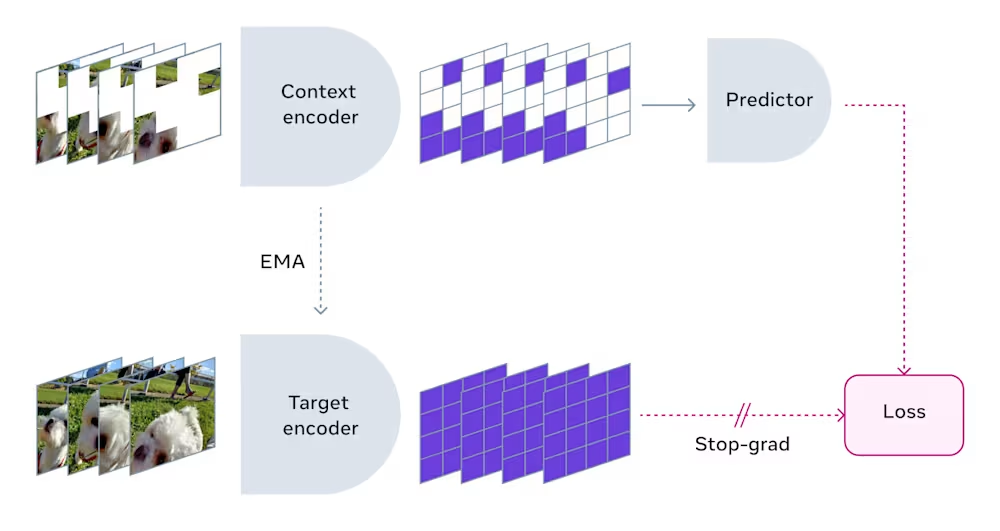
Архитектура V-JEPA (источник: Meta FAIR)
Модели JEPA воспроизводят этот человеческий когнитивный прием. Вместо того чтобы заставлять нейросеть предсказывать точный вид следующего кадра видео, модель изучает меньший набор абстрактных или «латентных» признаков. Она отбрасывает второстепенные детали и фокусируется исключительно на базовых правилах взаимодействия элементов в сцене. Это делает модель устойчивой к фоновым шумам и небольшим изменениям, которые выводят из строя другие модели.
Эта архитектура крайне эффективна с точки зрения вычислений и памяти. Игнорируя незначительные детали, она требует гораздо меньшего количества обучающих примеров и работает со значительно меньшей задержкой. Такие характеристики делают ее подходящей для приложений, где эффективность и инференс в реальном времени не подлежат обсуждению, таких как робототехника, беспилотные автомобили и критически важные корпоративные рабочие процессы.
Например, AMI сотрудничает с медицинской компанией Nabla, чтобы использовать эту архитектуру для моделирования операционной сложности и снижения когнитивной нагрузки в динамичной сфере здравоохранения.
Ян ЛеКун, пионер архитектуры JEPA и соучредитель AMI, пояснил в интервью Newsweek, что модели мира на базе JEPA спроектированы так, чтобы быть «управляемыми в том смысле, что вы можете ставить перед ними цели, и в силу самой конструкции единственное, что они могут делать, — это достигать этих целей».
Гауссовы сплатты: созданы для пространства
Второй подход опирается на генеративные модели для создания полноценных пространственных сред с нуля. Этот метод, взятый на вооружение такими компаниями, как World Labs, берет исходный промпт (это может быть изображение или текстовое описание) и использует генеративную модель для создания трехмерного гауссова сплатта. Гауссов сплатт (Gaussian splat) — это метод представления 3D-сцен с использованием миллионов крошечных математических частиц, определяющих геометрию и освещение. В отличие от плоской генерации видео, эти 3D-представления могут быть импортированы напрямую в стандартные физические и 3D-движки, такие как Unreal Engine, где пользователи и другие агенты ИИ могут свободно перемещаться по ним и взаимодействовать с ними под любым углом.
Главным преимуществом здесь является резкое сокращение времени и единовременных затрат на генерацию, необходимых для создания сложных интерактивных 3D-сред. Это напрямую решает проблему, о которой говорила основательница World Labs Фей-Фей Ли, отметившая, что ЯМ в конечном счете похожи на «мастеров слова в темноте», обладающих цветастым языком, но лишенных пространственного интеллекта и физического опыта. Модель Marble от World Labs наделяет ИИ недостающим пространственным восприятием.
Хотя этот подход не предназначен для мгновенного выполнения в реальном времени, он обладает огромным потенциалом для пространственных вычислений, интерактивных развлечений, промышленного дизайна и создания статических обучающих сред для робототехники. Корпоративная ценность очевидна благодаря мощной поддержке World Labs со стороны Autodesk, которая интегрирует эти модели в свои приложения для промышленного дизайна.
Сквозная (end-to-end) генерация: создана для масштабирования
Третий подход использует сквозную генеративную модель для обработки промптов и пользовательских действий, непрерывно генерируя сцену, физическую динамику и реакции на лету. Вместо экспорта статического 3D-файла во внешний физический движок, сама модель выступает в роли этого движка. Она принимает исходный промпт вместе с непрерывным потоком действий пользователя и генерирует последующие кадры среды в реальном времени, автоматически вычисляя физику, освещение и реакцию объектов.
Разработки DeepMind Genie 3 и Nvidia Cosmos относятся к этой категории. Эти модели предоставляют очень простой интерфейс для генерации бесконечных интерактивных впечатлений и огромных объемов синтетических данных. DeepMind наглядно продемонстрировала это с помощью Genie 3, показав, как модель поддерживает строгую перманентность объектов и стабильную физику со скоростью 24 кадра в секунду без опоры на отдельный модуль памяти.
Этот подход напрямую трансформируется в мощные фабрики синтетических данных. Nvidia Cosmos использует эту архитектуру для масштабирования синтетических данных и физических рассуждений ИИ, позволяя разработчикам беспилотных транспортных средств и робототехники синтезировать редкие, опасные пограничные условия (edge cases) без затрат и рисков физического тестирования. Waymo (еще одна дочерняя компания Alphabet) построила свою модель мира поверх Genie 3, адаптировав ее для обучения своих беспилотных автомобилей.
Обратной стороной этого метода сквозной генерации являются огромные вычислительные затраты, необходимые для одновременного непрерывного рендеринга физики и пикселей. Тем не менее, эти инвестиции необходимы для реализации концепции Хассабис, который утверждает, что глубокое внутреннее понимание физической причинности необходимо, поскольку современному ИИ не хватает критически важных возможностей для безопасной работы в реальном мире.
Что дальше: гибридные архитектуры
ЯМ продолжат служить интерфейсом для рассуждений и коммуникации, но модели мира позиционируют себя в качестве фундаментальной инфраструктуры для потоков физических и пространственных данных. По мере того как базовые модели взрослеют, мы наблюдаем появление гибридных архитектур, использующих сильные стороны каждого подхода.
Например, стартап в сфере кибербезопасности DeepTempo недавно разработал LogLM — модель, объединяющую элементы ЯМ и JEPA для обнаружения аномалий и киберугроз на основе логов безопасности и сети.