


ИИ от Google способствует адаптивному сотрудничеству


Обучение стандартных ИИ-моделей на разнообразном пуле противников — вместо создания сложных жестко заданных правил координации — позволяет создавать кооперативные многоагентные системы, которые адаптируются друг к другу на лету. К такому выводу пришла команда Google Paradigms of Intelligence, утверждающая, что этот подход предлагает масштабируемую и вычислительно эффективную основу для развертывания корпоративных многоагентных систем без необходимости использования специализированных вспомогательных каркасов.
Этот метод работает за счет обучения LLM-агента с помощью децентрализованного обучения с подкреплением на смешанном пуле противников — некоторые из них активно обучаются, а другие статичны и основаны на правилах. Вместо жестко заданных правил агент использует контекстное обучение (in-context learning), чтобы считывать каждое взаимодействие и адаптировать свое поведение в режиме реального времени.
Почему многоагентные системы продолжают бороться друг с другом
Сфера искусственного интеллекта стремительно смещается от изолированных систем к парку агентов, которые должны одновременно договариваться, сотрудничать и действовать в общем пространстве. В многоагентных системах успех задачи зависит от взаимодействий и поведения множества сущностей, а не одного агента.
Главная сложность в таких многоагентных системах заключается в том, что их взаимодействия часто связаны с конкурирующими целями. Поскольку эти автономные агенты созданы для максимизации собственных конкретных показателей, невероятно сложно обеспечить, чтобы они не подрывали действия друг друга в подобных сценариях со смешанными мотивами.
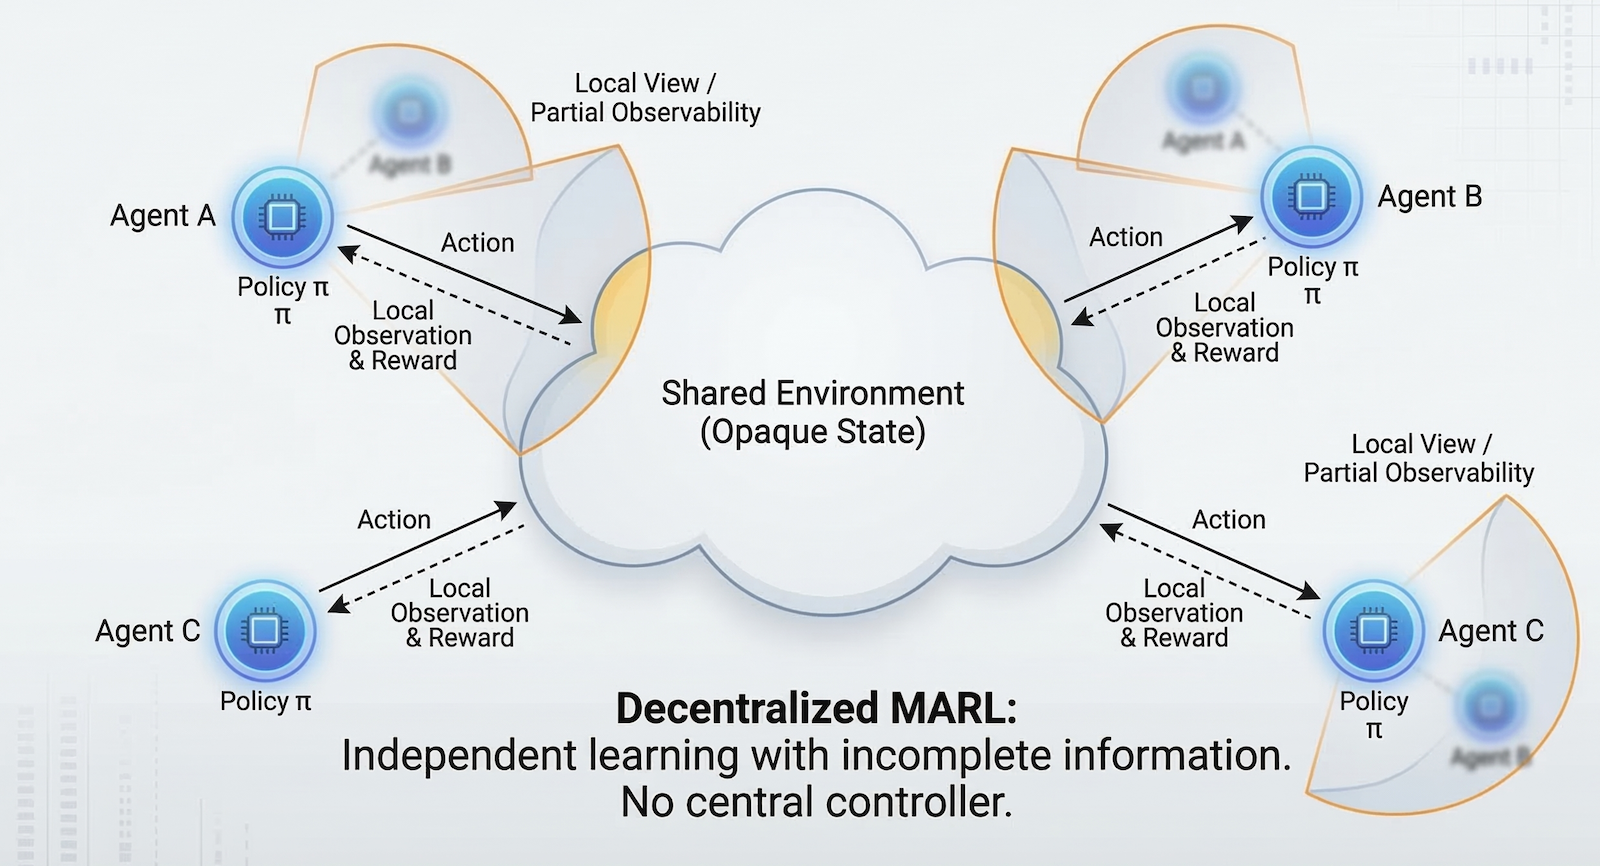
Многоагентное обучение с подкреплением (MARL) пытается решить эту проблему путем одновременного обучения нескольких ИИ-агентов, которые функционируют, взаимодействуют и обучаются в одной и той же общей среде. Однако в реальных корпоративных архитектурах единая централизованная система редко имеет обзор всех движущихся частей или контролирует их. Разработчикам приходится полагаться на децентрализованный MARL, где отдельные агенты должны сами разбираться, как взаимодействовать с другими, имея доступ лишь к собственным ограниченным локальным данным и наблюдениям.
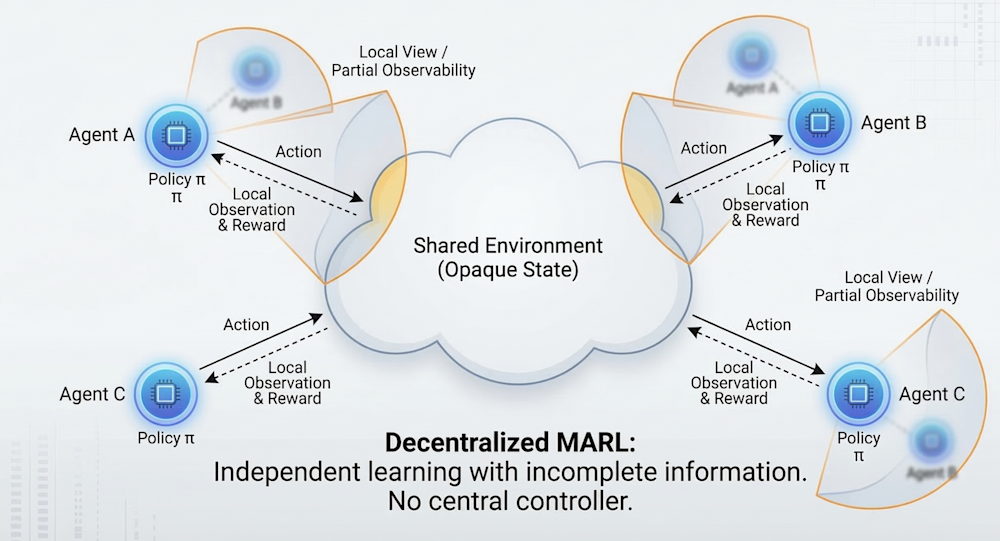
Многоагентное обучение с подкреплением
Одна из основных проблем децентрализованного MARL заключается в том, что агенты часто застревают в субоптимальных состояниях, пытаясь максимизировать собственные конкретные вознаграждения. Исследователи называют это «взаимным предательством», ссылаясь на известную по теории игр головоломку — дилемму заключенного. Например, представьте два автоматизированных алгоритма ценообразования, вовлеченные в разрушительную гонку на понижение. Поскольку каждый агент оптимизирует процессы исключительно ради собственной выгоды, они приходят к тупику, в котором проигрывает бизнес в целом.
Другая проблема заключается в том, что традиционные структуры обучения предназначены для стационарных сред, что означает относительно фиксированные правила игры и поведение среды. В многоагентной системе, с точки зрения любого отдельного агента, среда фундаментально непредсказуема и постоянно меняется, поскольку другие агенты одновременно обучаются и адаптируют собственную политику.
Хотя корпоративные разработчики в настоящее время полагаются на фреймворки с использованием жестких конечных автоматов, эти методы часто упираются в предел масштабируемости при развертывании сложных систем.
«Основное ограничение жестко закодированной оркестровки — ее нехватка гибкости», — рассказал VentureBeat Александр Мейлеманс (Alexander Meulemans), соавтор научной работы и старший научный сотрудник команды Paradigms of Intelligence в Google. — Хотя жесткие конечные автоматы неплохо функционируют в узких предметных областях, они могут не справиться с масштабированием по мере расширения масштабов и сложности развертывания агентов. Наш подход на основе контекстного обучения дополняет существующие фреймворки, способствуя развитию адаптивного социального поведения, которое глубоко закладывается на этапе посттренинга».
Что это значит для разработчиков, использующих LangGraph, CrewAI или AutoGen
Такие фреймворки, как LangGraph, требуют от разработчиков явного определения агентов, переходов между состояниями и логики маршрутизации в виде графа. LangChain описывает этот подход как эквивалент конечного автомата, где узлы агентов и их связи представляют собой состояния и матрицы переходов. Подход Google переворачивает эту модель: вместо жесткого кодирования того, как агенты должны координировать свои действия, он порождает кооперативное поведение в процессе обучения, оставляя агентам возможность выводить правила координации из контекста.
Исследователи доказывают, что разработчики могут создавать продвинутые, кооперативные многоагентные системы, используя те же самые стандартные методы моделирования последовательностей и обучения с подкреплением, которые уже лежат в основе современных базовых моделей.
Команда подтвердила эту концепцию с помощью нового метода, названного улучшением предиктивной политики (Predictive Policy Improvement, PPI), хотя Мейлеманс отмечает, что лежащий в его основе принцип не зависит от конкретной модели.
«Вместо обучения небольшого набора агентов с фиксированными ролями команды должны внедрять процедуру обучения со «смешанным пулом»», — сказал Мейлеманс. — Разработчики могут воспроизвести эту динамику, используя стандартные готовые алгоритмы обучения с подкреплением (такие как GRPO)».
Предоставляя агентам возможность взаимодействовать с разнообразными партнерами по игре (т. е. с различающимися системными промптами, дообученными параметрами или базовыми правилами), команды создают надежную среду обучения. Это позволяет вырабатывать стратегии, которые устойчивы при взаимодействии с новыми партнерами, и гарантирует, что многоагентное обучение приведет к стабильному долгосрочному кооперативному поведению.
Как исследователи доказали работоспособность метода
Чтобы создать агентов, способных успешно вычислять стратегию партнера по игре, исследователи создали децентрализованную среду обучения, в которой ИИ сталкивается с чрезвычайно разнообразным, смешанным пулом противников, состоящим из активно обучающихся моделей и статических программ, работающих по правилам. Такое искусственно созданное разнообразие заставляет агента динамически определять, с кем именно он взаимодействует, и адаптировать свое поведение на лету, опираясь исключительно на контекст взаимодействия.
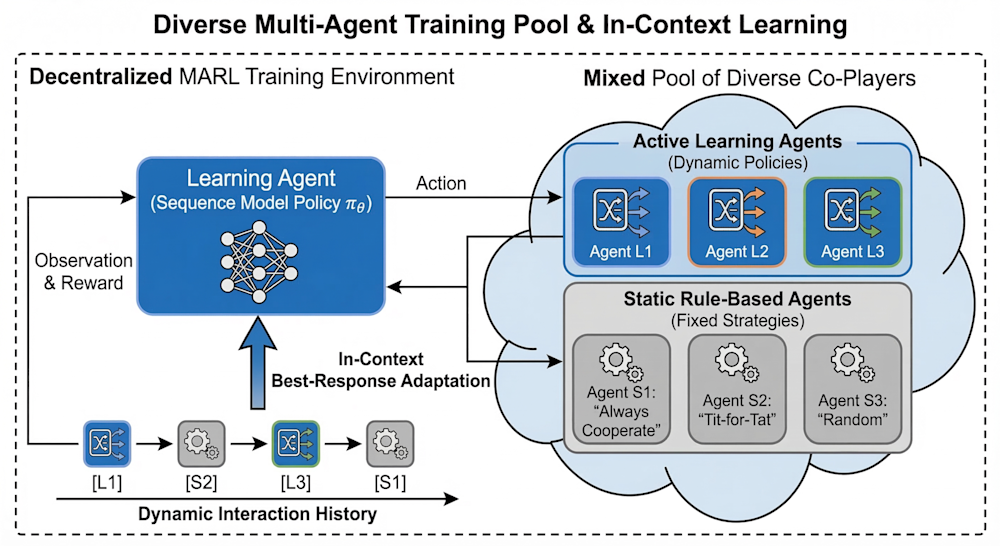
Обучение в условиях разнообразия агентов
Для корпоративных разработчиков фраза «контекстное обучение» часто вызывает опасения по поводу раздувания контекстного окна, затрат на API и задержек, особенно когда окна и так перегружены данными поиска с дополненной генерацией (RAG) и системными промптами. Тем не менее Мейлеманс уточняет, что этот метод ориентирован на эффективность, а не на количество токенов. «Наш метод направлен на оптимизацию того, как агенты используют доступный им контекст на этапе после обучения, а не на жесткое требование больших контекстных окон», — пояснил он. Обучая агентов анализировать историю взаимодействий для вывода стратегий, они используют выделенный контекст более адаптивно, не требуя более длинных контекстных окон, чем существующие приложения.
Используя итеративную дилемму заключенного (IPD) в качестве эталонного теста, исследователи добились надежного и стабильного сотрудничества без каких-либо традиционных костылей. Здесь нет искусственного разделения на мета-агентов и внутренних учеников, а также нет необходимости жестко кодировать предположения о том, как функционирует алгоритм оппонента. Поскольку агент адаптируется в режиме реального времени и одновременно обновляет веса своей базовой модели в ходе множества взаимодействий, он фактически совмещает обе роли. Более того, агенты демонстрировали лучшие результаты, когда им не предоставлялось никакой информации об их противниках и они были вынуждены адаптироваться к их поведению путем проб и ошибок.
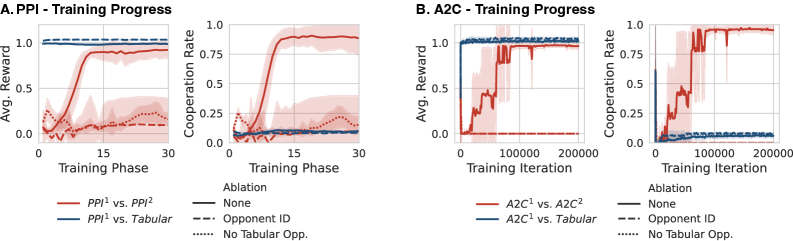
Многоагентное обучение работает лучше всего, когда ему предоставляется пул разнообразных агентов и позволяется самостоятельно исследовать правила (источник: arXiv)
Роль разработчика смещается от автора правил к архитектору
Исследователи заявляют, что их работа преодолевает разрыв между многоагентным обучением с подкреплением и парадигмами обучения современных базовых моделей. «Поскольку базовые модели естественным образом демонстрируют контекстное обучение и обучаются на разнообразных задачах и моделях поведения, наши выводы указывают на масштабируемый и вычислительно эффективный путь к возникновению кооперативного социального поведения с использованием стандартных методов децентрализованного обучения», — пишут они.
Поскольку опора на контекстную поведенческую адаптацию становится стандартом вместо жесткого кодирования строгих правил, человеческий элемент в инженерии ИИ кардинально изменится. «Роль разработчика ИИ-приложений может трансформироваться: от проектирования и управления отдельными правилами взаимодействия до разработки и обеспечения высокоуровневого архитектурного надзора за средой обучения», — отметил Мейлеманс. Этот переход возвышает разработчиков от написания узких сводов правил до стратегической роли, определяющей широкие параметры, которые гарантируют, что агенты научатся быть полезными, безопасными и готовыми к сотрудничеству в любой ситуации.




