


Метод SDFT от MIT повышает стабильность обучения больших языковых моделей (LLM)


Когда предприятия дорабатывают большие языковые модели (LLM) для новых задач, они рискуют разрушить все то, что модели уже знают. Это заставляет компании поддерживать отдельные модели для каждого конкретного навыка.
Исследователи из MIT, лаборатории Improbable AI и Высшей технической школы Цюриха (ETH Zurich) разработали новый метод, который позволяет большим языковым моделям осваивать новые навыки и знания, не утрачивая прежних возможностей.
Их методика, получившая название самодистилляционной донастройки (self-distillation fine-tuning, SDFT), позволяет моделям учиться напрямую на демонстрациях и собственных экспериментах за счет использования встроенных способностей к обучению в контексте (in-context learning), которыми обладают современные LLM. Эксперименты показывают, что SDFT стабильно превосходит традиционную донастройку с учителем (SFT), одновременно преодолевая ограничения алгоритмов обучения с подкреплением.
Для корпоративных приложений этот подход позволяет одной-единственной модели накапливать множество навыков с течением времени, избегая деградации производительности на предыдущих задачах. Это открывает потенциальный путь к созданию ИИ-агентов, способных адаптироваться к динамичной бизнес-среде и собирать новые профильные знания и навыки по мере необходимости — без необходимости дорогостоящих циклов переобучения или потери общих навыков рассуждения.
Проблема непрерывного обучения
Будучи обученной и развернутой, LLM остается статической. Она не обновляет свои параметры ради приобретения новых навыков, усвоения новой информации или совершенствования на основе опыта. Чтобы создать по-настоящему адаптивный искусственный интеллект, индустрии необходимо решить проблему «непрерывного обучения» (continual learning), позволяя системам накапливать знания точно так же, как это делают люди на протяжении всей своей карьеры.
Наиболее эффективный способ обучения моделей — это «обучение на собственной траектории» (on-policy learning). При таком подходе модель учится на данных, которые генерирует сама, что позволяет ей исправлять собственные ошибки и логику рассуждений. Это контрастирует с обучением путем простого копирования статических наборов данных. Без такого подхода модели подвержены «катастрофическому забыванию» — явлению, при котором изучение новой задачи приводит к тому, что модель утрачивает прежние знания и способность выполнять ранее освоенные операции.
Тем не менее, обучение на собственной траектории обычно требует обучения с подкреплением (reinforcement learning, RL), которое опирается на явную функцию вознаграждения для оценки результатов работы модели. Это отлично работает для задач с четкими результатами, таких как математика и программирование. Однако во многих реальных корпоративных сценариях (например, при составлении юридического заключения или резюме встречи) сформулировать математическую функцию вознаграждения сложно или вовсе невозможно.
Методы RL также часто дают сбой при попытке обучить модель совершенно новой информации — например, специфическому регламенту компании или новой линейке продуктов. Как рассказал изданию VentureBeat Идан Шенфельд (Idan Shenfeld), аспирант MIT и соавтор научной работы: «Сколько бы раз базовая модель ни пыталась, она не может выдать правильные ответы на тему, о которой у нее нет абсолютно никаких знаний», а значит, она никогда не получает положительного сигнала для обучения.
Стандартной альтернативой является донастройка с учителем (SFT), при которой модель обучается на фиксированном наборе экспертных демонстраций. Хотя SFT обеспечивает четкие эталонные данные, она изначально является «внеполитичной» (off-policy). Поскольку модель просто имитирует данные, а не учится на собственных попытках, она зачастую не способна обобщать примеры вне распределения (out-of-distribution) и сильно страдает от катастрофического забывания.
Метод SDFT призван преодолеть этот разрыв: обеспечить преимущества обучения на собственной траектории, используя только предварительно записанные демонстрации и обходясь без функции вознаграждения.
Как работает SDFT
SDFT решает эту задачу с помощью «дистилляции» — процесса, при котором модель-ученик учится подражать модели-учителю. Идея исследователей заключалась в том, чтобы задействовать собственные способности модели к «обучению в контексте» (ICL) для создания цикла обратной связи внутри одной и той же модели.
Обучение в контексте — это явление, при котором вы предоставляете LLM сложную задачу и одну или несколько демонстраций того, как решаются аналогичные проблемы. Большинство продвинутых LLM спроектированы так, чтобы решать новые задачи на основе примеров ICL без какого-либо обновления параметров.
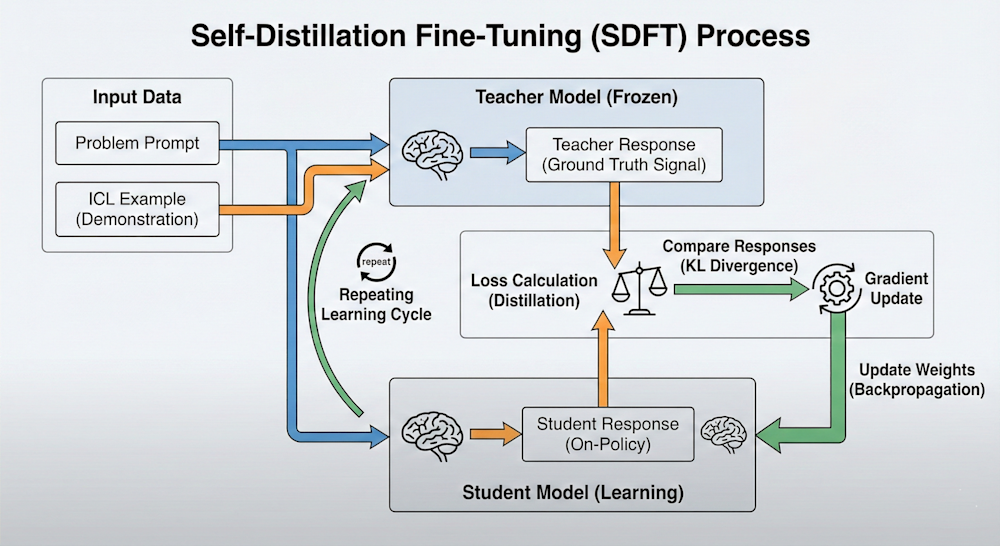
В ходе цикла обучения SDFT задействует модель в двух ролях.
Учитель: замороженной версии модели передается запрос вместе с экспертными демонстрациями. Используя ICL, учитель выводит правильный ответ и логику рассуждений, необходимую для его достижения.
Ученик: эта версия видит только запрос, имитируя сценарий реального развертывания, где ключ к разгадке отсутствует.
Когда ученик генерирует ответ, учитель, имеющий доступ к экспертным демонстрациям, предоставляет обратную связь. Затем ученик обновляет свои параметры, чтобы приблизиться к распределению учителя.
Этот процесс эффективно создает цикл обучения на собственной траектории, объединяя элементы SFT и RL. Контроль исходит не из статического набора данных, а из собственного взаимодействия модели и ее результатов. Это позволяет модели корректировать собственные траектории рассуждений без необходимости во внешнем сигнале вознаграждения. Данный процесс работает даже для новых знаний, которые обучение с подкреплением упустило бы.
SDFT в действии
Чтобы проверить этот подход, исследователи протестировали SDFT на базе модели с открытыми весами Qwen 2.5, оценив ее на трех сложных корпоративных навыках: научных вопросах и ответах, использовании программных инструментов и медицинских рассуждениях.
Результаты показали, что SDFT осваивает новые задачи эффективнее стандартных методов. На бенчмарке научных вопросов и ответов модель с SDFT достигла точности 70,2% по сравнению с 66,2% у стандартного подхода SFT.
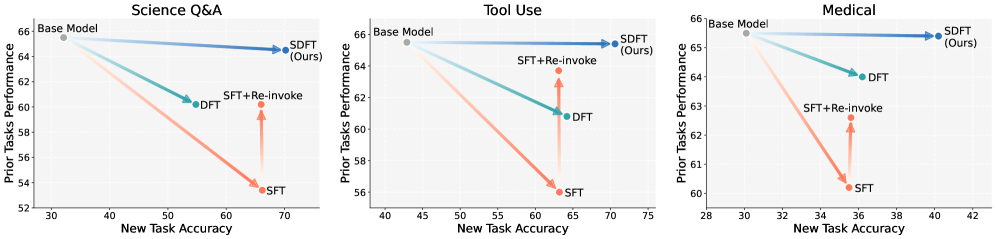
В отличие от SFT, SDFT сохраняет исходные знания модели при изучении новых задач и информации (источник: arXiv)
Еще более важным для внедрения в корпоративную среду является влияние на катастрофическое забывание. Когда модель со стандартным SFT осваивала научную задачу, ее способность отвечать на общие вопросы (например, по логике или гуманитарным наукам) резко падала. Напротив, модель с SDFT улучшила показатели в научной сфере, удерживая оценку по «Предыдущим задачам» на стабильном уровне 64,5%. Такая стабильность говорит о том, что компании могут специализировать модели под конкретные отделы (например, HR или юридический отдел) без ухудшения базового здравого смысла или аналитических способностей модели.
Команда также смоделировала сценарий внедрения знаний, создав набор данных о вымышленных «Природных катастрофах 2025 года», чтобы обучить модель новым фактам. Они протестировали модель на вопросах косвенного характера, таких как: «Учитывая наводнения 2025 года, каким странам, вероятно, потребовалась гуманитарная помощь?»
Стандартный SFT привел к созданию модели, которая механически заучила факты, но испытывала трудности с их использованием в сценариях логического вывода. Модель с SDFT, усвоившая логику в ходе обучения, набрала по тем же вопросам 98%.
Наконец, исследователи провели эксперимент по последовательному обучению, тренируя модель поочередно на научных задачах, использовании инструментов и медицинских кейсах. Если производительность стандартной модели колебалась, и она теряла прежние навыки по мере усвоения новых, то модель с SDFT успешно накопила все три навыка без регресса.
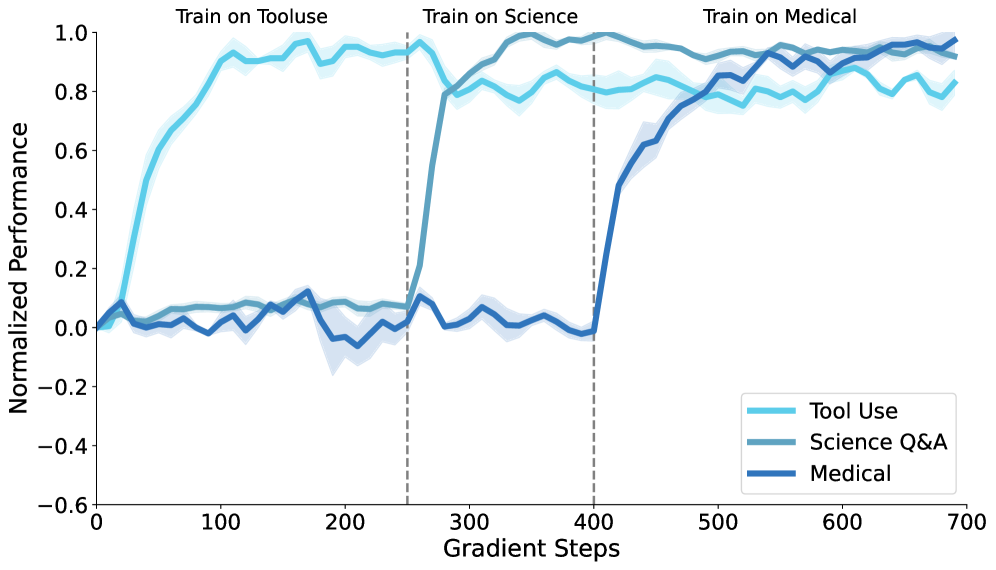
SDFT способна последовательно осваивать различные навыки, сохраняя при этом предыдущие знания (источник: arXiv)
Эта способность решает главную проблему предприятий, которые в настоящее время управляют «зоопарками моделей», состоящими из отдельных адаптеров для разных задач.
«Мы предлагаем возможность поддерживать всего одну модель для всех нужд компании», — отметил Шенфельд. Такая консолидация «может привести к существенному сокращению затрат на инференс», поскольку организациям не нужно одновременно удерживать в памяти множество моделей.
Ограничения и доступность SDFT
Код для SDFT опубликован на GitHub и готов к интеграции в существующие рабочие процессы обучения моделей.
«Конвейер SDFT больше похож на конвейер RL тем, что он требует генерации онлайн-ответов во время обучения», — пояснил Шенфельд. По его словам, исследователи работают с Hugging Face над интеграцией SDFT в их библиотеку Transformer Reinforcement Learning (TRL) и отмечают, что для разработчиков, желающих протестировать интеграцию, уже открыт пулл-реквест.
Для команд, рассматривающих SDFT, практические компромиссы сводятся к размеру модели и требуемым вычислительным мощностям. Технология требует моделей со способностью к обучению в контексте, достаточной для того, чтобы выступать в роли собственных учителей (на данный момент это около 4 миллиардов параметров для новых архитектур вроде Qwen 3, хотя Шенфельд ожидает скорого появления моделей на 1 миллиард параметров). Это требует примерно в 2,5 раза больше вычислительных ресурсов, чем стандартная донастройка, однако метод оптимально подходит для организаций, которым требуется одна модель для накопления множества навыков с течением времени — особенно в тех областях, где определение функции вознаграждения для обучения с подкреплением представляет собой сложную или невыполнимую задачу.
Хотя метод эффективен, он сопряжен с вычислительными издержками. SDFT работает примерно в четыре раза медленнее и требует в 2,5 раза больше вычислительной мощности (FLOPs), чем стандартная донастройка, поскольку модель должна активно генерировать собственные ответы («раунды генерации») в процессе обучения для сравнения с учителем. Тем не менее, исследователи отмечают, что благодаря лучшему сохранению знаний организации могут избежать дорогостоящих многоэтапных процессов переобучения, которые часто требуются для восстановления моделей, пострадавших от катастрофического забывания.
Метод также опирается на то, что базовая модель достаточно велика для извлечения выгоды из обучения в контексте. В статье отмечается, что меньшие модели (например, с 3 миллиардами параметров) поначалу испытывали трудности, поскольку им не хватало «интеллекта» для роли собственных учителей.
Тем не менее, по словам Шенфельда, стремительное совершенствование компактных моделей меняет эту динамику. «Модели Qwen 2.5 3B были слишком слабыми, но в ходе некоторых текущих экспериментов мы обнаружили, что модель Qwen 3 4B обладает достаточной мощностью, — сказал он. — Я вижу будущее, в котором даже модели на 1B будут обладать возможностями ICL, достаточными для поддержки SDFT».
В конечном счете цель состоит в том, чтобы выйти за рамки статических снапшотов и перейти к системам, которые совершенствуются в процессе использования.
«Обучение длиной в жизнь в сочетании со способностью извлекать обучающие сигналы из неструктурированного взаимодействия с пользователем… приведет к появлению моделей, которые будут непрерывно и непрерывно совершенствоваться со временем», — подчеркнул Шенфельд.
«Только вдумайтесь в тот факт, что уже сейчас большая часть вычислительных мощностей по всему миру уходит на инференс, а не на обучение. Мы должны найти способы задействовать эти вычисления для улучшения наших моделей».




