


OPCD от Microsoft повышает эффективность больших языковых моделей (LLM)


При создании приложений на базе больших языковых моделей (LLM) компаниям часто приходится писать очень длинные системные промпты, чтобы настроить поведение модели под свои задачи. Эти промпты содержат корпоративные знания, предпочтения и специфичные для приложения инструкции. В масштабах предприятия такие контексты могут увеличивать задержку инференса выше допустимых пороговых значений и существенно повышать стоимость каждого запроса.
Дистилляция контекста в рамках стратегии (On-Policy Context Distillation, OPCD) — новый метод обучения, предложенный исследователями из Microsoft, который позволяет «вшивать» знания и предпочтения приложений непосредственно в модель. OPCD использует собственные ответы модели в процессе обучения, что позволяет избежать некоторых подводных камней других методов. Это повышает возможности моделей для специализированных приложений при сохранении их общих навыков.
Почему длинные системные промпты становятся бременем
Контекстное обучение позволяет разработчикам изменять поведение модели во время инференса без модификации ее базовых параметров. Обновление параметров обычно представляет собой медленный и дорогостоящий процесс. Однако контекстные знания непостоянны. Они не переносятся между различными диалогами с моделью, а это значит, что вам приходится передавать ей один и тот же огромный набор инструкций или документов снова и снова. Для корпоративного приложения это может означать необходимость постоянно вставлять в промпт корпоративные правила, тикеты клиентов или объемные технические руководства. В конечном счете это замедляет работу модели, увеличивает затраты и может запутать систему.
«Предприятия часто используют длинные системные промпты для соблюдения правил безопасности (например, обнаружения языка вражды) или для предоставления специализированных знаний (например, в области медицины), — рассказал в комментариях для VentureBeat Тяньчжу Е (Tianzhu Ye), соавтор научной работы и исследователь из Microsoft Research Asia. — Тем не менее, пространные промпты значительно увеличивают вычислительные накладные расходы и задержку во время инференса».
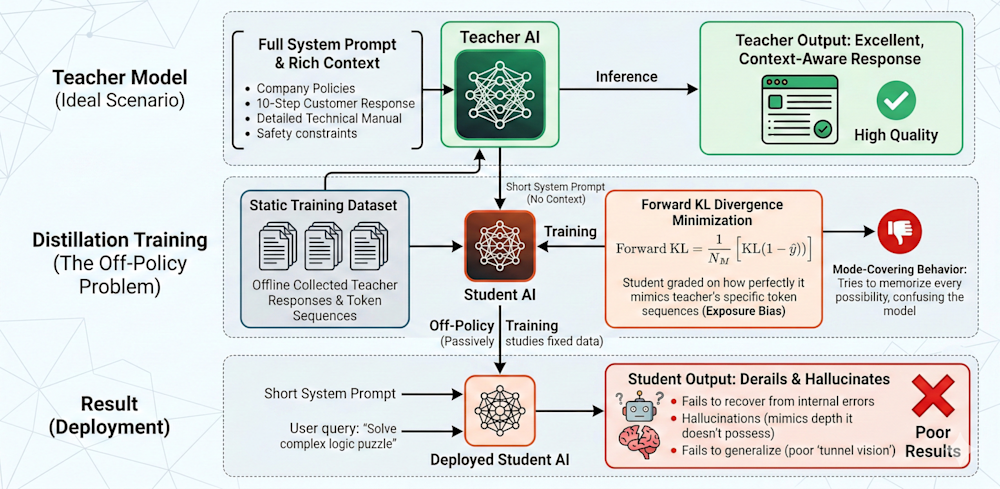
Основная идея дистилляции контекста заключается в обучении модели интернализации информации, которую вы регулярно добавляете в контекст. Как и другие методы дистилляции, она следует парадигме «учитель-ученик». Учитель — это ИИ-модель, которая получает массивный, детализированный промпт. Поскольку у нее есть все инструкции и справочные документы, она генерирует высокоспециализированные ответы. Ученик — это обучаемая модель, которая видит только основной вопрос и не имеет доступа к полному контексту. Ее задача сводится к тому, чтобы наблюдать за ответами учителя и учиться имитировать его поведение.
В ходе этого процесса обучения модель-ученик эффективно сжимает сложные инструкции из промпта учителя напрямую в свои параметры. Для предприятия главная выгода проявляется на этапе инференса. Поскольку модель-ученик усвоила контекст, ее можно развернуть в приложении без необходимости повторной вставки длинных инструкций. Это делает модель значительно быстрее и снижает вычислительные затраты.
Дистилляция контекста
Тем не менее, классическая дистилляция контекста опирается на несовершенный метод обучения, известный как «офполисное обучение» (off-policy training), при котором модель обучается на фиксированных датасетах, собранных до начала тренировки. Это создает ряд проблем. Во время обучения ученик сталкивается исключительно с эталонными данными и ответами, сгенерированными учителем, что приводит к возникновению так называемого «предвзятости воздействия» (exposure bias), о которой говорит Е. В продакшене модель должна самостоятельно подбирать последовательности токенов для достижения этих ответов. Поскольку она никогда не тренировалась принимать решения или исправлять собственные ошибки в процессе обучения, при самостоятельной работе она может легко дать сбой. Это похоже на ситуацию, когда студенту показывают видеозаписи с участием профессионального гонщика и ожидают, что он научится водить машину методом проб и ошибок.
Еще одна проблема связана с метрикой минимизации «прямой дивергенции Кульбака — Лейблера» (KL), используемой для обучения модели. В рамках этого метода модель оценивается по тому, насколько ее ответы похожи на ответы учителя, что, по словам Е, стимулирует поведение «покрытия мод» (mode-covering). Модель-ученик зачастую меньше по размеру или лишена того богатого контекста, которым обладал учитель, а значит, у нее просто нет ресурсов для идеального воспроизведения сложных рассуждений учителя. Поскольку ученика все равно заставляют пытаться охватить все эти возможности, его базовые предположения становятся избыточно широкими и расфокусированными.
В реальных приложениях это может приводить к галлюцинациям, когда ИИ теряется и уверенно выдумывает факты, пытаясь имитировать глубину знаний, которой на самом деле не обладает. Это также означает, что модель не способна эффективно обобщать информацию для новых задач.
Как OPCD решает проблему «учителя-ученика»
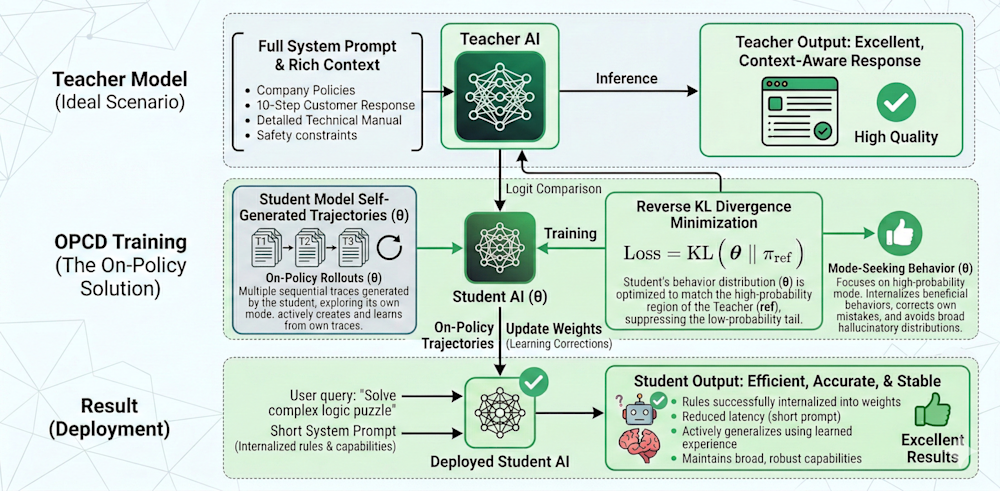
Чтобы устранить критические недостатки старой динамики «учитель-ученик», исследователи из Microsoft предложили метод онполисной дистилляции контекста (OPCD). Главное изменение в OPCD заключается в том, что модель-ученик обучается на собственных траекториях генерации, а не на статичном датасете (именно поэтому метод называется «онполисным» — on-policy). Вместо пассивного изучения набора данных с идеальными результатами учителя, ученику задают задачу без демонстрации массивного промпта с инструкциями, и он должен сгенерировать ответ полностью самостоятельно.
По мере того как ученик формирует ответ, учитель выполняет роль живого наставника. Учитель имеет доступ к полному кастомному промпту и оценивает результат работы ученика. На каждом шаге генерации система сопоставляет распределение токенов ученика с тем, как поступил бы контекстно-осведомленный учитель.
Онполисная дистилляция контекста
Для оценки ученика в OPCD используется «обратная дивергенция Кульбака — Лейблера». «Минимизация обратной дивергенции KL стимулирует поведение «поиска мод» (mode-seeking). Она концентрируется на областях распределения ученика с высокой вероятностью, — отметил Е. — Метод подавляет токены, которые ученик считает маловероятными, даже если учитель присваивал им высокую вероятность. Такое выравнивание помогает ученику исправлять собственные ошибки и избегать размытых, галлюцинаторных распределений, характерных для стандартной дистилляции».
Поскольку модель-ученик активно практикуется в принятии решений и учится исправлять собственные ошибки в ходе обучения, при развертывании в реальном приложении она ведет себя надежнее. Ей удается успешно встроить сложные бизнес-правила, ограничения безопасности или специализированные знания прямо в свою постоянную память.
Что дает OPCD: результаты бенчмарков
Исследователи протестировали OPCD в двух ключевых областях: дистилляция эмпирических знаний и дистилляция системных промптов. В случае с дистилляторм эмпирических знаний ученые хотели выяснить, способна ли LLM учиться на собственных прошлых победах и навсегда усваивать эти уроки. Проверка проводилась на моделях разного размера с использованием задач на математические рассуждения.
Сначала модель решала задачи и формулировала общие правила, извлеченные из своих успехов. Затем с помощью OPCD эти зафиксированные уроки внедрялись непосредственно в параметры модели. Результаты показали, что модели продемонстрировали резкий рост эффективности без необходимости передавать усвоенный опыт в промптах. На сложных математических задачах модель с 8 миллиардами параметров улучшила свой показатель с базовых 75,0% до 80,9%. Например, в игре на навигацию Frozen Lake небольшая модель с 1,7 миллиарда параметров изначально имела показатель успешности 6,3%. После того как OPCD внедрила полученный опыт, точность подскочила до 38,3%.
Вторая серия экспериментов была посвящена длинным системным промптам. Компании часто задействуют масштабные системные промпты для обеспечения строгих стандартов поведения, таких как поддержание профессионального тона, медицинская точность или фильтрация токсичной лексики. Исследователи проверили, может ли OPCD навсегда «вшить» эти жесткие поведенческие правила в модели, избавив от необходимости отправлять их с каждым пользовательским запросом. Эксперименты показали, что OPCD успешно интернализировала эти сложные правила и колоссально повысила производительность. При тестировании трехмиллиардной модели Llama на задачах классификации безопасности и токсичности базовая модель набрала 30,7%. После применения OPCD для интернализации промпта безопасности ее точность подскочила до 83,1%. В сфере ответа на медицинские вопросы та же модель улучшила результат с 59,4% до 76,3%.
Одной из главных трудностей при тонкой настройке моделей является катастрофическое забывание, при котором модель излишне концентрируется на задаче дообучения и хуже справляется с общими задачами. Чтобы проверить наличие такого «туннельного зрения», исследователи отслеживали производительность вне основного распределения (out-of-distribution). После внедрения строгих правил безопасности в модель они немедленно проверяли ее способность отвечать на не связанные с медициной вопросы. OPCD успешно сохранила общие медицинские знания модели, превзойдя старые офполисные методы примерно на 4 процентных пункта. Она смогла специализироваться, не потеряв при этом свой более широкий интеллект.
Где OPCD применима, а где — нет
Хотя OPCD представляет собой мощный инструмент для интернализации статических знаний и сложных правил, она не заменяет все методы работы с внешним контекстом. «RAG лучше подходит тогда, когда требуемая информация является крайне динамичной или связана с огромной, часто обновляемой внешней базой данных, которую невозможно сжать в веса модели», — пояснил Е.
Для корпоративных команд, оценивающих свои конвейеры обработки данных, внедрение OPCD не потребует капитальной перестройки существующих систем или инвестиций в специализированное железо. «OPCD можно интегрировать в уже имеющиеся рабочие процессы с минимальным сопротивлением, — говорит Е. — Любая команда, которая уже использует стандартные конвейеры RLVR [обучения с подкреплением на основе проверяемых наград], способна внедрить OPCD без масштабных архитектурных изменений».
На практике модель-ученик выполняет роль политики (policy), осуществляющей генерацию, в то время как замороженная модель-учитель выступает в качестве справочника, предоставляющего логиты. Требования к аппаратному обеспечению вполне доступны. По словам Е, корпоративные команды могут воспроизвести эксперименты исследователей, используя около восьми графических процессоров A100.
Требования к данным также невелики. Для дистилляции эмпирических знаний разработчикам требуется всего около 30 начальных примеров для генерации траекторий решений. Поскольку метод применяется к ранее неоптимизированным средам, даже небольшой объем данных обеспечивает основной прирост производительности. Для дистилляции системных промптов достаточно существующих оптимизированных промптов и стандартных датасетов задач.
Исследователи создали собственную реализацию на базе verl — кодовой базы RLVR с открытым исходным кодом, — доказав, что этот подход органично вписывается в традиционные фреймворки обучения с подкреплением. Они планируют выпустить свою реализацию в открытый доступ после прохождения внутренних проверок.
Самосовершенствующаяся модель: что ждет нас дальше
В перспективе OPCD прокладывает путь к по-настоящему самосовершенствующимся моделям, которые непрерывно адаптируются к особенностям корпоративной среды. После развертывания модель сможет извлекать уроки из реальных взаимодействий и использовать OPCD для постепенной интернализации этих характеристик без необходимости ручного надзора или разметки данных со стороны тренеров.
«Это знаменует собой фундаментальный сдвиг парадигмы в деле совершенствования моделей: основные улучшения переносятся с этапа обучения на этап тестирования, — подчеркнул Е. — Использование модели и предоставление ей возможности собирать опыт станут главным драйвером ее прогресса».




