


Трехкратное увеличение пропускной способности в моделях ИИ


Поскольку агентские рабочие процессы на основе ИИ многократно увеличивают затраты и задержки при длинных цепочках рассуждений, команда из Мэрилендского университета, Ливерморской национальной лаборатории имени Лоуренса, Колумбийского университета и TogetherAI нашла способ встроить трехкратное ускорение пропускной способности прямо в веса модели.
В отличие от спекулятивного декодирования, требующего отдельной модели-черновика, этот подход не нуждается в дополнительной инфраструктуре — нужен лишь один специальный токен, добавленный в существующую архитектуру модели.
Ограничения прогнозирования следующего токена
Прогнозирование следующего токена — генерация текста по одному токену за один проход вперед — создает предел пропускной способности, который становится катастрофически дорогим, когда модельм требуется выдавать тысячи токенов. Это «бутылочное горлышко» особенно проблематично для моделей рассуждений, которые перед формированием финального ответа часто генерируют тысячи токенов «цепочки рассуждений», что приводит к медленному и дорогостоящему взаимодействию для пользователя.
Многотокенное прогнозирование (Multi-token prediction, MTP) предлагает альтернативную парадигму обучения, которая позволяет языковой модели генерировать несколько токенов одновременно за один прямой проход. Например, модель можно обучить предсказывать блок токенов целиком, а не только самый первый следующий токен.
Джон Кирхенбауэр (John Kirchenbauer), аспирант кафедры компьютерных наук Мэрилендского университета и соавтор научной работы, рассказал VentureBeat, что по мере перехода к агентским рабочим процессам фокус смещается с общей пропускной способности на скорость для одного пользователя. «Сегодня, когда сверхдлинные цепочки размышлений стали нормой, а агентские внешние циклы еще больше увеличивают эти затраты, задержка становится столь же важным аспектом общей эффективности обслуживания, как и валовые токены в секунду на единицу оборудования (tps/GPU)», — отметил Кирхенбауэр. По его словам, в то время как стандартное пакетное прогнозирование следующего токена уже оптимально для общей пропускной способности, новый подход «стремится загрузить графический процессор запросом всего одного пользователя, чтобы снизить задержку именно для него».
Существуют и другие методы, но у них есть свои недостатки. «Стоит отметить, что и спекулятивное декодирование, и диффузионные LLM в качестве ориентированной на эффективность альтернативы прогнозированию следующего токена (NTP) являются методами ускорения с упором на задержку», — пояснил Кирхенбауэр. Однако спекулятивное декодирование требует развертывания и управления вспомогательной «черновой» моделью, которая тратит больше абсолютных вычислительных ресурсов на создание и верификацию черновика. MTP же, с другой стороны, «использует похожий компромисс, но проще в реализации и представляет научный интерес сам по себе».
Тем не менее, современные парадигмы MTP имеют ограничения. Стандартная цель обучения языковой модели для MTP заключается в сопоставлении ее прогнозов с эталонным текстом из набора данных. Подводный камень заключается в том, что такое стандартное обучение учит модель независимо предсказывать вероятность токена в определенной позиции, а не заботиться о совместной взаимосвязи между последовательностью токенов.
Если модель пытается предсказать несколько токенов одновременно с помощью этого стандартного метода, возникают две серьезные проблемы. Первая — грамматическое несоответствие. Например, если модель предсказывает два слова после префикса «Зоотехник покормил», она может выбрать их независимо и выдать несогласованную фразу вроде «панду мясом» или «льва бамбуком» вместо «панду бамбуком» и «льва мясом».
Вторая проблема — вырожденное повторение. Поскольку типичный текст непредсказуем, модель, пытающаяся предсказать токен на 100 позиций вперед на основе стандартного набора данных, будет просто выдавать «и» или «в», поскольку это самые частые слова. В результате модель выдает бессмыслицу вроде «…и и и…» для отдаленных позиций.
Многотокенное прогнозирование через самодистилляцию
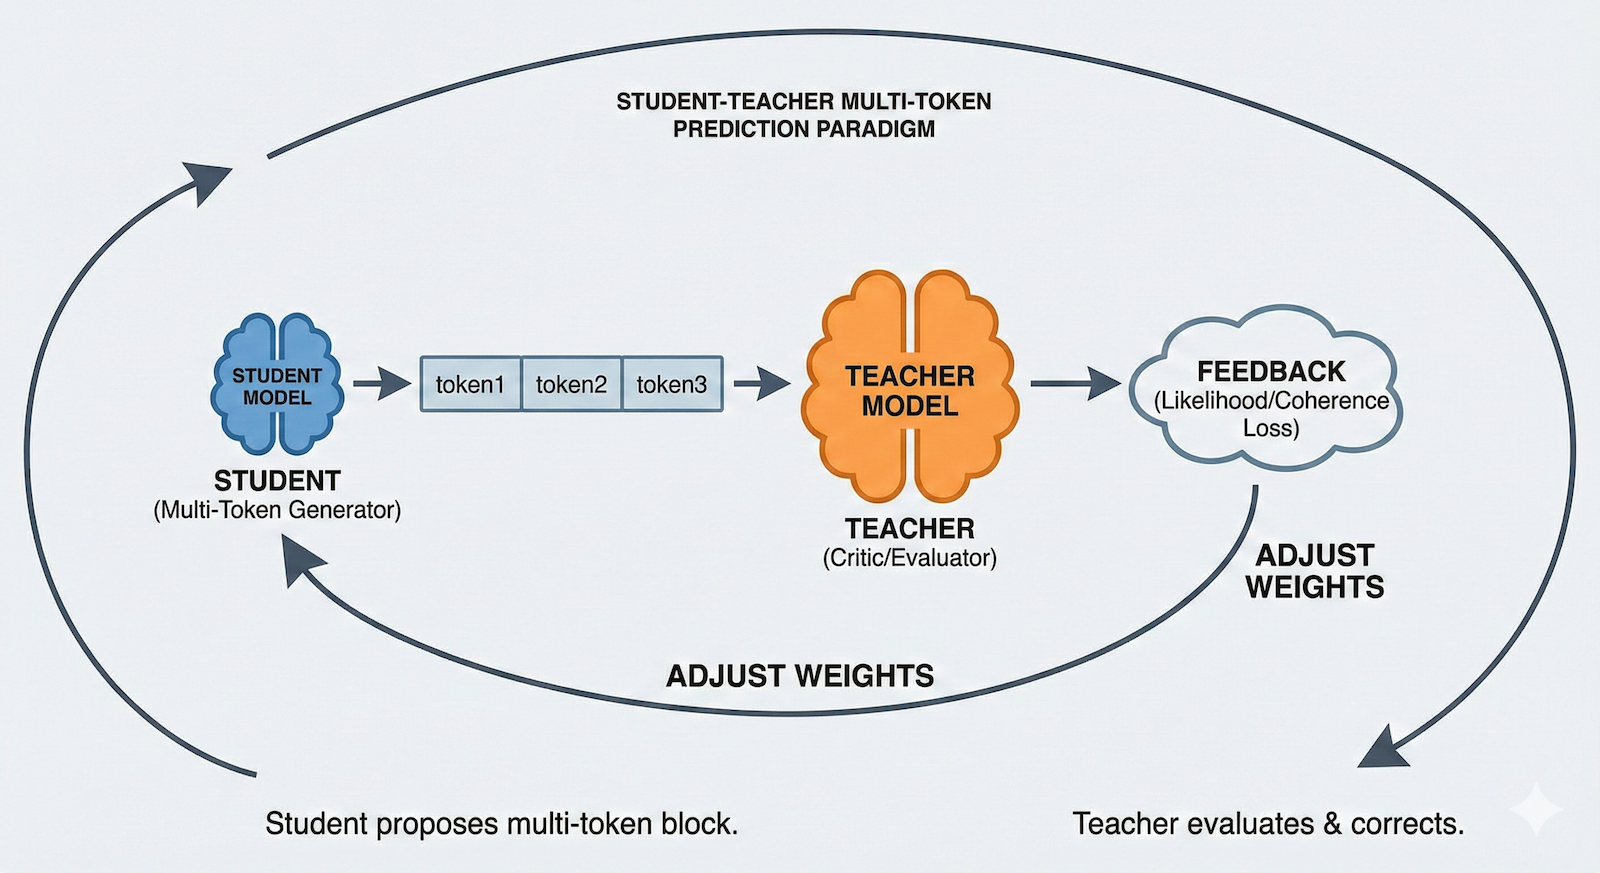
Чтобы решить проблемы генерации нескольких токенов, исследователи предлагают новый метод обучения, использующий схему «учитель-ученик». Модель-ученик (та, что учится предсказывать несколько токенов) генерирует детерминированный многотокенный блок. Модель-учитель, выступающая в роли мощной стандартной языковой модели прогнозирования следующего токена, оценивает этот блок. Учитель играет роль критика, вычисляя, насколько вероятной и когерентной является предложенная учеником последовательность. Если ученик предлагает несогласованную фразу вроде «льва бамбуком», учитель присваивает ей высокий уровень потерь (loss), обучая ученика избегать подобных конструкций.
Изображение предоставлено: VentureBeat с использованием Nano Banana Pro
Эта парадигма вдохновлена обучением с подкреплением на основе актуальной политики (on-policy reinforcement learning), поскольку модель-ученик не просто заучивает статический текст. Она мгновенно генерирует полный набор шагов (последовательность действий на языке RL) параллельно за один прямой проход и получает вознаграждение в зависимости от того, насколько удачным этот результат считает учитель. В отличие от статических методов с учителем, где обучающие пары фиксируются заранее, обратная связь здесь динамична и генерируется на основе собственных выводов ученика в реальном времени. Кроме того, сильный учитель проверяет когерентность токенов, что мешает модели-ученику выдавать вырожденные результаты вроде повторяющихся слов.
Для разработчиков прелесть этого подхода заключается в его простоте. «В архитектуру действительно не вносится никаких изменений, кроме добавления специального токена», — сказал Кирхенбауэр. Задействуя неиспользуемый слот в существующей матрице эмбеддингов модели в качестве маски токена
Для инженерных команд это означает, что адаптацию можно применять к моделям, уже находящимся в продакшене, без перестройки конвейеров.
Изображение предоставлено: VentureBeat с использованием Nano Banana Pro
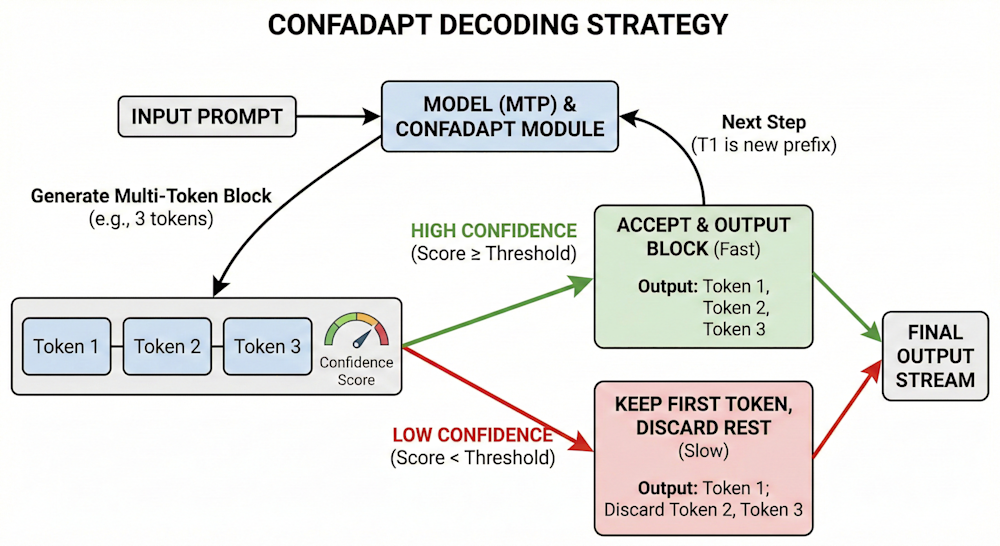
Одновременная генерация нескольких токенов все же может снижать точность ответа на этапе инференса. Чтобы максимизировать скорость генерации без ущерба для качества вывода, авторы представляют адаптивную стратегию декодирования под названием ConfAdapt.
ConfAdapt оценивает порог уверенности (например, 90%) на каждом шаге. Модель генерирует блок токенов, но сохраняет только те из них, которые достигают этого высокого порога уверенности или превышают его. Когда будущий текст легко предсказывается или имеет структурный характер, уверенность модели очень высока. Она принимает и выдает большой кусок токенов сразу, экономя значительное время вычислений на простых токенах. Затем она направляет свои дорогостоящие проходы по одному токену на более сложные участки, требующие больших вычислительных затрат.
Испытание многотокенного прогнозирования
Чтобы проверить, как эта парадигма обучения работает на практике, исследователи применили свой метод к популярным моделям с открытыми весами и инструктивной настройкой. Они протестировали мощную универсальную модель Llama-3.1-8B-Magpie и более компактную и эффективную Qwen3-4B-Instruct-2507, которую часто выбирают для развертывания на предприятиях с ограниченным бюджетом. Обе модели были дообучены на MetaMathQA — наборе данных синтетических математических задач начальной школы, которые в значительной степени опираются на цепочки рассуждений.
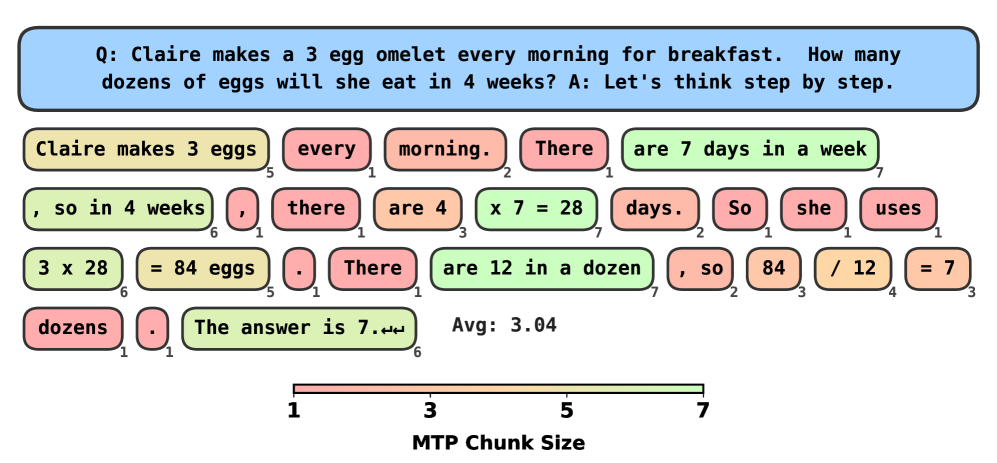
Пример многотокенных блоков, сгенерированных с помощью ConfAdapt (источник: arXiv)
Эксперименты выявили четкий баланс между скоростью и точностью. Используя стратегию ConfAdapt, модель Llama-3.1-8B достигла трехкратного ускорения при падении точности на математических бенчмарках менее чем на 3%. Модель Qwen3-4B добилась такого же трехкратного ускорения при чуть более существенном падении точности на 7%. Более агрессивные настройки могли обеспечить пятикратное ускорение, хотя и сопровождались более сильным снижением точности.
То, как это отражается на реальных задачах, зависит от предсказуемости. «Поскольку подход ConfAdapt естественным образом подстраивает ускорение под присущую домену энтропию, когда модель точно „знает“, что будет дальше, она может выдать это за один проход», — отметил он, что приводит к колоссальному ускорению на предсказуемых задачах при одновременном использовании большего числа шагов для неопределенных результатов.
Прирост скорости также переносился на домены, которые не были включены в фазу обучения многотокенному прогнозированию. Сюда вошли как задачи из той же области, что и обучающие данные (математика и рассуждения), так и открытые задачи вроде творческого письма и суммаризации.
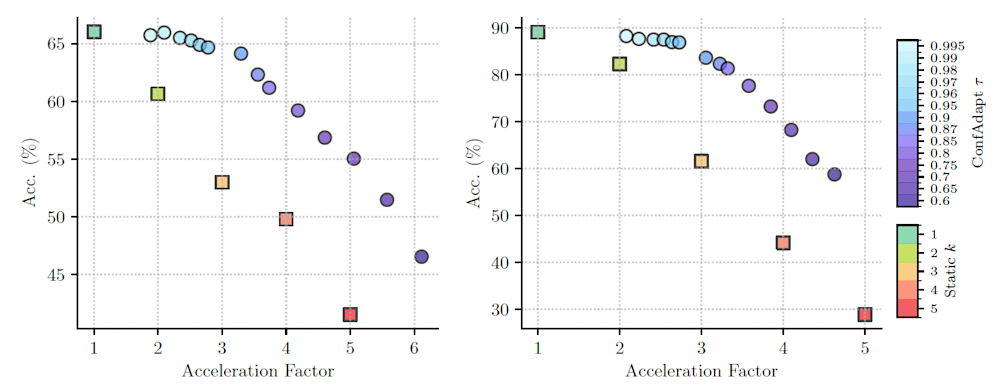
Оптимальная точка (sweet spot) для MTP с ConfAdapt составляет около 3х ускорения (источник: arXiv)
Несмотря на такой перенос обучения, предприятиям, развертывающим эти модели для специализированных задач, не стоит полагаться на него всецело. «Наша рекомендация заключается в том, чтобы настраивать или адаптировать модель для MTP, используя образцы из конкретной промышленной сферы», — сказал Кирхенбауэр. «Наилучшая производительность, вероятнее всего, достигается тогда, когда адаптация MTP выполняется с использованием промптов из целевого домена развертывания».
Совместимость с инфраструктурой и дальнейшие шаги
Исследовательская группа опубликовала свои обученные модели на Hugging Face и вскоре выпустит код своего фреймворка MTP. Инфраструктурным командам, интегрирующим эти модели в vLLM или SGLang, потребуется учесть изменения в том, как обрабатываются батчинг (батчирование) и кэширование ключей-значений (KV-кэш), но это единовременная инженерная инвестиция, а не постоянная нагрузка. Тем не менее, Кирхенбауэр не видит «явных препятствий для интеграции» и подтвердил, что команда «работает с экспертами по системам над поиском кратчайшего пути для интеграции».
Совет Кирхенбауэра командам, желающим протестировать выпущенные модели: начните с простых тестовых промптов, таких как счет или повторение фразы, чтобы увидеть прирост производительности ConfAdapt в действии, а затем адаптируйте модель, используя образцы из вашей конкретной предметной области для достижения наилучших результатов. «В целом мы ожидаем, что готовая к продакшену реализация нашего подхода сможет упростить жизненный цикл создания и развертывания низколатентных агентских моделей», — подытожил Кирхенбауэр. «В то время как существующие методы ускорения для моделей NTP сосредоточены почти исключительно на средствах инференса и логики, наш подход просто встраивает часть сложности в саму модель, что делает его в значительной степени взаимодополняющим по отношению к существующим разработкам».




