PageIndex переосмысляет концепцию RAG с помощью древовидного поиска
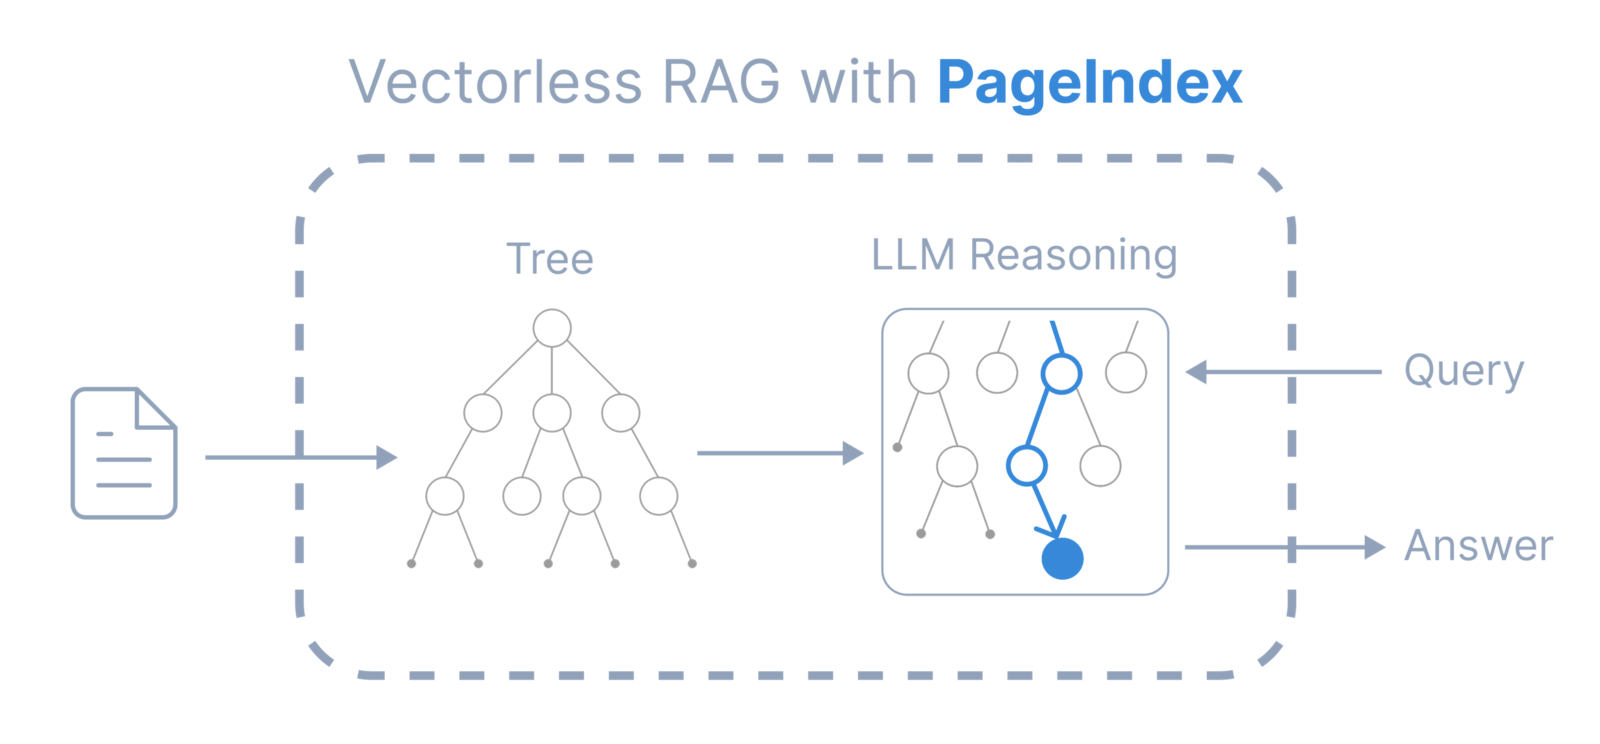


Новый фреймворк с открытым исходным кодом под названием PageIndex решает одну из давних проблем генерации с дополненной выборкой (RAG) — обработку очень длинных документов.
Классический рабочий процесс RAG (разбиение документов на фрагменты, вычисление эмбеддингов, их сохранение в векторной базе данных и извлечение наиболее подходящих совпадений на основе семантического сходства) отлично работает для базовых задач, таких как ответы на вопросы по небольшим документам.
PageIndex полностью отказывается от стандартного метода «разбей на фрагменты и получи эмбеддинги» и рассматривает поиск по документам не как задачу поиска, а как задачу навигации.
Однако по мере того, как предприятия пытаются внедрить RAG в критически важные рабочие процессы — аудит финансовой отчетности, анализ юридических контрактов, изучение фармацевтических протоколов — они сталкиваются с барьером точности, который оптимизация фрагментов преодолеть не может.
AlphaGo для документов
PageIndex устраняет эти ограничения, заимствуя концепцию из игрового искусственного интеллекта, а не из поисковых систем: поиск по дереву.
Когда людям необходимо найти конкретную информацию в плотном учебнике или длинном годовом отчете, они не сканируют каждый абзац линейно. Они заглядывают в оглавление, чтобы определить нужную главу, затем раздел и, наконец, конкретную страницу. PageIndex заставляет LLM воспроизводить это поведение человека.
Вместо предварительного вычисления векторов фреймворк строит «глобальный индекс» структуры документа, создавая дерево, где узлы представляют главы, разделы и подразделы. Когда поступает запрос, LLM выполняет поиск по дереву, явно классифицируя каждый отдельный узел как релевантный или нерелевантный на основе полного контекста запроса пользователя.
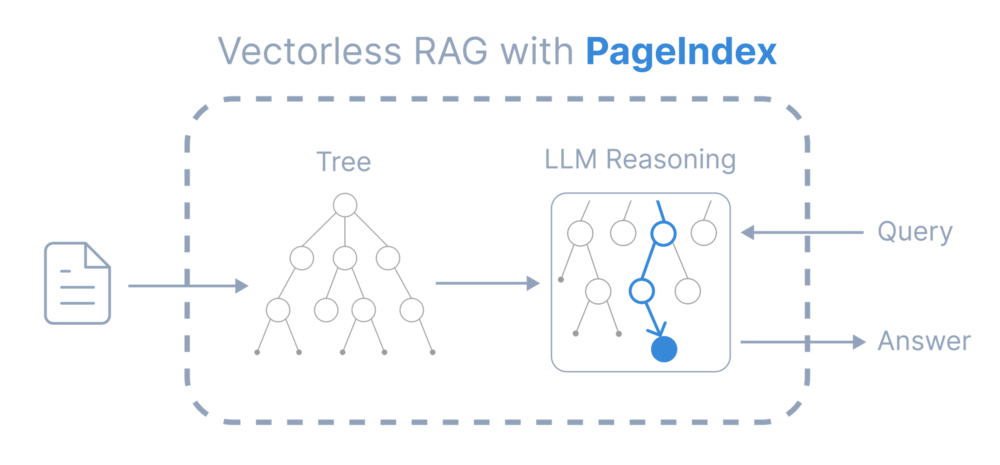
Как работает PageIndex (источник: PageIndex на GitHub)
«С точки зрения компьютерных наук оглавление — это древовидное представление документа, а навигация по нему соответствует поиску по дереву», — пояснил Чжан. — PageIndex применяет ту же основную идею — поиск по дереву — к поиску документов, и его можно рассматривать как систему в стиле AlphaGo для извлечения информации, а не для игр».
Это смещает архитектурную парадигму от пассивного поиска, при котором система просто извлекает совпадающий текст, к активной навигации, где агентная модель сама решает, куда заглянуть.
Пределы семантического сходства
В том, как традиционный RAG работает со сложными данными, заложен фундаментальный изъян. Векторный поиск предполагает, что текст, наиболее семантически близкий к запросу пользователя, является и наиболее релевантным. В профессиональных сферах это предположение часто нарушается.
Минтянь Чжан (Mingtian Zhang), соучредитель PageIndex, называет финансовую отчетность ярким примером такого сбоя. Если финансовый аналитик спрашивает ИИ об «EBITDA» (прибыль до вычета процентов, налогов, износа и амортизации), стандартная векторная база данных извлечет каждый фрагмент, где встречается эта аббревиатура или похожий термин.
«Несколько разделов могут упоминать EBITDA с похожей формулировкой, но только один раздел определяет точный расчет, корректировки или рамки отчетности, относящиеся к вопросу, — рассказал Чжан изданию VentureBeat. — Поисковой системе на основе сходства трудно различить эти случаи, поскольку семантические сигналы практически неотличимы друг от друга».
Это разрыв между «намерением» и «содержимым». Пользователь хочет не просто найти слово «EBITDA», он хочет понять стоящую за ним «логику» для конкретного квартала.
Кроме того, традиционные эмбеддинги лишают запрос контекста. Поскольку модели эмбеддингов имеют строгие ограничения на длину входных данных, поисковая система обычно видит только задаваемый в данный момент вопрос, игнорируя предыдущие шаги беседы. Это отрывает этап поиска от процесса рассуждения пользователя. Система сопоставляет документы с коротким деконтекстуализированным запросом, а не со всей историей проблемы, которую пользователь пытается решить.
Решение проблемы многошаговых рассуждений
Реальное влияние такого структурного подхода наиболее заметно в «многошаговых» запросах, требующих от ИИ прохождения по следам информации в разных частях документа.
В недавнем тесте под названием FinanceBench система на базе PageIndex под названием «Mafin 2.5» достигла передового показателя точности в 98,7%. Разница в производительности между этим подходом и векторными системами становится очевидной при анализе того, как они обрабатывают внутренние перекрестные ссылки.
Чжан приводит в пример запрос об общей стоимости отложенных активов в годовом отчете Федеральной резервной системы. В основном разделе отчета описывается «изменение» стоимости, но не указана общая сумма. Однако в тексте есть сноска: «Более подробную информацию см. в Приложении G к данному отчету…».
Векторная система в таком случае обычно терпит неудачу. Текст в Приложении G совсем не похож на запрос пользователя об отложенных активах; скорее всего, это просто таблица с цифрами. Поскольку семантического совпадения нет, векторная база данных ее игнорирует.
Однако поисковая система на основе рассуждений считывает подсказку в основном тексте, переходит по структурной ссылке в Приложение G, находит правильную таблицу и возвращает точный показатель.
Компромисс с задержкой и изменение инфраструктуры
Для корпоративных архитекторов главной заботой при использовании процесса поиска на базе LLM является задержка (latency). Векторный поиск происходит за миллисекунды; ситуация, когда LLM «читает» оглавление, подразумевает значительно более медленное взаимодействие с пользователем.
Тем не менее Чжан объясняет, что воспринимаемая конечным пользователем задержка может быть ничтожно мала из-за того, как поиск интегрирован в процесс генерации. В классической настройке RAG поиск является блокирующим шагом: система должна выполнить поиск по базе данных, прежде чем сможет начать генерировать ответ. В PageIndex поиск происходит инлайн — непосредственно в процессе рассуждения модели.
«Система может начать выдавать текст в реальном времени (стримить) и осуществлять поиск по ходу генерации, — сказал Чжан. — Это означает, что PageIndex не добавляет лишний «поисковый шлюз» перед первым токеном, а время до первого токена (TTFT) сопоставимо с обычным вызовом LLM».
Этот архитектурный сдвиг также упрощает инфраструктуру данных. Отказавшись от зависимости от эмбеддингов, предприятия больше не нуждаются в поддержке выделенной векторной базы данных. Древовидный индекс достаточно легковесен, чтобы поместиться в традиционной реляционной базе данных вроде PostgreSQL.
Это решает насущную проблему систем LLM с компонентами поиска: сложность поддержания векторных хранилищ в актуальном состоянии при изменении документов. PageIndex отделяет индексацию структуры от извлечения текста. Если в контракт вносятся поправки или обновляется политика, система может обрабатывать небольшие правки путем переиндексации только затронутого поддерева, а не переработки всего массива документов.
Матрица принятия решений для бизнеса
Хотя прирост точности впечатляет, поиск по дереву не является универсальной заменой векторного поиска. Эту технологию лучше рассматривать как специализированный инструмент для «глубокой работы», а не как панацею для любой поисковой задачи.
Для коротких документов, таких как электронные письма или журналы чатов, весь контекст часто умещается в окне контекста современной LLM, из-за чего любая поисковая система становится ненужной. И наоборот, для задач, основанных исключительно на семантическом обнаружении (например, рекомендация похожих продуктов или поиск контента с определенной «атмосферой»), векторные эмбеддинги остаются предпочтительным выбором, поскольку целью является близость, а не рассуждения.
PageIndex идеально занимает нишу посередине: длинные, высокоструктурированные документы с высокой ценой ошибки. К ним относятся технические руководства, заявки в FDA и соглашения о слиянии. В таких сценариях ключевым требованием является проверяемость (аудируемость). Корпоративная система должна уметь объяснять не только сам ответ, но и путь, который она проделала для его поиска (например, подтвердить, что она проверила Раздел 4.1, последовала ссылке на Приложение B и синтезировала найденные там данные).
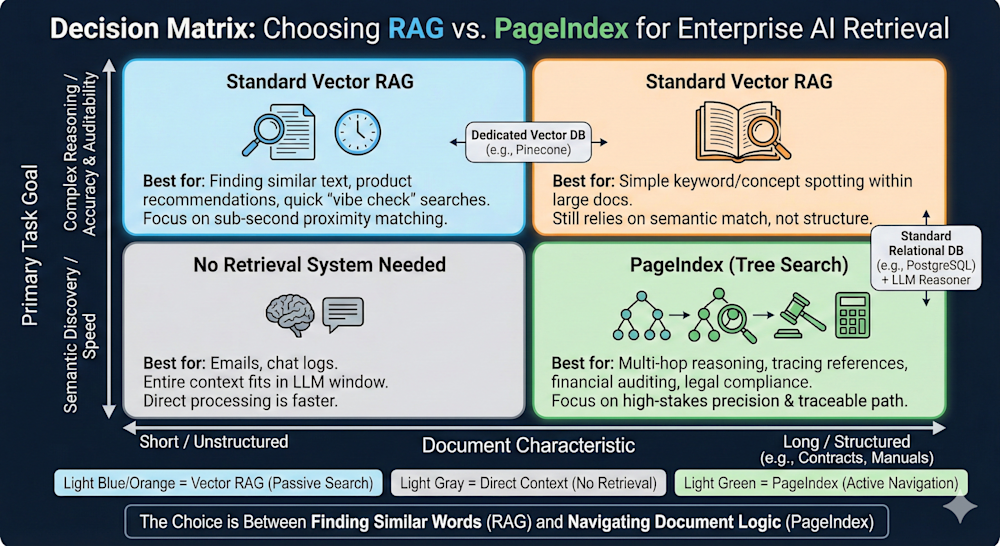
Источник изображения: VentureBeat совместно с Nano Banana Pro
Будущее агентного поиска
Появление таких фреймворков, как PageIndex, сигнализирует о более широкой тенденции в стеке технологий ИИ: переходе к «агентному RAG» («Agentic RAG»). По мере того как модели становятся все более способными к планированию и рассуждениям, ответственность за поиск данных смещается со слоя базы данных на слой самой модели.
Мы уже наблюдаем это в сфере программирования, где такие агенты, как Claude Code и Cursor, отходят от простого векторного поиска в пользу активного изучения кодовой базы. Чжан считает, что общий поиск по документам пойдет по той же траектории.
«У векторных баз данных по-прежнему есть подходящие сценарии использования, — отметил Чжан. — Но их историческая роль базы данных по умолчанию для LLM и ИИ со временем станет менее очевидной».