


Новая техника промптинга от Meta значительно повышает качество проверки кода языковыми моделями: в некоторых случаях точность возрастает до 93%


Развертывание ИИ-агентов для задач репозиторного масштаба, таких как обнаружение багов, верификация патчей и анализ кода, требует преодоления серьезных технических препятствий. Одна из главных проблем — необходимость настраивать динамические среды изоляции (песочницы) для каждого репозитория, что дорого и ресурсоемко.
Чтобы обойти эти накладные расходы, вместо выполнения кода все большую популярность приобретает использование рассуждений на базе больших языковых моделей (LLM), однако это часто приводит к необоснованным предположениям и галлюцинациям.
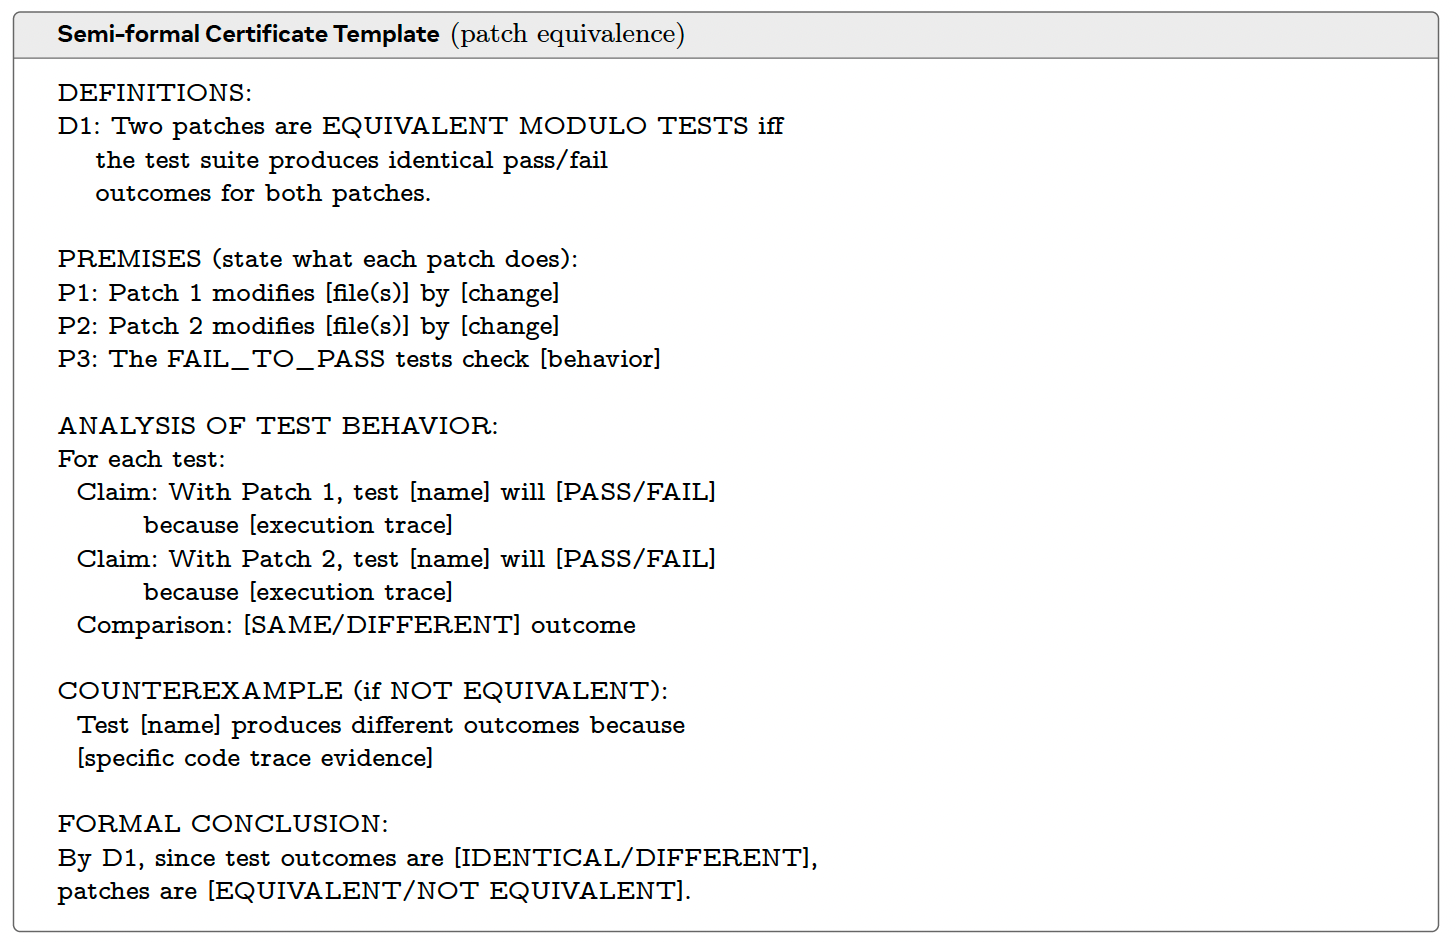
Для улучшения рассуждений без выполнения кода исследователи из Meta представляют «полуформальные рассуждения» (semi-formal reasoning) — структурированный подход к промптингу. Этот метод требует, чтобы ИИ-агент заполнял логический сертификат, явно указывая предпосылки, прослеживая конкретные пути выполнения и выводя формальные заключения перед выдачей ответа.
Структурированный формат заставляет агента систематически собирать доказательства и следовать вызовам функций перед тем, как делать выводы. Это повышает точность LLM в задачах программирования и существенно снижает количество ошибок при локализации сбоев и ответах на вопросы по кодовой базе.
Для разработчиков, использующих LLM в задачах код-ревью, полуформальные рассуждения обеспечивают высоконадежный семантический анализ кода без его выполнения, одновременно кардинально снижая инфраструктурные затраты систем программирования на базе ИИ.
Агентные рассуждения о коде
Агентные рассуждения о коде — это способность ИИ-агента ориентироваться в файлах, отслеживать зависимости и итеративно собирать контекст для проведения глубокого семантического анализа кодовой базы без запуска самого кода. В корпоративных ИИ-приложениях эта способность критически важна для масштабирования автоматического обнаружения багов, комплексного код-ревью и верификации патчей в сложных репозиториях, где актуальный контекст охватывает множество файлов.
В настоящее время индустрия решает задачу верификации кода без его выполнения с помощью двух основных подходов. Первый включает в себя неструктурированные оценщики на базе LLM, которые пытаются верифицировать код либо напрямую, либо путем обучения специализированных LLM в качестве моделей вознаграждения для аппроксимации результатов тестирования. Главный недостаток заключается в их опоре на неструктурированные рассуждения, что позволяет моделям делать уверенные заявления о поведении кода без явного обоснования. Без структурных ограничений сложно гарантировать, что агенты рассуждают тщательно, а не угадывают на основе поверхностных паттернов, вроде имен функций.
Второй подход предполагает формальную верификацию, которая переводит код или рассуждения на формальные математические языки вроде Lean, Coq или Datalog для автоматической проверки доказательств. Будучи строгими, формальные методы требуют определения семантики самого языка программирования. Это совершенно непрактично для произвольных корпоративных кодовых баз, охватывающих множество фреймворков и языков.
Существующие подходы также склонны быть сильно фрагментированными и узкоспециализированными, часто требуя совершенно отдельной архитектуры или специализированного обучения для каждой новой проблемной области. Им не хватает гибкости, необходимой для широких многоцелевых корпоративных приложений.
Как работают полуформальные рассуждения
Чтобы преодолеть разрыв между неструктурными предположениями и излишне жесткими математическими доказательствами, исследователи из Meta предлагают методологию структурированного промптинга, которую они называют «полуформальными рассуждениями». Этот подход наделяет LLM-агентов специализированными для конкретных задач структурированными шаблонами рассуждений.
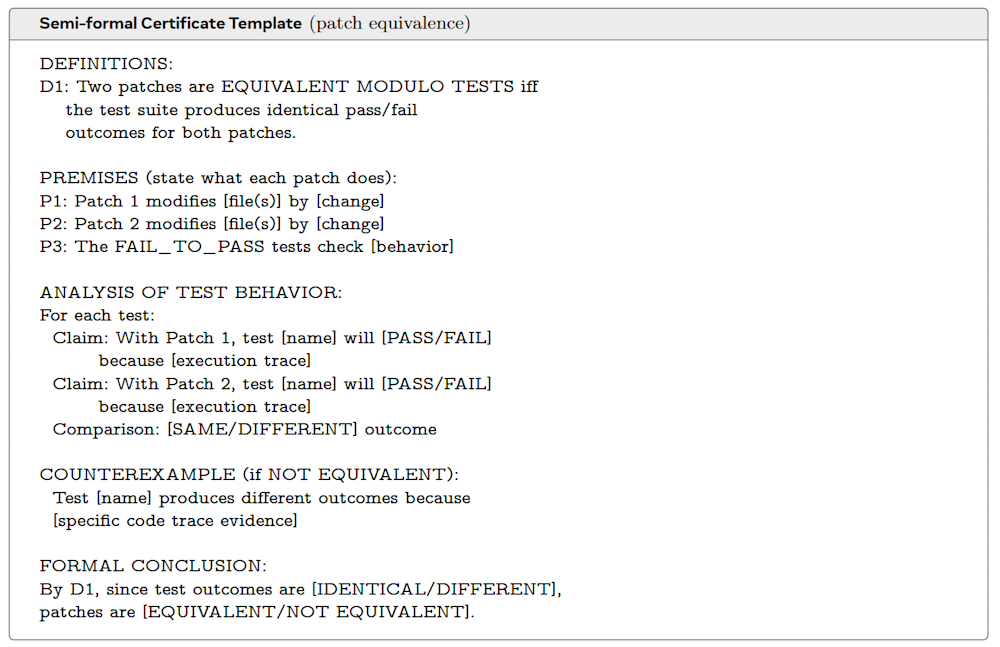
Пример шаблона полуформальных рассуждений (источник: arXiv)
Эти шаблоны функционируют как обязательные логические сертификаты. Чтобы выполнить задачу, агент должен явно указать предпосылки, проследить пути выполнения для конкретных тестов и вывести формальное заключение исключительно на основе проверяемых доказательств.
Шаблон заставляет агента собирать доказательства из кодовой базы перед вынесением суждения. Агент должен реально следовать вызовам функций и потокам данных шаг за шагом, а не угадывать их поведение на основе поверхностных соглашений об именовании. Такой систематический сбор доказательств помогает агенту справляться с краевыми случаями (например, запутанными именами функций) и избегать необоснованных утверждений.
Полуформальные рассуждения в действии
Исследователи оценили полуформальные рассуждения на трех задачах программной инженерии: верификация эквивалентности патчей (для определения того, дают ли два патча одинаковые результаты тестирования без их запуска), локализация багов (для точного определения строк кода, вызвавших ошибку) и ответы на вопросы по коду (для проверки тонкого семантического понимания сложных кодовых баз). В экспериментах использовались модели Claude Opus-4.5 и Sonnet-4.5 в качестве автономных агентов-верификаторов.
Команда сравнила свой структурированный полуформальный подход с несколькими базовыми вариантами, включая стандартные рассуждения, когда агентированной модели дается минимальный промпт, и ей разрешается свободно объяснять свои мысли на неструктурированном естественном языке. Они также провели сравнение с традиционными алгоритмами сходства текста, такими как difflib.
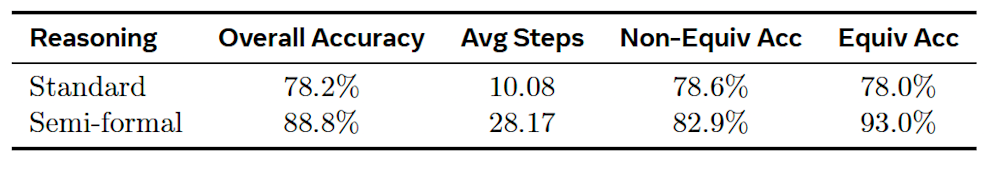
Полуформальные рассуждения демонстрируют значительное улучшение по сравнению со стандартными (источник: arXiv)
В задаче эквивалентности патчей полуформальные рассуждения повысили точность на сложных отобранных примерах с 78% (при использовании стандартных рассуждений) до 88%. При оценке реальных патчей, созданных агентами, при наличии спецификаций тестов модель Opus-4.5 с использованием полуформальных рассуждений достигла 93% точности верификации, превзойдя как неструктурированный одношаговый базовый метод (86%), так и базовый метод difflib (73%). В других задачах также наблюдался прирост по всем направлениям.
В документе подчеркивается ценность полуформальных рассуждений на примерах из реальной жизни. В одном из случаев агент оценивает два патча в репозитории Python Django, которые пытаются исправить баг с двузначным форматированием лет для годов до 1000 н.э. Один патч использует кастомную функцию format() внутри библиотеки, которая переопределяет стандартную функцию, используемую в Python.
Модели со стандартными рассуждениями смотрят на эти патчи, предполагают, что format() относится к стандартной встроенной функции Python, подсчитывают, что оба подхода дадут одинаковый строковый вывод, и ошибочно объявляют патчи эквивалентными.
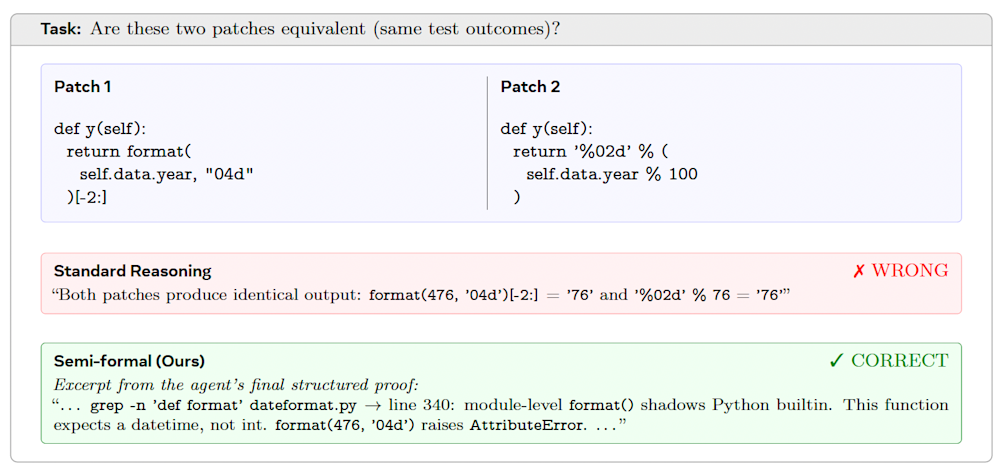
Пример полуформальных рассуждений в сравнении со стандартными (источник: arXiv)
При использовании полуформальных рассуждений агент отслеживает путь выполнения и проверяет определения методов. Следуя структурированному шаблону, агент обнаруживает, что в одном из файлов библиотеки имя format() фактически перекрывается кастомной функцией на уровне модуля. Агент формально доказывает, что при заданных атрибутах входных данных, переданных в код, этот патч приведет к сбою системы, в то время как другой сработает успешно.
Основываясь на своих экспериментах, исследователи предполагают, что «LLM-агенты могут выполнять содержательный семантический анализ кода без выполнения, потенциально снижая затраты на верификацию в конвейерах обучения с подкреплением (RL) за счет исключения дорогостоящего выполнения в песочнице».
Предостережения и компромиссы
Хотя полуформальные рассуждения предлагают существенное повышение надежности, корпоративным разработчикам следует учитывать несколько практических нюансов перед их внедрением. Здесь существует очевидный компромисс между вычислениями и задержкой. Полуформальные рассуждения требуют больше вызовов API и токенов. При оценке эквивалентности патчей полуформальные рассуждения потребовали примерно в 2,8 раза больше шагов выполнения, чем стандартные неструктурированные рассуждения.
Этот метод также не универсально улучшает производительность, особенно если модель уже весьма искусна в выполнении конкретной задачи. Когда исследователи оценили модель Sonnet-4.5 на бенчмарке ответов на вопросы по коду, стандартные неструктурированные рассуждения уже обеспечивали высокую точность на уровне около 85%. Применение полуформального шаблона в этом сценарии не принесло дополнительного прироста.
Кроме того, структурированные рассуждения могут выдавать неверные ответы с высокой степенью уверенности. Поскольку агента заставляют выстраивать сложные формальные цепочки доказательств, он может стать излишне самоуверенным, если его исследование было глубоким, но неполным. В одной из проверок на Python агент тщательно отследил пять различных функций, чтобы обнаружить валидный краевой случай, но полностью упустил из виду, что нижележащий фрагмент кода уже безопасно обрабатывал этот самый сценарий. Построив прочную цепочку доказательств, агент выдал неверное заключение с чрезвычайно высокой уверенностью.
Зависимость системы от конкретных доказательств также нарушается при достижении границ кодовой базы. При анализе сторонних библиотек, где исходный код недоступен, агент все равно будет прибегать к угадыванию поведения на основе имен функций.
В некоторых случаях, несмотря на строгие инструкции в промпте, модели все же периодически не могут полностью проследить конкретные пути выполнения.
В конечном счете, хотя полуформальные рассуждения кардинально сокращают число неструктурированных догадок и галлюцинаций, они не устраняют их полностью.
Главные выводы для разработчиков
Эту технику можно использовать «из коробки», она не требует обучения моделей или специальной упаковки. Она не требует выполнения кода, а значит, вам не нужно добавлять дополнительные инструменты в вашу среду LLM. Вы платите больше вычислительными ресурсами во время инференса, чтобы получить более высокую точность в задачах код-ревью.
Исследователи предполагают, что структурированные агентные рассуждения могут предложить «гибкую альтернативу классическим инструментам статического анализа: вместо кодирования логики анализа в специализированных алгоритмах мы можем давать LLM-агентам шаблоны рассуждений для конкретных задач, которые обобщаются на разные языки и фреймворки». Сделать это можно с помощью эффективного промптинга.
Исследователи предоставили шаблоны промптов в открытом доступе, что позволяет легко внедрить их в ваши приложения. Несмотря на множество разговоров о том, что инженерия промптов мертва, эта техника показывает, насколько высокую производительность все еще можно выжать из хорошо структурированных промптов.




