


Claude Opus 4.5 от Anthropic снижает затраты на ИИ на 66%


Anthropic в понедельник выпустила свою самую мощную модель искусственного интеллекта на сегодняшний день, снизив цены примерно на две трети и заявив о передовой производительности в задачах разработки программного обеспечения. Этот стратегический шаг усиливает конкуренцию AI-стартапа с богатыми соперниками в лице OpenAI и Google.
Claude Opus 4.5, новая модель, набрала на самом сложном внутреннем инженерном тесте Anthropic больше баллов, чем любой кандидат-человек за всю историю компании, согласно материалам, с которыми ознакомился VentureBeat. Этот результат подчеркивает как стремительно развивающиеся возможности систем ИИ, так и растущие вопросы о том, как эта технология изменит профессии «белых воротничков».
Компания, которую поддерживает Amazon, оценивает Claude Opus 4.5 в $5 за миллион входных токенов и $25 за миллион выходных токенов. Это разительное снижение по сравнению с расценками в $15 и $75 для ее предшественницы, Claude Opus 4.1, выпущенной ранее в этом году. Данный шаг делает передовые возможности ИИ доступными для более широкого круга разработчиков и предприятий, одновременно оказывая давление на конкурентов, которым теперь приходится соответствовать как по производительности, так и по ценовой политике.
«Мы хотим убедиться, что это действительно работает для людей, которые хотят использовать такие модели в своей работе», — заявил Алекс Альберт (Alex Albert), руководитель отдела по работе с разработчиками в Anthropic, в эксклюзивном интервью VentureBeat. — «Именно на этом мы и сосредоточены: как сделать так, чтобы Claude лучше помогал вам выполнять то, что вам не обязательно делать в рамках своей профессии?»
Анонс прозвучал на фоне стремления Anthropic удержать свои позиции в условиях все более жесткой конкуренции. Компания OpenAI недавно выпустила GPT-5.1 и специализированную модель для написания кода под названием Codex Max, способную работать автономно в течение длительного времени. Компания Google всего неделю назад представила Gemini 3, что, согласно недавнему отчету The Information, вызвало беспокойство даже у OpenAI по поводу успехов поискового гиганта.
По словам разработчиков, Opus 4.5 демонстрирует улучшенное понимание реальных задач
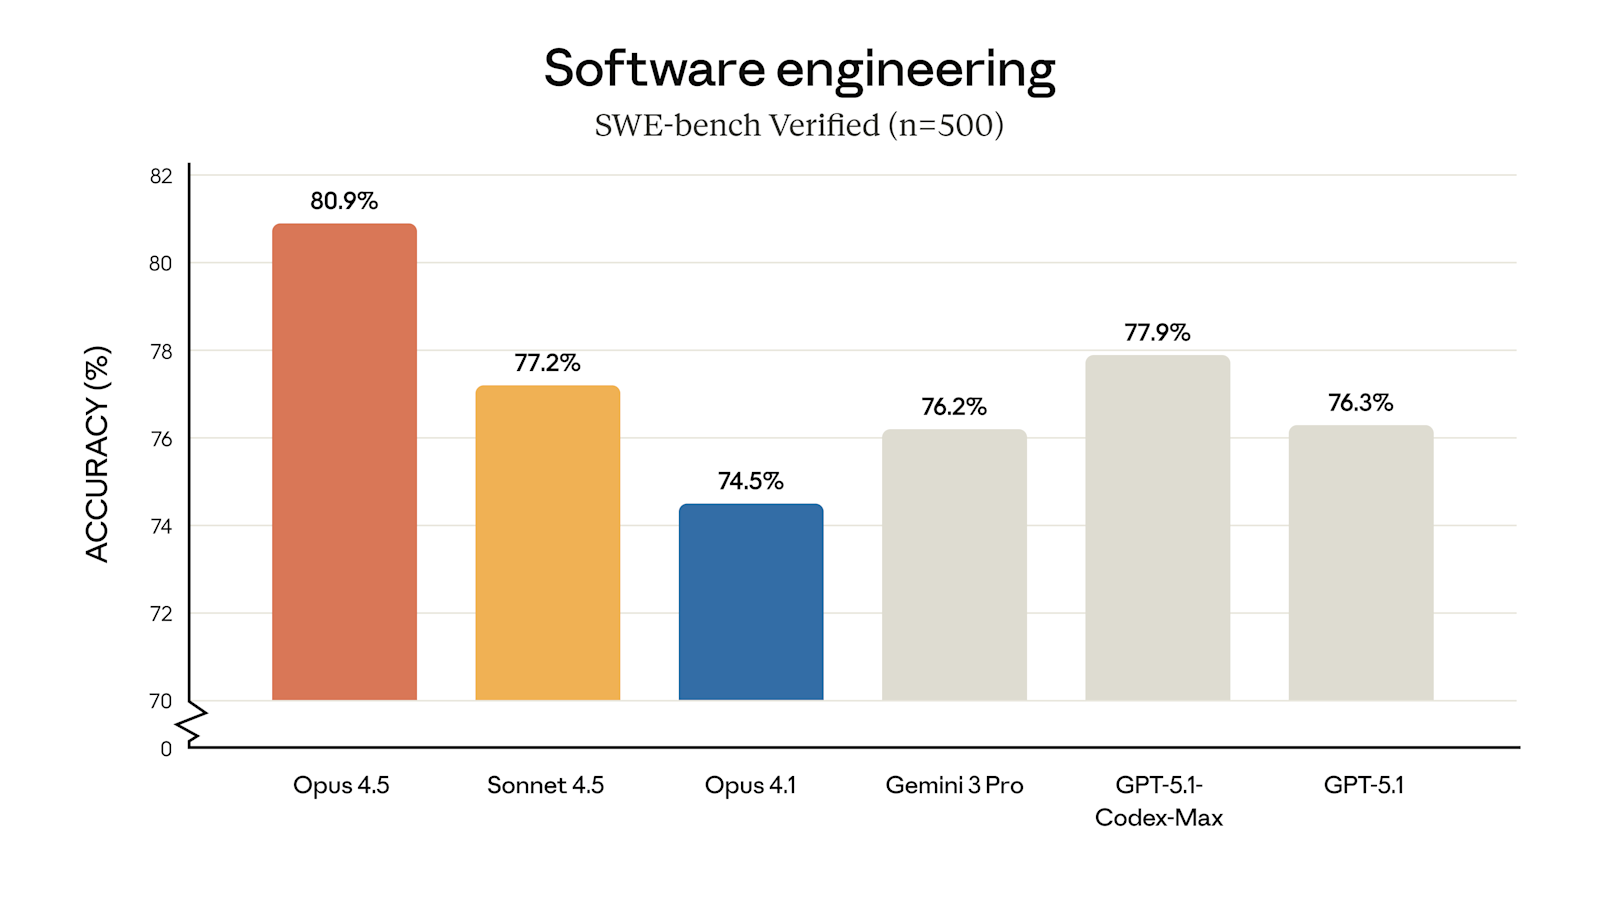
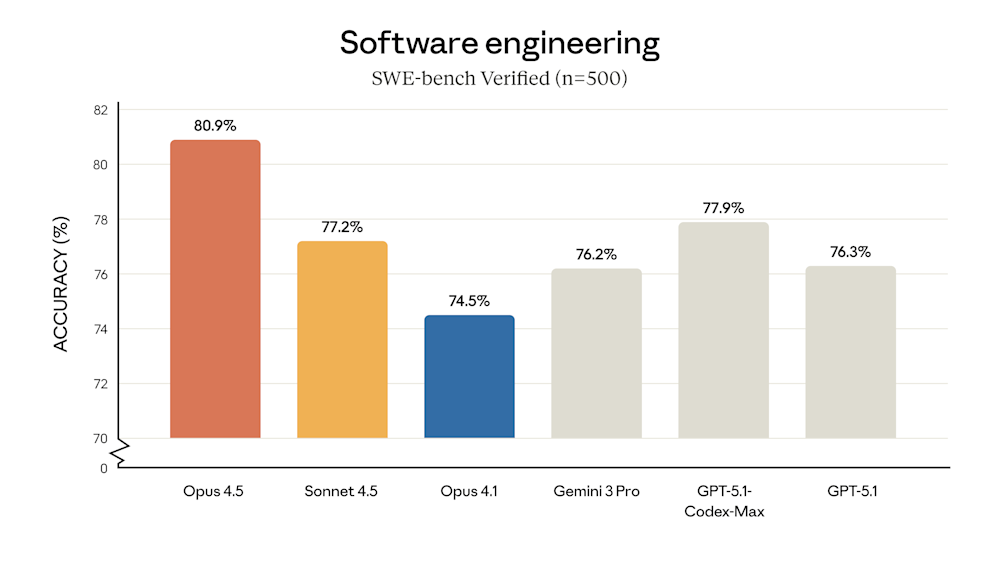
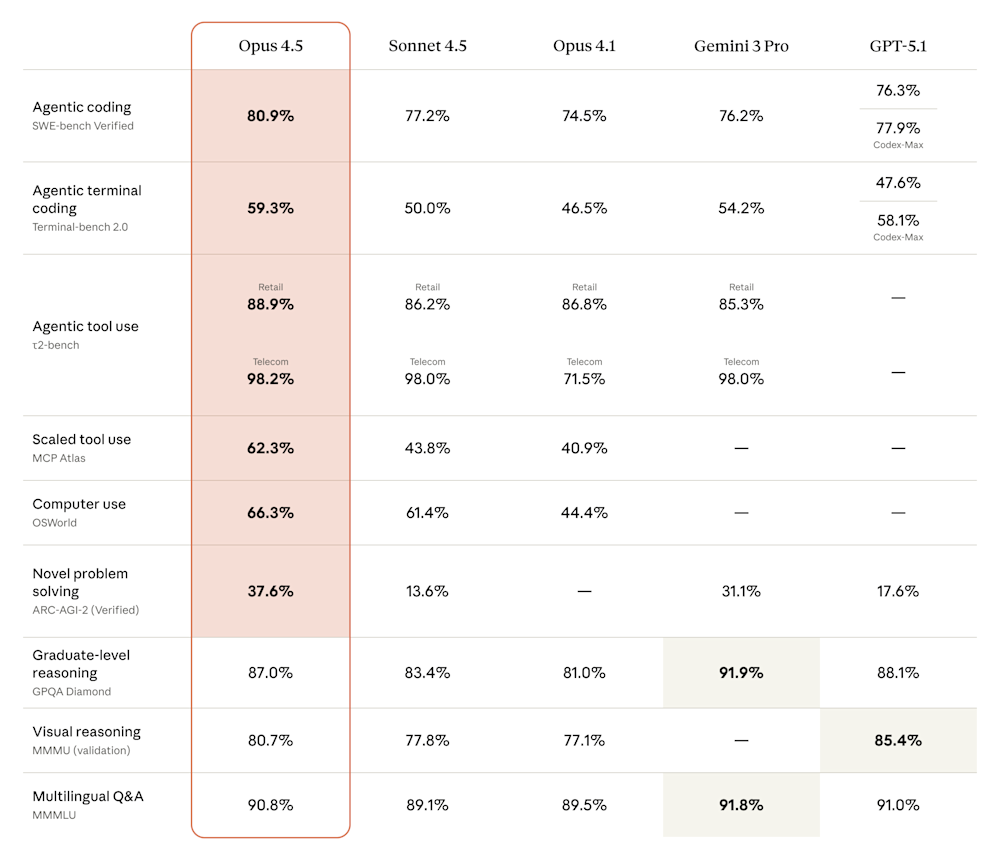
Внутреннее тестирование Anthropic выявило то, что компания описывает как качественный скачок в возможностях логического рассуждения Claude Opus 4.5. Согласно данным компании, модель достигла точности в 80,9% на SWE-bench Verified — бенчмарке, оценивающем задачи по разработке ПО в реальных условиях. Она превзошла GPT-5.1-Codex-Max от OpenAI (77.9%), собственную модель Anthropic Sonnet 4.5 (77.2%) и Gemini 3 Pro от Google (76.2%). Этот результат знаменует собой заметный прогресс по сравнению с текущей передовой моделью OpenAI, которая была выпущена всего пятью днями ранее.
Но технические бенчмарки отражают лишь часть картины. По словам Альберта, сотрудники, проводившие тестирование, отмечали, что модель неизменно демонстрирует улучшенные рассудительность и интуицию при решении разнообразных задач. Он охарактеризовал это изменение как развитие у модели понимания того, что действительно важно в реальном контексте.
Источник: Anthropic
«Модель просто начинает улавливать суть», — сказал Альберт. — «У нее развилась определенная интуиция и способность оценивать множество вещей из реального мира, что качественно ощущается как большой шаг вперед по сравнению с прошлыми моделями».
В качестве примера он привел собственный рабочий процесс. Раньше, по словам Альберта, он просил модели ИИ собирать информацию, но сомневался, стоит ли доверять их обобщению или расстановке приоритетов. С выходом Opus 4.5 он стал делегировать более масштабные задачи, подключая ее к Slack и внутренним документам для получения связных сводок, соответствующих его приоритетам.
Opus 4.5 превзошел всех кандидатов-людей на самом сложном инженерном испытании компании
Результаты работы модели на внутреннем инженерном тесте Anthropic стали важной вехой. Домашний экзамен, предназначенный для кандидатов на должность инженеров по производительности, призван оценить технические навыки и способность принимать решения в условиях дефицита времени за строго отведенные два часа.
Используя метод параллельных вычислений на этапе тестирования (параллельного вывода), который объединяет несколько попыток модели и выбирает лучший результат, Opus 4.5 набрала больше баллов, чем любой кандидат-человек, когда-либо проходивший этот тест, утверждают в компании. Без ограничения по времени модель сравнялась по результатам с лучшим кандидатом-человеком за всю историю при использовании внутри Claude Code — среды разработки Anthropic.
В компании признали, что тест не измеряет другие важнейшие профессиональные навыки, такие как умение работать в команде, коммуникабельность или интуицию, вырабатываемую годами опыта. Тем не менее, по заявлению Anthropic, этот результат «ставит вопросы о том, как ИИ изменит инженерию как профессию».
Альберт подчеркнул значимость этого открытия. «Я думаю, это своего рода знак того, насколько полезными эти модели действительно могут оказаться в рабочем контексте и для наших профессий», — отметил он. — «Конечно, это была инженерная задача, и я бы сказал, что модели в сфере инженерии опережают другие области, но я считаю, что это очень важный сигнал, на который стоит обратить внимание».
Радикальное повышение эффективности сократило использование токенов до 76% в ключевых бенчмарках
Помимо чистой производительности, в Anthropic рассчитывают, что именно рост эффективности выделит Claude Opus 4.5 на рынке. В компании заявляют, что для достижения аналогичных или лучших результатов по сравнению с предшественницами модель использует значительно меньше токенов — единиц текста, обрабатываемых системами ИИ.
По данным Anthropic, при среднем уровне усилий Opus 4.5 повторяет лучший результат предыдущей модели Sonnet 4.5 на бенчмарке SWE-bench Verified, расходуя при этом на 76% меньше выходных токенов. При максимальном уровне усилий производительность Opus 4.5 превосходит показатели Sonnet 4.5 на 4,3 процентных пункта, расходуя на 48% меньше токенов.
Чтобы предоставить разработчикам больше контроля, Anthropic внедрила «параметр усилий», который позволяет пользователям регулировать объем вычислительной работы, затрачиваемой моделью на каждую задачу, находя баланс между производительностью, задержкой и стоимостью.
Корпоративные клиенты уже успели подтвердить заявления об эффективности. «Opus 4.5 превосходит Sonnet 4.5 и конкурентов в наших внутренних бенчмарках, используя меньше токенов для решения тех же проблем», — заявил в интервью VentureBeat Микеле Катаста (Michele Catasta), президент облачной платформы для кодинга Replit. — «В масштабе эта эффективность многократно возрастает».
Директор по продукту GitHub Марио Родригес (Mario Rodriguez) сообщил, что раннее тестирование показывает: Opus 4.5 «превосходит внутренние бенчмарки кодирования при сокращении использования токенов вдвое и особенно хорошо подходит для таких задач, как миграция и рефакторинг кода».
Первые клиенты сообщают об AI-агентах, которые учатся на опыте и совершенствуют свои навыки
Одной из самых поразительных возможностей, продемонстрированных первыми пользователями, стали так называемые «самообучающиеся агенты» от Anthropic — системы ИИ, способные совершенствовать собственные результаты посредством итеративного обучения.
Японская компания электронной коммерции и интернета Rakuten протестировала Claude Opus 4.5 на задачах автоматизации офисной работы. «Наши агенты смогли автономно совершенствовать свои возможности, достигнув пиковой производительности за 4 итерации, в то время как другие модели не смогли добиться такого качества и после 10 попыток», — рассказал Юсукэ Кадзи (Yusuke Kaji), генеральный менеджер Rakuten по направлению ИИ для бизнеса.
Альберт пояснил, что модель не обновляет свои собственные веса — фундаментальные параметры, определяющие поведение системы ИИ, — а скорее итеративно улучшает инструменты и подходы, используемые для решения проблем. «Она итеративно дорабатывала навык для конкретной задачи и видела, что пытается оптимизировать этот навык для повышения эффективности, чтобы в итоге справиться с поставленной задачей», — пояснил он.
Эта способность выходит за рамки написания кода. По словам Альберта, в Anthropic отметили значительные улучшения в создании профессиональных документов, электронных таблиц и презентаций. «Клиенты говорят, что это самый большой скачок, который они когда-либо видели между поколениями моделей», — подчеркнул Альберт. — «Таким образом, переход даже от Sonnet 4.5 к Opus 4.5 оказался масштабнее, чем любые два последовательных обновления моделей в прошлом».
Источник: Anthropic
Фирма финансового моделирования Fundamental Research Labs сообщила, что «точность наших внутренних оценок выросла на 20%, эффективность увеличилась на 15%, а сложные задачи, которые ранее казались недостижимыми, теперь стали решаемыми», по словам сооснователя Нико Кристи (Nico Christie).
Новые функции ориентированы на пользователей Excel, рабочие процессы в Chrome и отмену ограничений на длину чатов
Одновременно с релизом модели Anthropic представила пакет обновлений продуктов, ориентированных на корпоративных пользователей. Интеграция Claude для Excel стала общедоступной для владельцев подписок Max, Team и Enterprise с новой поддержкой сводных таблиц, диаграмм и загрузки файлов. Расширение для браузера Chrome теперь доступно всем пользователям Max.
Пожалуй, самым значимым нововведением стало появление «бесконечных чатов» — функции, которая устраняет ограничения контекстного окна за счет автоматического суммирования ранних частей разговоров по мере их удлинения. «Внутри Claude AI, прямо в самом продукте, вы фактически получаете такое бесконечное контекстное окно благодаря компрекции данных плюс некоторым функциям памяти, над которыми мы работаем», — пояснил Альберт.
Для разработчиков Anthropic выпустила «программный вызов инструментов», который позволяет Claude писать и выполнять код, напрямую вызывающий функции. В Claude Code появился обновленный режим планирования («Plan Mode») и настольная версия в рамках исследовательского превью, позволяющая разработчикам запускать несколько сеансов AI-агентов параллельно.
Рынок накаляется: OpenAI и Google спешат догнать конкурента по производительности и ценам
В первом квартале 2025 года годовая выручка Anthropic достигла $2 млрд, более чем удвоившись по сравнению с $1 млрд в предыдущем периоде. Количество клиентов, тратящих более $100 000 в год, выросло в восемь раз в годовом исчислении.
Стремительный выпуск Opus 4.5 — всего через несколько недель после появления Haiku 4.5 в октябре и Sonnet 4.5 в сентябре — отражает более широкие тенденции в индустрии. В течение 2025 года OpenAI выпустила несколько версий GPT-5, включая специализированную модель Codex Max в ноябре, способную работать автономно до 24 часов. Google представила Gemini 3 в середине ноября после нескольких месяцев разработки.
Альберт отчасти приписал ускоренный темп работы Anthropic использованию самого Claude для ускорения собственной разработки. «Мы видим массу помощи и ускорения со стороны самого Claude — будь то в создании реальных продуктов или в исследовании моделей», — отметил он.
Снижение цен на Opus 4.5 может оказать давление на маржинальность бизнеса, одновременно расширяя потенциальный рынок сбыта. «Я ожидаю, что многие стартапы начнут гораздо активнее внедрять это в свои продукты и делать на этом заметный акцент», — сказал Альберт.
Тем не менее, ведущие ИИ-лаборатории по-прежнему сталкиваются с трудностями в достижении прибыльности из-за масштабных инвестиций в вычислительную инфраструктуру и исследовательские кадры. Рынок искусственного интеллекта, по прогнозам, превысит $1 триллион выручки в течение десятилетия, однако ни один отдельный поставщик пока не занял доминирующего положения на рынке — даже несмотря на то, что модели достигли порога, позволяющего им эффективно автоматизировать сложную интеллектуальную работу.
Майкл Труэлл (Michael Truell), генеральный директор ИИ-редактора кода Cursor, назвал Opus 4.5 «заметным улучшением по сравнению с предыдущими моделями Claude внутри Cursor, обладающим улучшенными ценами и более высоким интеллектом при решении сложных задач программирования». Скотт Ву (Scott Wu), генеральный директор AI-стартапа в сфере кодинга Cognition, заявил, что модель обеспечивает «более высокие результаты на наших самых сложных тестах и стабильную производительность во время 30-минутных сеансов автономного программирования».
Для предприятий и разработчиков такая конкуренция оборачивается стремительным ростом возможностей при снижении цен. Но по мере того, как производительность ИИ в решении технических задач приближается к уровню экспертов-людей (а иногда и превосходит его), влияние технологий на профессиональную деятельность перестает быть чисто теоретическим.
Отвечая на вопрос о результатах инженерного экзамена и о том, что они говорят о траектории развития ИИ, Альберт высказался прямо: «Я думаю, это действительно важный сигнал, на который стоит обратить внимание».




