Стэнфорд и Nvidia увеличивают скорость GPU-ядра вдвое
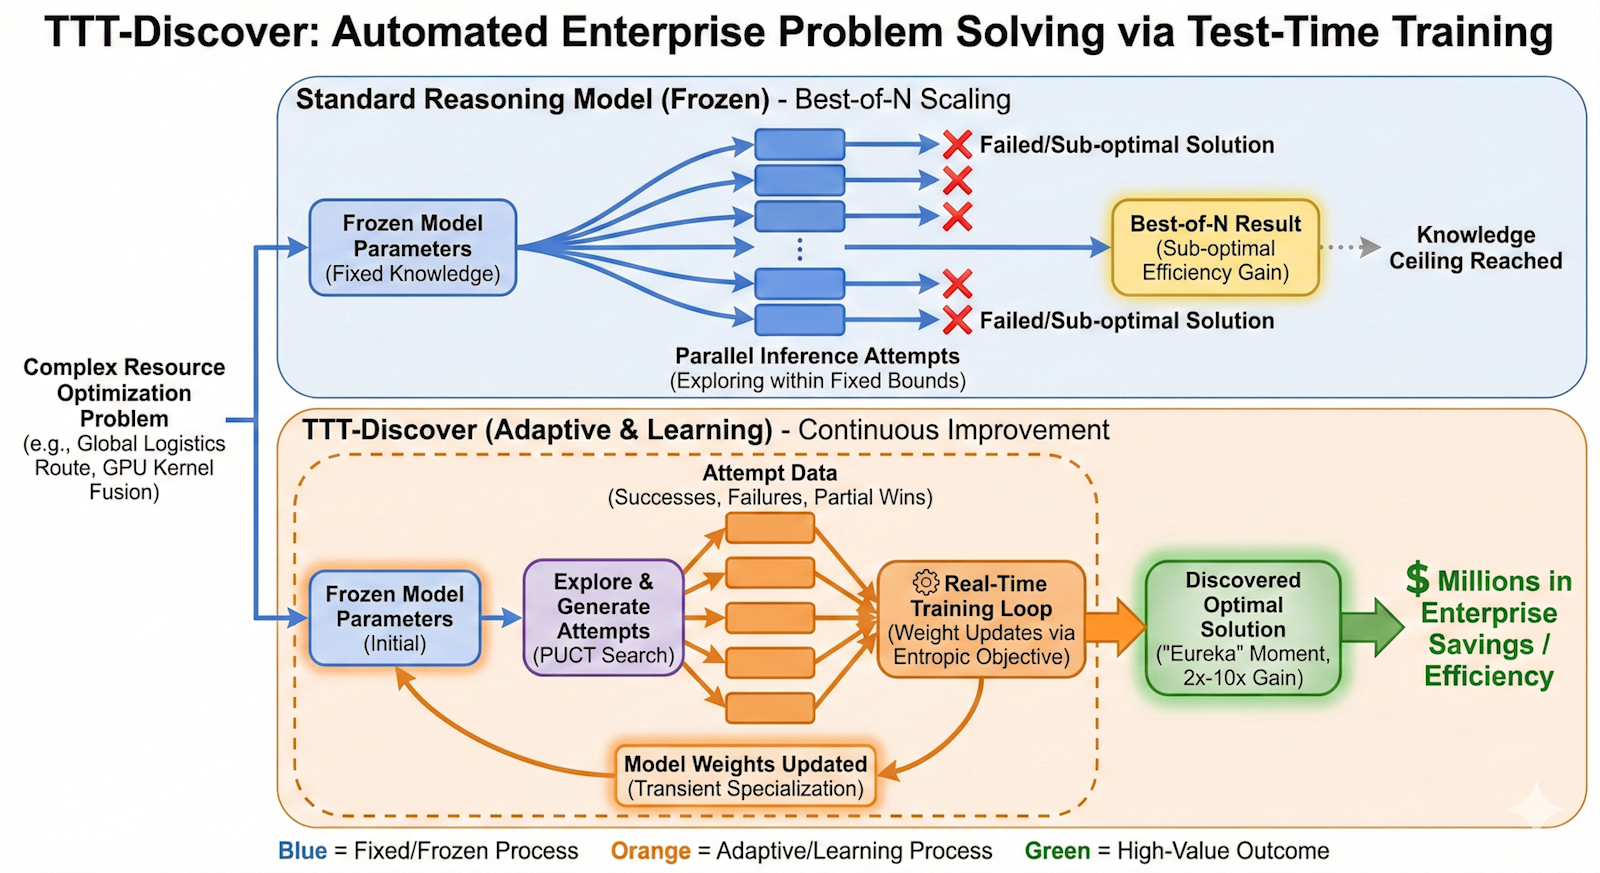


Исследователи из Стэнфорда, Nvidia и Together AI разработали новый метод, способный находить решения для сложнейших задач. Например, им удалось оптимизировать критически важное ядро GPU так, что оно стало работать в 2 раза быстрее предыдущего лучшего аналога, написанного экспертами-людьми.
Их метод, получивший название «Test-Time Training to Discover» (TTT-Discover), бросает вызов текущей парадигме, в рамках которой моделям позволяют «больше думать» над задачами на рассуждение. TTT-Discover позволяет модели продолжать обучение в процессе инференса и обновлять свои веса под конкретную задачу.
Пределы «замороженных» рассуждений
Современные корпоративные стратегии в области ИИ часто опираются на «замороженные» модели. Используете ли вы закрытую или открытую модель рассуждений, параметры такой модели остаются статичными. Когда вы отправляете этим моделям промт, они ищут ответы в фиксированном пространстве своих обучающих данных. Это отлично работает для задач, похожих на те, с которыми модель уже сталкивалась ранее.
Однако настоящие задачи на совершение открытий — такие как изобретение принципиально нового алгоритма или доказательство новой математической теоремы — по определению выходят за рамки распределения (out-of-distribution). Если для решения требуется логический скачок, отсутствующий в обучающей выборке, «замороженная» модель, скорее всего, потерпит неудачу, сколько бы вычислительных ресурсов вы ни выделили на этапе инференса.
В комментарии для VentureBeat Мерт Юксекгонул (Mert Yuksekgonul), соавтор научной работы и аспирант Стэнфорда, проиллюстрировал это различие на примере знаменитого математического прорыва:
«Я считаю, что модели рассуждений не смогли бы доказать, например, равенство классов P и NP (P != NP) без обучения во время тестирования — точно так же, как Эндрю Уайлс не смог бы доказать Великую теорему Ферма без тех 7 лет, которые он потратил на решение этой единственной задачи в изоляции и непрерывное обучение на собственных ошибках».
TTT-Discover рассматривает тестовую задачу не как запрос, на который нужно дать ответ, а как среду, которую необходимо освоить. В процессе попыток решить задачу модель генерирует различные типы данных: неудачи, частичные успехи и ошибки. Вместо того чтобы отбрасывать эти данные, TTT-Discover использует их для обновления весов модели в режиме реального времени, что позволяет модели сосредоточиться именно на этой конкретной проблеме, а не разрабатывать универсальный фреймворк для решения задач общего характера.
Иной подход к обучению с подкреплением
TTT-Discover кардинально меняет подход к обучению моделей рассуждений. В стандартном обучении с подкреплением (RL) целью является создание универсальной политики, которая в среднем хорошо справляется с множеством задач. В TTT-Discover цель состоит в поиске наилучшего решения для очень конкретной проблемы, а политика является «средством для достижения этой цели», как отмечают авторы. Как только модель находит артефакт (например, оптимизированный код, доказательство или молекулу), создавшую его нейросеть можно отбросить.
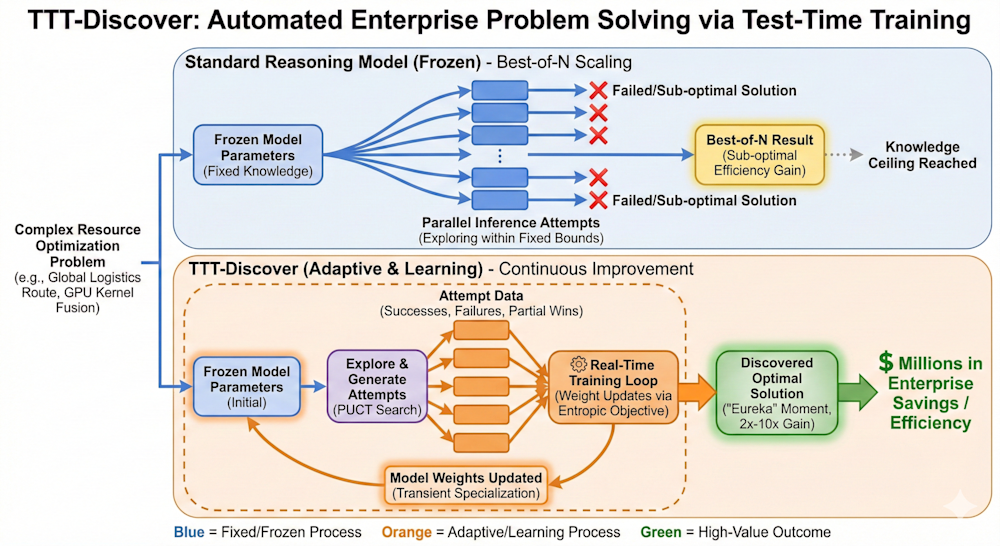
Для достижения этого исследователи спроектировали два специфических компонента, которые отличают TTT-Discover от стандартного обучения с подкреплением:
-
Энтропийная целевая функция (Entropic objective): Стандартное RL оптимизирует показатель среднего ожидаемого вознаграждения. Если модель выбирает рискованный путь и терпит неудачу, стандартное RL наказывает ее. TTT-Discover меняет этот подход. В нем используется «энтропийная целевая функция», которая экспоненциально взвешивает результаты с высоким вознаграждением. Это заставляет модель игнорировать «безопасные» усредненные ответы и агрессивно искать выбросы типа «эврика» — решения, которые имеют низкую вероятность обнаружения, но сулят колоссальное вознаграждение.
-
Поиск PUCT: Система внедряет PUCT — алгоритм поиска по дереву, вдохновленный AlphaZero. Он исследует различные пути решения, формируя набор данных из попыток. Затем модель обучается на этом наборе данных в реальном времени, научаясь распознавать, какие промежуточные шаги ведут к результатам с высоким вознаграждением.
Крайне важно отметить, что этот метод лучше всего работает на задачах с непрерывным сигналом вознаграждения. Системе необходим способ измерения инкрементального прогресса (например, «время выполнения в микросекундах» или «уровень ошибок»), а не бинарный сигнал «успех/неудача». Это позволяет модели следовать по пути постепенного улучшения в сторону оптимального решения.
Экономика «тяжелого инференса»
Для компаний, привыкших платить доли цента за вызов API, структура затрат TTT-Discover требует изменения мышления. В своих экспериментах исследователи сообщили, что один цикл поиска решения включает примерно 50 шагов обучения и тысячи прогонов (rollouts), что обходится примерно в 500 долларов за задачу.
TTT-Discover может применяться для «статичных активов высокой ценности» в противовес тривиальным и повторяющимся задачам, которые можно решить с помощью существующих моделей и подходов.
Представьте себе облачное предприятие, управляющее конвейером данных, который еженощно обрабатывает петабайты информации. Если этот конвейер опирается на конкретный SQL-запрос или ядро GPU, оптимизация этого кода всего на 1% может сэкономить сотни тысяч долларов на ежегодных затратах на вычисления. В этом контексте трата 500 долларов на поиски ядра, которое работает на 50% быстрее, — это мизерные расходы с немедленной окупаемостью (ROI).
«Это имеет наибольший смысл для редких решений с большими последствиями, где единичное улучшение стоит гораздо дороже, чем затраты на вычисления, — говорит Юксекгонул. — Маршрутизация в цепочках поставок, разработка лекарств и материаловедение вполне подходят под это описание. В таких условиях трата сотен долларов на один этап поиска легко окупается».
Рекомендации по внедрению
Одним из наиболее значимых выводов для корпоративного внедрения является то, что TTT-Discover не требует проприетарной передовой модели. Исследователи добились передовых результатов, используя gpt-oss-120b — модель OpenAI с открытыми весами. Исследователи опубликовали код TTT-Discover, чтобы позволить исследователям и разработчикам использовать его для собственных моделей.
Поскольку метод работает с открытыми моделями, компании могут запускать этот «цикл поиска» полностью в пределах собственных защищенных виртуальных частных сетей (VPC) или локальных кластеров H100, не передавая свои проприетарные данные на сторонние серверы.
«Если компания уже практикует обучение с подкреплением, никакой дополнительной инфраструктуры не требуется, — отмечает Юксекгонул. — TTT-Discover использует тот же стек обучения (графические процессоры, воркеры для прогонов, оптимизаторы, создание контрольных точек)».
Если они еще не используют RL, им потребуется построить эту инфраструктуру. Однако предприятия также могут использовать существующие решения для снижения сложности процесса. Исследователи оркестрировали эти тренировочные запуски с помощью Tinker API от Thinking Machines — интерфейса API, который управляет сложностью распределенного обучения и инференса.
«Инструментарий вроде Tinker (и открытые аналоги, например, OpenTinker) снижает затраты на настройку, а затраты на рабочую силу и вычисления со временем, скорее всего, снизятся», — добавил он.
Практические сценарии использования
Исследователи применили TTT-Discover в четырех различных технических областях: системная инженерия, проектирование алгоритмов, биология и математика. Почти в каждом случае метод установил новый уровень технологического совершенства (state-of-the-art).
В одном из экспериментов модель оптимизировала ядра GPU для матричного умножения (включая ядро «TriMul», используемое в AlphaFold), достигнув скорости выполнения до 2 раз выше прежних лучших результатов и превзойдя лучшие написанные людьми ядра в таблице лидеров.
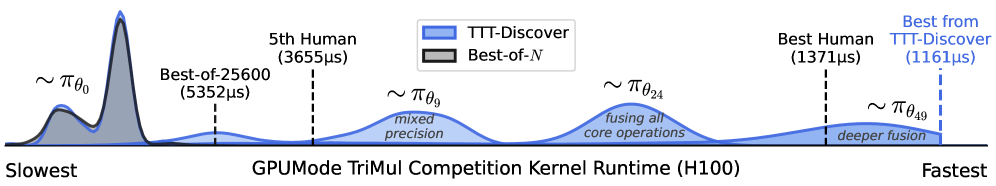
TTT-Discover находит SOTA-ядро GPU (источник: arXiv)
В сценариях спортивного программирования (AtCoder) система решала сложные эвристические задачи (например, оптимизацию геометрических ограничений для рыболовных сетей) лучше ведущих экспертов-людей и предыдущих ИИ-базовых моделей.
Для бизнеса переход от этих академических бенчмарков к реальной ценности зависит от одного конкретного ограничения: наличия проверяемого скалярного сигнала. В отличие от чат-бота, генерирующего текст, TTT-Discover нуждается в жесткой метрике (например, времени выполнения, уровне ошибок или норме прибыли), по отношению к которой производится оптимизация.
По словам Юксекгоonul, это требование проводит четкую границу между тем, где данную технологию следует использовать, а где — нет. «На данный момент ключевым требованием является надежный скалярный сигнал прогресса — стоимость, ошибка, свойства молекул, — по которому система может проводить оптимизацию», — поясняет он.
Это направляет корпоративное внедрение в сторону «сложных» инженерных и операционных задач, таких как логистика, цепочки поставок и управление ресурсами, где такие проблемы, как маршрутизация автопарка или планирование работы экипажей, часто опираются на статичную эвристику. TTT-Discover может рассматривать их как среды оптимизации, тратя часы на поиски структуры маршрута, которая сократит ежедневные расходы на топливо на 5%.
Требование наличия четких верификаторов исключает качественные задачи вроде «написать лучшую маркетинговую стратегию», где верификация носит субъективный характер и подвержена влиянию шума.
«Задачи, которые трудно проверить, остаются открытым вопросом», — говорит Юксекгонул.
При текущем уровне технологий лучший путь вперед — попытаться разработать верификаторы, но «сделать эти верификаторы надежными и защищенными от манипуляций сложно, и у нас пока нет хорошего решения», добавил он.
От инференса к изобретению
Более глобальный вывод заключается в том, что стекам корпоративного ИИ, возможно, придется эволюционировать, чтобы поддерживать такой тип обучения для каждой отдельной задачи.
«Системам, построенным вокруг замороженной модели, потребуется поддержка адаптации под конкретную задачу (или домен), а предприятиям понадобятся более четкие спецификации проблем и внутренние сигналы обратной связи, чтобы обучение во время тестирования было эффективным, — рассуждает Юксекгонул. — Если обучение происходит внутри защищенной VPC, этот цикл обучения также может быть интегрирован с большим количеством внутренних сред компании, а не только с конвейером центральной лаборатории».
Для бизнеса ценность заключается в выявлении «миллионных проблем» — оптимизационных задач, где существует проверяемый показатель, но прогресс людей зашел в тупик. Именно они являются кандидатами для применения TTT-Discover. Соглашаясь на более высокие задержки и затраты для конкретных запросов, предприятия могут превратить свои вычислительные мощности для инференса в автоматизированную лабораторию R&D, открывая решения, которые ранее были недоступны как для людей, так и для «замороженных» ИИ-моделей.