IndexCache повышает скорость работы языковых моделей в 1,82 раза


Обраработка 200 000 токенов с помощью большой языковой модели стоит дорого и происходит медленно: чем длиннее контекст, тем быстрее растут затраты. Исследователи из Университета Цинхуа и компании Z.ai создали метод под названием IndexCache, который устраняет до 75% избыточных вычислений в моделях разреженного внимания (sparse attention), обеспечивая ускорение генерации первого токена до 1,82 раза и повышение пропускной способности при генерации в 1,48 раза для контекста такой длины.
Этот метод применим к моделям, использующим архитектуру DeepSeek Sparse Attention, включая последние семейства моделей DeepSeek и GLM. Он может помочь предприятиям обеспечить более быструю работу пользователей для крупномасштабных моделей с длинным контекстом — возможность, которая уже доказала свою эффективность в ходе предварительных тестов на модели GLM-5 с 744 миллиардами параметров.
Узкое место DSA
Большие языковые модели полагаются на механизм самовнимания (self-attention) — процесс, в ходе которого модель вычисляет взаимосвязь между каждым токеном в своем контексте и всеми предыдущими токенами для предсказания следующего.
Однако у механизма самовнимания есть серьезный недостаток. Его вычислительная сложность масштабируется квадратично в зависимости от длины последовательности. Для приложений, требующих расширенных контекстных окон (например, обработка больших документов, многоэтапные агентные рабочие процессы или длинные цепочки рассуждений), такое квадратичное масштабирование приводит к низкой скорости инференса и значительным затратам на вычисления и память.
Разреженное внимание предлагает принципиальное решение этой проблемы масштабирования. Вместо вычисления взаимосвязи между каждым токеном и всеми предыдущими, разреженное внимание оптимизирует процесс за счет того, что каждый запрос выбирает и учитывает только наиболее релевантное подмножество токенов.
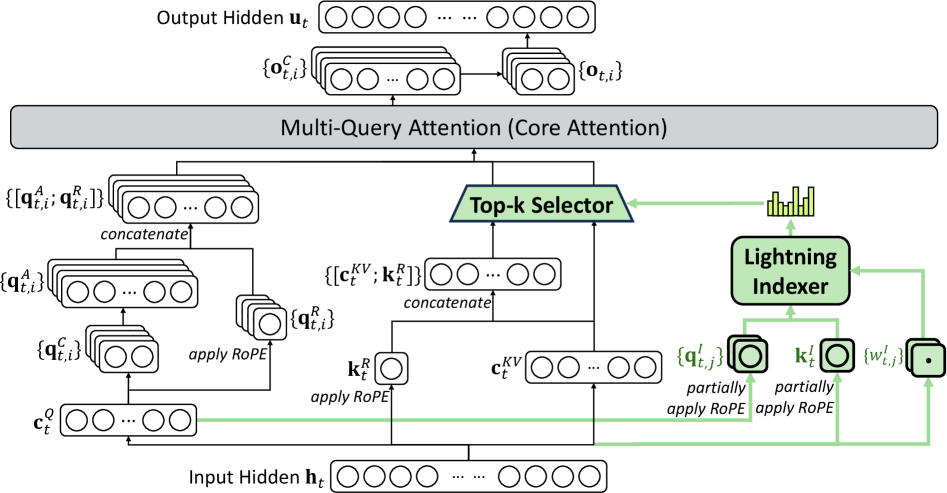
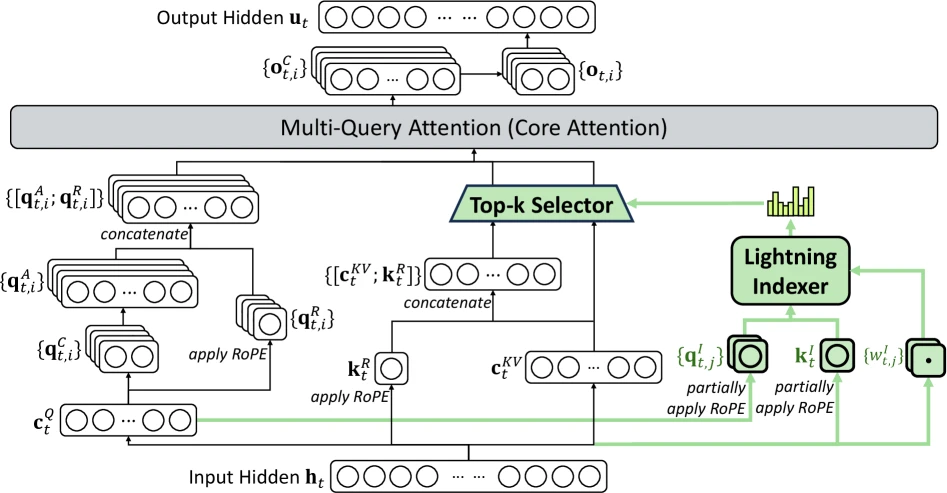
Архитектура DeepSeek Sparse Attention (DSA) (источник: arXiv)
Разреженное внимание DeepSeek (DeepSeek Sparse Attention, DSA) — это высокоэффективная реализация данной концепции, впервые представленная в DeepSeek-V3.2. Чтобы определить, какие токены имеют наибольшее значение, DSA внедряет облегченный «модуль молниеносного индексирования» на каждом слое модели. Этот индексатор оценивает все предыдущие токены и выбирает небольшую группу для обработки основным механизмом внимания. Благодаря этому DSA сокращает тяжелые вычисления основного внимания с квадратичной сложности до линейной, значительно ускоряя работу модели при сохранении качества вывода.
Но исследователи выявили сохраняющийся недостаток: сам индексатор DSA по-прежнему работает с квадратичной сложностью на каждом отдельном слое. Несмотря на то, что индексатор обходится дешевле основного процесса внимания с точки зрения вычислений, по мере роста длины контекста время, затрачиваемое моделью на работу этих индексаторов, стремительно растет. Это сильно замедляет работу модели, особенно на начальном этапе «презаполнения» (prefill), когда промпт обрабатывается впервые.
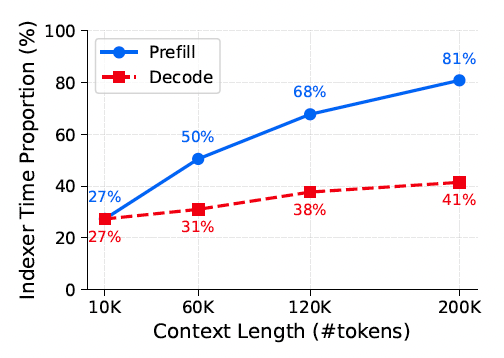
Плата за индексирование DSA растет вместе с длиной контекста (источник: arXiv)
Кэширование внимания с помощью IndexCache
Чтобы устранить узкое место индексатора, исследовательская группа обнаружила ключевую особенность обработки данных моделями DSA. Подмножество важных токенов, выбираемых индексатором, остается на удивление стабильным по мере прохождения данных через последовательные слои трансформера. Эмпирические тесты моделей DSA показали, что соседние слои разделяют от 70% до 100% выбранных ими токенов.
Чтобы использовать эту межслойную избыточность, исследователи разработали IndexCache. Метод разделяет слои модели на две категории. Небольшое количество полных (F) слоев сохраняют свои индексаторы, активно оценивая токены и выбирая наиболее важные для кэширования. Остальные слои становятся общими (S), они не выполняют индексирование и повторно используют кэшированные индексы из ближайшего предшествующего полного слоя.
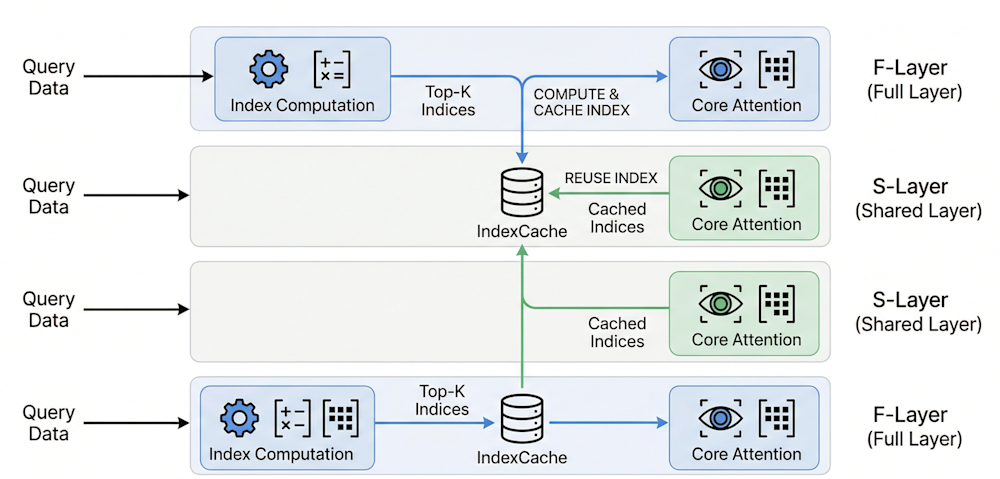
IndexCache разделяет слои на полные и общие
Во время инференса модель просто проверяет тип слоя. Если она достигает полного слоя, она вычисляет и кэширует свежие индексы. Если это общий слой, она пропускает вычисления и копирует кэшированные данные.
Существует широкий спектр методов оптимизации, пытающихся решить проблему узкого места внимания путем сжатия KV-кэша, где хранятся вычисленные значения внимания. В отличие от стандартного сжатия KV-кэша, уменьшающего объем памяти, IndexCache борется с вычислительным узким местом.
«IndexCache — это не традиционный метод сжатия или совместного использования KV-кэша, — рассказал VentureBeat Юши Бай (Yushi Bai), соавтор научной работы. — Он устраняет эту избыточность за счет повторного использования индексов на разных слоях, тем самым снижая нагрузку на вычисления, а не просто уменьшая объем занимаемой памяти. Он дополняет существующие подходы и может комбинироваться с ними».я
Исследователи разработали два подхода к развертыванию IndexCache. (Стоит отметить, что IndexCache применим только к моделям, использующим архитектуру DSA, таким как последние модели DeepSeek и последнее семейство моделей GLM).
Для разработчиков, работающих с готовыми моделями DSA, где повторное обучение нецелесообразно или слишком дорого, они создали метод, не требующий дообучения и опирающийся на алгоритм «жадного выбора слоев» (greedy layer selection). Запуская небольшой калибровочный датасет через модель, этот алгоритм автоматически определяет оптимальное размещение полных и общих слоев без каких-либо изменений весов. Эмпирические данные показывают, что жадный алгоритм может безопасно удалить 75% индексаторов, сохраняя при этом производительность исходной модели на последующих этапах.
Для команд, проводящих предварительное обучение или глубокую доводку собственных базовых моделей, исследователи предлагают версию, учитывающую обучение (training-aware), которая оптимизирует параметры сети для нативной поддержки межслойного совместного использования. Этот подход внедряет «потерю многослойной дистилляции» (multi-layer distillation loss) в процессе обучения. Она заставляет каждый оставшийся индексатор научиться выбирать согласованное подмножество токенов, которые будут крайне релевантны для всех последующих обслуживаемых им слоев.
Реальное ускорение производственных моделей
Чтобы проверить влияние IndexCache, исследователи применили его к модели GLM-4.7 Flash с 30 миллиардами параметров и сравнили ее со стандартным базовым решением.
При длине контекста 200 тыс. токенов удаление 75% индексаторов сократило задержку предварительного заполнения (prefill) с 19,5 секунды до всего лишь 10,7 секунды, обеспечив ускорение в 1,82 раза. Исследователи отмечают, что в условиях еще более длинного контекста эти показатели ускорения должны быть еще выше.
На этапе декодирования, когда модель генерирует ответ, IndexCache увеличил пропускную способность для одного запроса с 58 токенов в секунду до 86 токенов в секунду при отметке контекста в 200 тыс., что дало ускорение в 1,48 раза. Когда память сервера полностью заполнена запросами, общая пропускная способность декодирования возрастает на величину до 51%.
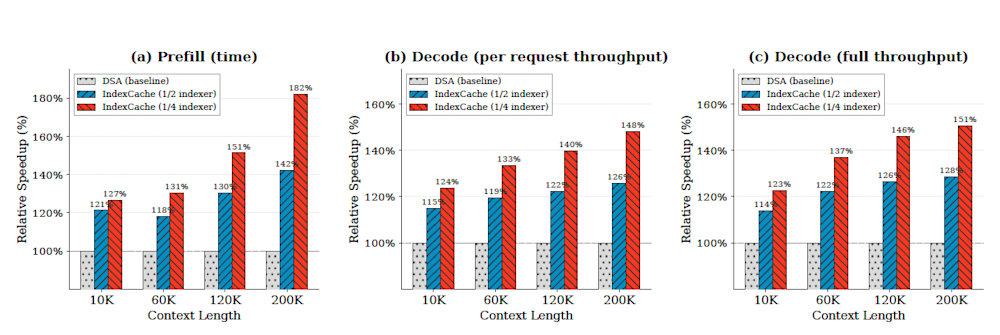
IndexCache существенно ускоряет этапы презаполнения и декодирования (источник: arXiv)
Для корпоративных команд эти показатели эффективности напрямую трансформируются в экономию средств. «С точки зрения окупаемости инвестиций (ROI), IndexCache обеспечивает стабильные преимущества в различных сценариях, но наибольший прирост заметен в задачах с длинным контекстом, таких как RAG, анализ документов и агентские конвейеры, — пояснил Бай. — В этих случаях мы наблюдаем сокращение затрат на развертывание примерно на 20% и аналогичное улучшение воспринимаемой пользователем задержки». Он добавил, что для задач с очень коротким контекстом выгода держится на уровне около 5%.
Примечательно, что этот прирост эффективности не ухудшил возможности рассуждений. При использовании подхода без дообучения для удаления 75% индексаторов модель с 30 млрд параметров показала средний балл на бенчмарках с длинным контекстом, сопоставимый с оригинальной базовой моделью (49,9 против 50,2 у оригинала). На чрезвычайно сложном математическом бенчмарке рассуждений AIME 2025 оптимизированная модель даже превзошла исходный базовый показатель, набрав 92,6 балла против 91,0.
Команда также провела предварительные эксперименты на крупномасштабной модели GLM-5 с 744 миллиардами параметров. Они выяснили, что устранение 75% ее индексаторов с помощью метода без дообучения обеспечило ускорение по меньшей мере в 1,3 раза на контекстах, превышающих 100 тыс. токенов. При этом модель сохранила практически идентичное среднее качество при выполнении задач с длинным контекстом.
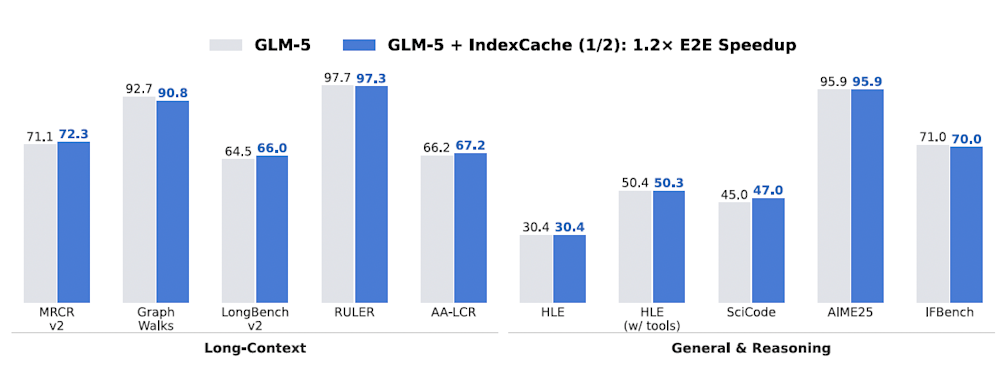
IndexCache увеличивает скорость работы GLM-5 на 20% при сохранении точности (источник: arXiv)
Внедрение IndexCache в производство
Для команд разработчиков, желающих внедрить подход без дообучения уже сегодня, этот процесс прост, но требует тщательной настройки. Хотя алгоритм жадного поиска автоматически находит оптимальную конфигурацию слоев, качество этой конфигурации зависит от обрабатываемых ею данных.
«Мы рекомендуем использовать предметно-ориентированные данные в качестве калибровочного набора, чтобы обнаруженная схема разделения слоев соответствовала реальным рабочим нагрузкам», — сказал Бай.
После калибровки оптимизация становится весьма доступной для производственных сред. Патчи с открытым исходным кодом уже доступны на GitHub для основных движков обслуживания. «Интеграция относительно проста — разработчики могут применить патч к существующим стекам инференса, таким как vLLM или SGLang, и включить IndexCache с минимальными изменениями конфигурации», — отметил Бай.
Хотя IndexCache предлагает быстрое решение сегодняшних проблем с узкими местами вычислений, его фундаментальная философия указывает на более масштабный сдвиг в том, как индустрия ИИ будет подходить к проектированию моделей.
«Будущие базовые модели, скорее всего, будут изначально проектироваться с учетом ограничений последующего инференса, — резюмировал Бай. — Это означает создание таких проектов, которые будут не только масштабируемы с точки зрения размера модели, но и оптимизированы для реальной пропускной способности и задержки, а не восприниматься как второстепенные задачи, решаемые постфактум».