


DeepSeek снижает стоимость API больших языковых моделей на 50%


DeepSeek продолжает раздвигать границы генеративного ИИ… на этот раз в плане доступности.
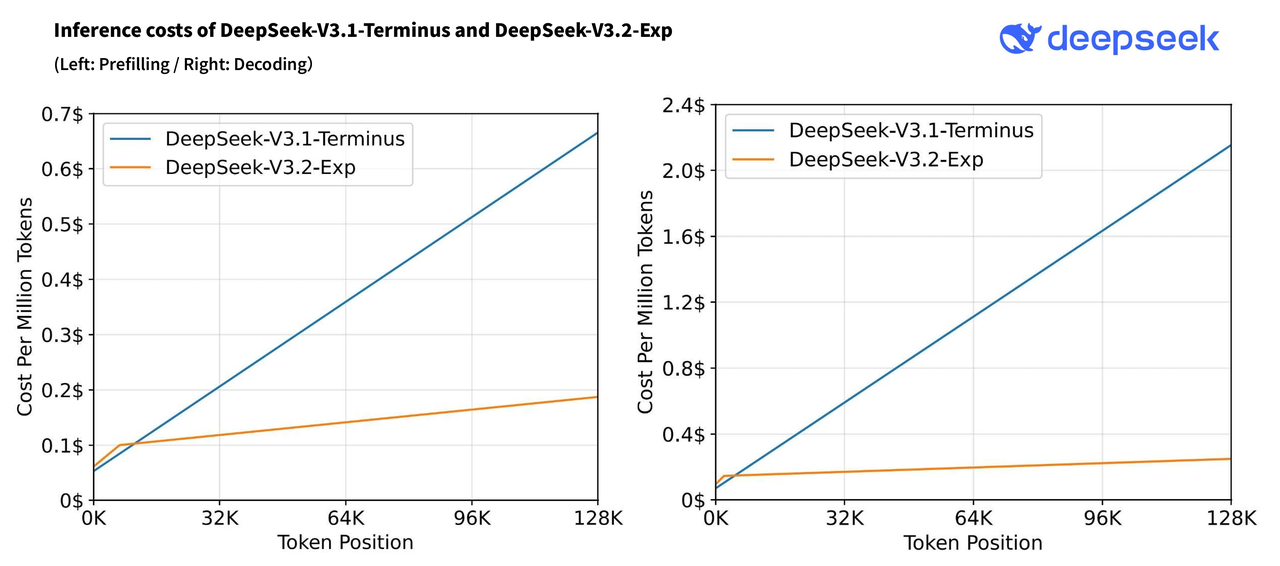
Компания представила свою новейшую экспериментальную большую языковую модель (LLM) — DeepSeek-V3.2-Exp, которая в целом соответствует результатам бенчмарков своего предшественника DeepSeek-3.1-Terminus или слегка превосходит их, но, что еще важнее, обходится на 50 процентов дешевле при использовании интерфейса программирования приложений (API) DeepSeek: стоимость снизилась всего до $0,028 за миллион входных токенов. При этом модель удерживает низкие затраты даже при приближении к лимиту контекста в 128 000 токенов (около 300–400 страниц информации).
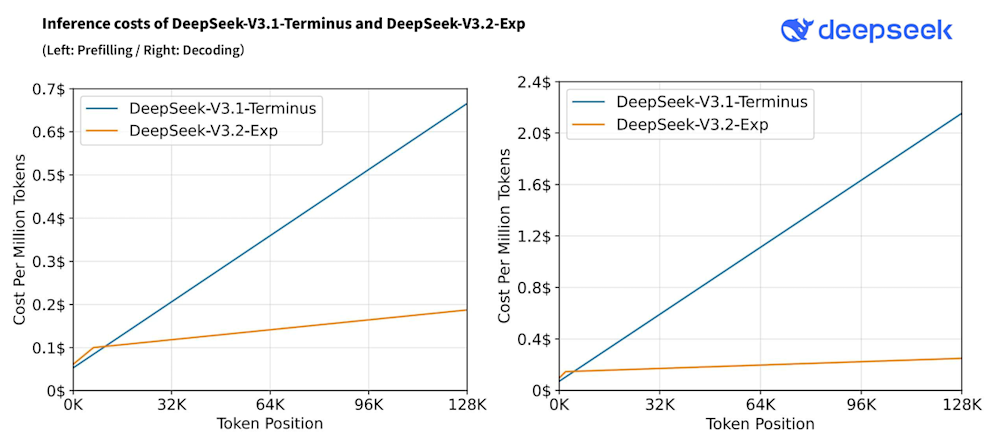
График, показывающий зависимость стоимости от длины контекста токенов для DeepSeek V3.2-Exp в сравнении с DeepSeek V3.1-Terminus. Источник: DeepSeek
Модель доступна через собственный API DeepSeek, а ее код можно загрузить по лицензии MIT, открытой и дружественной к бизнесу, на платформах Hugging Face и GitHub.
Как компании это удалось? Читайте далее, чтобы узнать подробности.
Цены на API снижены
Как упоминалось ранее, DeepSeek объявила о существенном снижении цен на API. За один миллион токенов попадания в кэш входных данных (cache hits) теперь стоят $0,028, промахи мимо кэша (cache misses) — $0,28, а выходные данные — $0,42.
Для сравнения: по прежним тарифам V3.1-Terminus эти показатели составляли $0,07, $0,56 и $1,68 соответственно.
DeepSeek временно сохранила доступность Terminus через отдельный API до 15 октября, чтобы разработчики могли напрямую сравнить две модели, но после этой даты Terminus будет выведен из эксплуатации — это была недолговечная модель, выпущенная всего неделю назад.
Тем не менее, DeepSeek V3.2-Exp выглядит одним из самых дешевых вариантов для разработчиков при использовании API, хотя лавры самой доступной модели по-прежнему легко удерживает GPT-5 Nano от OpenAI. Ниже вы можете сравнить ее с другими ведущими моделями:
|
Провайдер |
Модель (дешевая/начальная) |
Цена за вход (за 1 млн токенов) |
Цена за выход (за 1 млн токенов) |
Примечания / оговорки |
|
V3.2-Exp |
$0,28 / $0,028 (кэшированный ввод) |
$0,42 |
||
|
GPT-5 Nano |
$0,05 / $0,005 (кэшированный ввод) |
$0,40 |
||
|
Gemini 2.5 Flash-Lite |
$0,10 |
$0,40 |
Цена для кэшированного ввода недоступна |
|
|
Claude Haiku 3.5 |
$0,80 / $0,08 (кэшированный ввод) |
$4,00 |
||
|
Grok-4 Fast Non-Reasoning |
$0,20 / $0,05 (кэшированный ввод) |
$0,50 |
Новый дизайн разреженного внимания (Sparse Attention)
В основе V3.2-Exp лежит технология DeepSeek Sparse Attention (DSA), описанная в техническом отчете, который компания также опубликовала сегодня на GitHub.
Традиционные механизмы плотного внимания (dense attention), которые вычисляют взаимодействие между каждым токеном и всеми остальными токенами в последовательности, масштабируются квадратично относительно длины последовательности. По мере роста числа токенов это приводит к стремительному увеличению объема используемой памяти и требований к вычислительным ресурсам, что влечет за собой высокие затраты и медленный инференс.
Большинство больших языковых моделей используют механизм «плотного» самовнимания, который сопоставляет каждый токен во входных данных с каждым другим токеном. Таким образом, если длина вашего промпта удваивается, модель выполняет более чем в два раза больше работы для обработки всех этих межтокеновых взаимодействий. Это увеличивает время работы GPU и затраты энергии, что отражается на ценообразовании API за миллион токенов. На этапе префиллинга (предварительного заполнения) объем вычислений растет примерно пропорционально квадрату длины контекста, а на этапе декодирования — по меньшей мере линейно. В результате более длинные последовательности (десятки тысяч или даже более 100 000 токенов) приводят к тому, что затраты растут гораздо быстрее, чем можно было бы предположить только по количеству токенов.
DSA решает эту проблему с помощью «индексатора молний» (lightning indexer), который выбирает только наиболее релевантные токены для внимания.
Это снижает вычислительную нагрузку при сохранении практически прежнего качества ответов.
За счет уменьшения вычислительной нагрузки на один токен при большой длине контекста V3.2-Exp делает кривую затрат более пологой и значительно более низкой.
Это делает гораздо более практичным и доступным выполнение рабочих нагрузок с длинным контекстом, таких как суммирование документов большого объема, многошаговый чат с длинной историей или анализ кода, избавляя от неконтролируемого роста затрат на инференс.
Достижения в области посткаобучения и обучения с подкреплением
Помимо архитектурных изменений, DeepSeek-V3.2-Exp представляет усовершенствования в процессе посткаобучения. Компания использует двухэтапный подход: дистилляцию специализированных моделей и обучение с подкреплением.
Дистилляция специалистов начинается с обучения отдельных моделей для математики, спортивного программирования, логических рассуждений, агентского написания кода (agentic coding) и агентского поиска. Эти специализированные модели, дообученные на основе одной и той же базовой контрольной точки (checkpoint), подкрепляются крупномасштабным обучением для генерации данных под конкретные домены. Затем эти данные дистиллируются обратно в финальную контрольную точку, гарантируя, что консолидированная модель извлекает выгоду из специализированных знаний, оставаясь при этом универсальной.
Фаза обучения с подкреплением знаменует собой значительный сдвиг. Вместо многоэтапного подхода, использовавшегося в предыдущих моделях DeepSeek, обучение рассуждениям, агентам и выравниванию под предпочтения человека (human alignment) объединено в единый этап RL с использованием метода Group Relative Policy Optimization (GRPO). Этот унифицированный процесс сбалансированно повышает производительность в различных доменах, позволяя избежать проблем «катастрофического забывания», которые часто сопутствуют многоэтапным пайплайнам.
Дизайн системы вознаграждения объединяет сигналы результатов на основе правил, штрафы за длину и проверки языковой согласованности с генеративной моделью вознаграждения, руководствующейся критериями для конкретных задач. Экспериментальные результаты показывают, что дистиллированная и обученная с подкреплением модель работает практически наравне со специализированными доменными аналогами, причем разрыв фактически стирается после RL-обучения.
Стабильные результаты бенчмарков
Бенчмарки подтверждают, что компромисс работает должным образом. В широко используемых публичных тестах V3.2-Exp демонстрирует производительность на уровне V3.1-Terminus, показывая незначительные различия в таких областях, как рассуждения, программирование и ответы на вопросы.
Хотя показатели немного снизились в некоторых задачах, требующих интенсивных рассуждений, таких как GPQA-Diamond и Humanity’s Last Exam, прирост эффективности модели и стабильная производительность в других аспектах говорят о том, что подход разреженного внимания не наносит существенного ущерба ее возможностям.
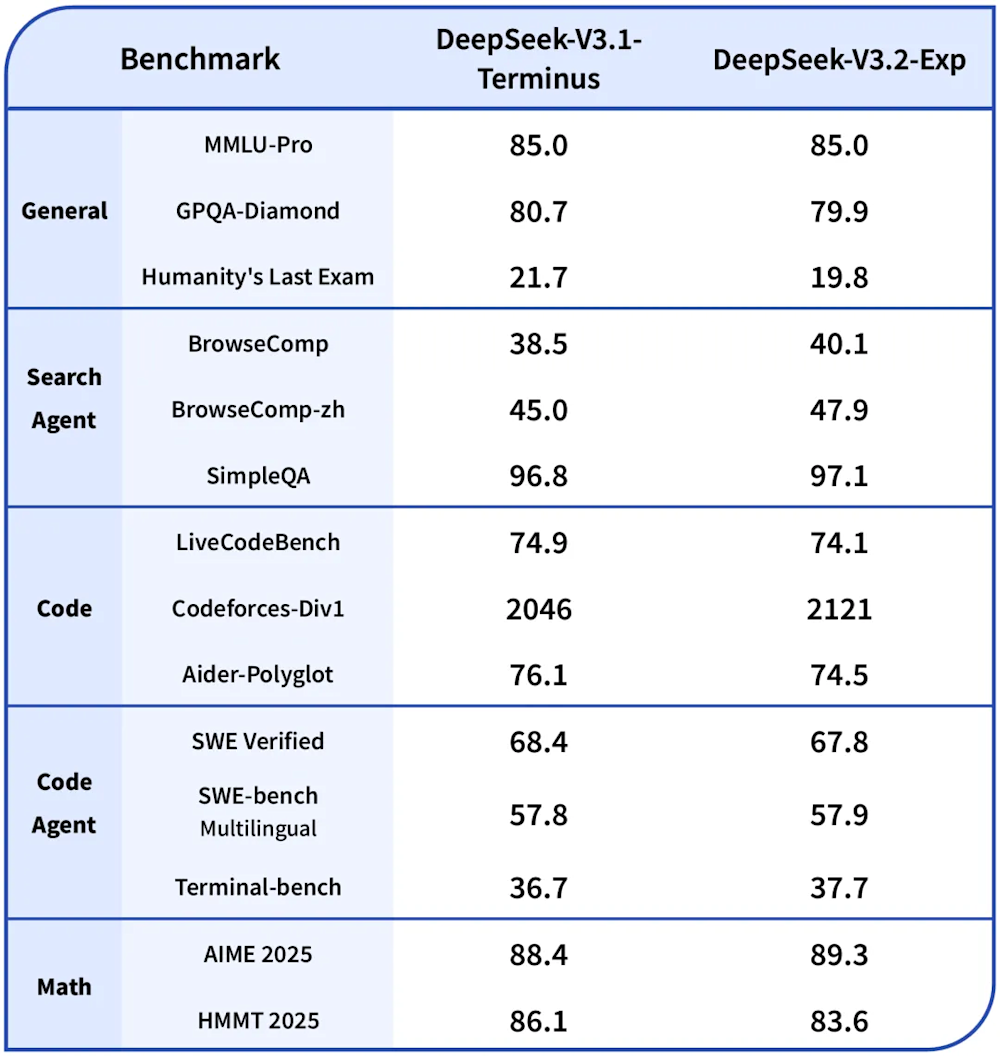
График бенчмарков DeepSeek V3.2-Exp. Источник: DeepSeek
MMLU-Pro держится на стабильном уровне 85,0, результаты в AIME 2025 немного улучшились до 89,3, в то время как в GPQA-Diamond показатель снизился с 80,7 до 79,9. Бенчмарки по программированию и агентским задачам демонстрируют аналогичную картину: рейтинг на Codeforces вырос с 2046 до 2121, а показатель BrowseComp улучшился с 38,5 до 40,1.
Этот баланс отражает заложенный в проект компромисс. Выбирая для внимания лишь часть возможных токенов, DSA существенно снижает вычислительные затраты. Сравнение стоимости инференса показывает, что V3.2-Exp при работе с длинным контекстом требует менее половины стоимости за миллион токенов по сравнению с V3.1-Terminus.
Открытый исходный код и варианты развертывания
В рамках приверженности компании принципам открытости DeepSeek опубликовала веса модели V3.2-Exp на Hugging Face под лицензией MIT. Исследователи и предприятия могут свободно загружать, модифицировать и развертывать модель для коммерческого использования.
Релиз сопровождается ядрами с открытым исходным кодом: TileLang для исследовательского прототипирования и ядрами CUDA/FlashMLA для высокопроизводительного инференса. Команда LMSYS Org, стоящая за созданием SGLang, также объявила, что ее фреймворк теперь официально поддерживает V3.2 с оптимизированными ядрами разреженного внимания, динамическим кэшированием ключей-значений и масштабированием до 128 000 токенов. vLLM также обеспечивает поддержку с первого дня.
Для локального развертывания DeepSeek предоставила обновленный демо-код, а также образы Docker, совместимые с ускорителями NVIDIA H200, AMD MI350 и NPU. Модель, насчитывающая 685 миллиардов параметров, поддерживает множество типов тензоров, включая BF16, FP8 и FP32.
Предыстория: итеративный путь DeepSeek
Запуск V3.2-Exp состоялся всего через неделю после того, как DeepSeek выпустила V3.1-Terminus — доработанную версию своей модели V3.1. Модель Terminus была разработана с учетом отзывов пользователей: в ней улучшены рассуждения с использованием инструментов и снижено количество ошибок смешивания языков (например, вставки китайских слов в ответы на английском языке).
Согласно отчету VentureBeat, Terminus опирается на семейство моделей V3, представленное в декабре 2024 года, которое позиционировало решения DeepSeek как универсальные и экономичные альтернативы серии R1, ориентированной на более сложные рассуждения. Хотя R1 превосходно справляется со структурированной логикой, математикой и многошаговыми рассуждениями, эта модель работает медленнее и стоит дороже. Модели V3, напротив, созданы для общего применения, такого как написание текстов, суммирование, клиентские чаты и базовое программирование.
С выходом V3.2-Exp компания DeepSeek внедряет архитектурные инновации посредством разреженного внимания, сохраняя при этом лицензию MIT и модель выпуска с открытым исходным кодом.
Факторы для принятия решений на уровне руководства предприятий
Для предприятий — особенно в США — экономия средств, предлагаемая API DeepSeek, выглядит весьма привлекательно, однако перед внедрением следует учесть дополнительные факторы.
-
Безопасность и соответствие данных требованиям регуляторов: Использование размещенного API DeepSeek означает, что данные проходят через серверы компании, базирующейся в Гонконге. Предприятиям с конфиденциальными данными клиентов, работающим в регулируемых отраслях или имеющим строгие нормативные рамки (например, в здравоохранении, финансах, оборонной сфере), потребуется тщательно оценить юридические последствия и вопросы управления. Самостоятельное размещение весов с открытым исходным кодом может снизить эти риски, однако в таком случае инфраструктура и обязанности по обслуживанию ложатся на плечи самой компании.
-
Производительность против контроля: API обеспечивает немедленный доступ с прогнозируемыми затратами и масштабированием. Самостоятельное развертывание дает максимальный контроль — особенно в отношении локализации данных и задержек (latency), — но требует значительных инженерных ресурсов и наличия GPU. Лицам, принимающим решения, необходимо сопоставить скорость внедрения с операционными накладными расходами.
-
Диверсификация поставщиков: Поскольку многие американские компании уже зависят от OpenAI, Anthropic или Google, подход DeepSeek с открытым исходным кодом служит страховкой от зависимости от одного вендора (vendor lock-in). Тем не менее, интеграция моделей от китайского провайдера может вызвать вопросы у советов директоров или специалистов по безопасности.
-
Совокупная стоимость владения (TCO): Хотя API дешевле в расчете на один токен, предприятия с постоянными высокоинтенсивными нагрузками могут добиться долгосрочной экономии, запуская модель с открытым исходным кодом на собственной инфраструктуре или через доверенных сторонних хостинг-провайдеров. Тем не менее, судя по архитектуре модели, даже те, кто запускает новый DeepSeek V3.2-Exp, должны увидеть значительно более низкие затраты на обработку длинных входных последовательностей на собственных серверах и оборудовании. Выбор сводится к масштабу, предсказуемости рабочей нагрузки и готовности к внутренним операционным затратам.
Для американских руководителей, оценивающих DeepSeek, расчет строится не только на ценах API — речь идет о сопоставлении доступности с толерантностью к рискам, регуляторными требованиями и инфраструктурной стратегией.
Что ждет DeepSeek в будущем?
DeepSeek-V3.2-Exp демонстрирует, как игрок с открытым исходным кодом может развивать передовые модели масштаба frontier, одновременно решая практические проблемы стоимости и развертывания.
Внедрив разреженный механизм внимания, снизив цены на API, объединив обучение с подкреплением в единый этап и сохранив полную прозрачность благодаря релизам на Hugging Face и GitHub, DeepSeek предлагает как экспериментальную исследовательскую площадку, так и жизнеспособный вариант для корпоративного сектора.
Появление таких фреймворков, как SGLang и vLLM, в официальной экосистеме релиза подчеркивает, что DeepSeek развивает широкую интеграцию с сообществом, а не замыкает дистрибуцию на себе.
В то же время экспериментальный характер V3.2-Exp оставляет пространство для итераций. Внутренние оценки показывают многообещающие результаты, но DeepSeek признает, что активно тестирует архитектуру в реальных сценариях для выявления возможных ограничений.
Станет ли эта экспериментальная архитектура фундаментом для более широкого релиза V3.3 или V4, покажет время. Но уже сейчас запуск V3.2-Exp свидетельствует о решимости DeepSeek оставаться заметным и конкурентоспособным игроком на глобальном ландшафте ИИ.




